<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">
  <author>
    <name>Xiaofeng Shi</name>
  </author>
  <generator uri="https://hexo.io/">Hexo</generator>
  <id>https://xiaofengshi.com/</id>
  <link href="https://xiaofengshi.com/" rel="alternate"/>
  <link href="https://xiaofengshi.com/atom.xml" rel="self"/>
  <rights>All rights reserved 2026, Xiaofeng Shi</rights>
  <subtitle>Domain AI, post-training, and multimodal systems</subtitle>
  <title>Xiaofeng Shi</title>
  <updated>2024-02-01T12:07:18.000Z</updated>
  <entry>
    <author>
      <name>Xiaofeng Shi</name>
    </author>
    <category term="LLM" scheme="https://xiaofengshi.com/tags/LLM/"/>
    <category term="prompt" scheme="https://xiaofengshi.com/tags/prompt/"/>
    <content>
      <![CDATA[<h2 id="1-什么是PromptEngineering"><a href="#1-什么是PromptEngineering" class="headerlink" title="1. 什么是PromptEngineering"></a>1. 什么是PromptEngineering</h2><p>所谓prompt工程，就是让LLM模型清晰准确的知道你要干什么，引导模型充分的发掘它的能力上限，类比到人与人之间，就是提升沟通的效率。OpenAI提出了prompt工程的6条原则[1]，在这篇文档里，按照个人的理解，将这部分按照适用场景分成用户和开发者两个部分，一共6条（与openai的6条顺序有所不同）：</p><p>用户策略：</p><ul><li>Write clear instructions（写出清晰的指令）</li><li>Provide reference text（提供参考文本）</li><li>Give the model time to “think”（给模型时间“思考”）</li></ul><p>开发者策略：</p><ul><li>Split complex tasks into simpler subtasks（将复杂的任务拆分为更简单的子任务）</li><li>Use external tools（使用外部工具）</li><li>Test changes systematically（系统地测试变更）</li></ul><p>这几个原则概括了一个好的prompt应该是什么样子的。实际应用中，prompt工程能否有效，很大程度上依赖LLM的指令追随能力，要不然就变成 了，对着聋子打鼓–充耳不闻，说了也白说……</p><span id="more"></span><h2 id="2-理论派"><a href="#2-理论派" class="headerlink" title="2. 理论派"></a>2. 理论派</h2><p>详细说一下这6条原则各自包含的内容。</p><h3 id="2-1-清晰的指令"><a href="#2-1-清晰的指令" class="headerlink" title="2.1 清晰的指令"></a>2.1 清晰的指令</h3><p>这是最重要的一个原则，包括下面6条内容：</p><ul><li><p>把话说详细，在查询中包含详细信息以获得更相关的答案（不要让模型猜，详细且准确的表述出你的需求），举例如下：</p><ul><li><p>bad：如何在Excel中添加数字？ </p></li><li><p>good：如何在Excel中添加一行花费金额？我想自动为整张表的行执行此操作，所有总计都在右侧名为“总计”的列中结束</p></li></ul></li><li><p>让模型充当某个角色（角色和要回答的问题要适配，例如数学老师和装修，这种不搭配的角色会带来更差的结果），这是一个广为人知的策略，从生成的角度来说，模型预设某个角色，模型会更容易使用该领域的知识，有助于问题的解决。在同一个生成参数下，使用34B模型进行生成。</p><ul><li><p>测试1： </p><ul><li>Q：你是一个专业，聪明，经验丰富的<strong>数学老师</strong>。100+180&#x3D;？ </li><li>A：答案是280。</li></ul></li><li><p>测试2： </p><ul><li><p>Q：你是一个专业，聪明，经验丰富的<strong>汽车司机</strong>。100+180&#x3D;？ </p></li><li><p>A：答案是200。</p></li></ul></li></ul></li><li><p>使用分隔符清楚地指示输入的不同部分。这样可以让模型准确的知道什么地方是什么内容，举例如下：</p><ul><li>Q &#x3D;下面用户将为你提供三重引号的文本(‘’’文本内容’’’)。用一个带有’摘要：’前缀的一句话总结这段文本。</li></ul></li><li><p>指定完成任务所需的步骤（优化COT，让模型逐步生成，任务如果可以拆分，那最好进行拆分成更简单的单步任务），这是一个被广泛应用的策略，个人一直认为Agent目前的实现思路，本质上就是这个策略的深挖。</p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">使用以下分步说明响应用户输入。  </span><br><span class="line">第1步-用户将为您提供三重引号的文本。用一个带有“摘要：”前缀的句子总结这段文本。 </span><br><span class="line">第2步-将第1步中的摘要翻译成西班牙语，前缀为“翻译：”</span><br></pre></td></tr></table></figure></li><li><p>提供例子， oneshot 或者 fewshot</p><ul><li>Q&#x3D;按照下面的给出的示例风格来写’冬天’的文章：’落霞与孤鹜齐飞</li></ul></li><li><p>指定所输出长度（在中文场景中，尽量使用 一句话，两个段落 这种说法，而不要使用100个字这种表述，这种只能给出个大概，模型无法准确的生成），举例如下</p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">使用一句话总结下面给出的文本内容。</span><br><span class="line">“文本插入这里”</span><br></pre></td></tr></table></figure></li></ul><h3 id="2-2-提供参考上下文"><a href="#2-2-提供参考上下文" class="headerlink" title="2.2 提供参考上下文"></a>2.2 提供参考上下文</h3><ul><li><p>模型使用参考文本来回答。</p><p>例如RAG方案，或手动提供外部文档进行回答，这样会减少模型的幻觉，与此同时，对模型的文本检索能力提出了要求。</p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">使用提供的由三重引号引起来的文章来回答问题。如果在文章中找不到答案，请写“我找不到答案”。 </span><br><span class="line">&quot;&quot;&quot;&lt;在此插入文档&gt;&quot;&quot;&quot; </span><br><span class="line">&quot;&quot;&quot;&lt;在此插入文档&gt;&quot;&quot;&quot; </span><br><span class="line">问题：&lt;在此插入问题&gt; </span><br><span class="line">回答： </span><br></pre></td></tr></table></figure></li><li><p>生成引文的格式</p><p>要求模型通过引用所提供文档中的段落来为其答案添加引用。可以提高正确性，增加可验证性，并能够减少幻觉。</p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">你将得到一份由三重引号和一个问题分隔的文件。你的任务是只用提供的文件回答问题，并引用用于回答问题的文件的段落。如果文件不包含回答这个问题所需的信息，那么只需写：“信息不足”。如果提供了问题的答案，则必须用引文注释。使用以下格式引用相关段落（&#123;“引文”&#125;)</span><br><span class="line">&quot;&quot;&quot;&lt;在此处插入文档&gt;&quot;&quot;&quot;</span><br><span class="line">问题：&lt;在此处插入问题&gt;</span><br></pre></td></tr></table></figure></li></ul><h3 id="2-3-让模型思考-think-step-by-step"><a href="#2-3-让模型思考-think-step-by-step" class="headerlink" title="2.3 让模型思考(think step by step)"></a>2.3 让模型思考(think step by step)</h3><p>这是一个经常被提到的策略，是从COT的角度提出的优化策略，逐步推导，给出答案。</p><ul><li><p>与其直接让模型判断，不如让模型得出结论之前找出自己的解决方案</p><p>比如扔个数学题给大模型，直接让LLM判断对错与否，会发现结果很随机。但是如果先让LLM自己做一遍，再去判断对与不对，结果就会提升 非常多了。</p><p>假如是一个判断学生回答的题目是否正确的场景，prompt可以这样设计：</p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br></pre></td><td class="code"><pre><span class="line">PROMPT=&#x27;&#x27;&#x27;首先找出你自己的解决方案。然后将你的解决方案与学生的解决方案进行比较，评估学生的解决方案是否正确。在你自己做这道题之前，不要决定学生的解决方案是否正确。</span><br><span class="line">问题陈述：我正在建造一个太阳能装置，我需要帮助解决财务问题。</span><br><span class="line">-土地成本100美元/平方英尺</span><br><span class="line">-我可以以250美元/平方英尺的价格购买太阳能电池板</span><br><span class="line">-我协商了一份维护合同，每年将花费我10万美元，另外10美元/平方英尺</span><br><span class="line">作为平方英尺数的函数，第一年运营的总成本是多少。</span><br><span class="line"></span><br><span class="line">学生解：设x为装置的大小，单位为平方英尺。</span><br><span class="line">1.土地成本：100倍</span><br><span class="line">2.太阳能电池板成本：250x</span><br><span class="line">3、维护成本：10万+100x</span><br><span class="line">总成本：100x+250x+100,000+100x=450x+100,000</span><br><span class="line">&#x27;&#x27;&#x27;</span><br><span class="line"></span><br><span class="line">ASSISTANT（GPT4）=&#x27;&#x27;&#x27;我的解：设装置的面积为y平方英尺。</span><br><span class="line">1. 土地成本：100y </span><br><span class="line">2. 太阳能电池板成本：250y</span><br><span class="line">3. 维护成本：100,000+10y</span><br><span class="line">总成本 = 100y + 250y + 100,000 + 10y = 360y + 100,000</span><br><span class="line"></span><br><span class="line">比较学生的解与我的解，发现学生在计算维护成本时，将每平方英尺的费用误写为100美元，实际上应该是10美元，所以学生的解答存在错误。&#x27;&#x27;&#x27;</span><br></pre></td></tr></table></figure></li></ul><blockquote><p>在gpt3.5和aquila34b上使用该prompt进行测试 ，基本以失败告终，gpt4可以成功生成</p></blockquote><ul><li><p>使用内心独白或一系列查询来隐藏模型的推理过程（教育场景？）</p><p>模型在回答特定问题之前，详细推理问题有时很重要。对于某些场景，模型用来得出最终答案的推理过程不适合与用户共享。例如，在教育辅导相关的场景中，我们可能希望鼓励学生自己找出答案，但是模型关于学生解决方案的推理过程可能会向学生揭示答案，所以这种情况下，模型的推导过程要对用户隐藏。</p><p>内心独白是一种可以用来缓解这种情况的策略。内心独白的想法是：指示模型将应对用户隐藏的部分输出放入结构化的特定格式中，这可以是这部分的解析变得容易。然后在将输出呈现给用户之前，只有一部分输出是可见的，对用户隐藏的部分对外不可见。比如下面的查询，告诉模型如何逐步完成这次查询</p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line">PROMPT=&#x27;&#x27;&#x27;</span><br><span class="line">按照以下步骤回答用户查询。</span><br><span class="line"></span><br><span class="line">第一步-首先找出你自己的解决方案。不要依赖学生的解决方案，因为它可能是不正确的。将这一步的所有工作都用三重引号括起来 (&quot;&quot;&quot;).</span><br><span class="line"></span><br><span class="line">第2步-将您的解决方案与学生的解决方案进行比较，并评估学生的解决方案是否正确。将此步骤的所有工作用三重引号括起来 (&quot;&quot;&quot;).</span><br><span class="line"></span><br><span class="line">第3步-如果学生犯了错误，确定你可以在不泄露答案的情况下给学生什么提示。将这一步的所有工作用三重引号括起来 (&quot;&quot;&quot;).</span><br><span class="line"></span><br><span class="line">第4步-如果学生犯了错误，请向学生提供上一步的提示（三重引号之外）。而不是写“步骤4-…”写“提示：”。</span><br><span class="line"></span><br><span class="line">问题陈述：&lt;插入问题陈述&gt;</span><br><span class="line"></span><br><span class="line">学生解决方案：&lt;插入学生解决方案&gt;&#x27;&#x27;&#x27;</span><br></pre></td></tr></table></figure><p>当然也可以将上面的四步拆分成4个调用来完成，前面几次对用户隐藏让用户无法感知，这两个具体哪个表现更好，直觉上分成四次调用可能更准确[<a href="https://platform.openai.com/docs/guides/prompt-engineering/tactic-use-inner-monologue-or-a-sequence-of-queries-to-hide-the-model-s-reasoning-process">7]</a></p></li><li><p>询问模型在之前的过程中是否遗漏了任何内容（多轮对话后续追问）</p><p>长文本问答中常用。比如我们给了一个文档，要让大模型模型来列出与一个特定问题相关的信息。如果源文档很大，模型通常会过早停止或者无法列出所有相关信息。在这种情况下，通过使用后续的prompt让模型查找之前错过的任何相关信息，通常可以获得更好的性能。例如下面这种查询场景</p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br></pre></td><td class="code"><pre><span class="line">SYSTEM=&#x27;&#x27;&#x27;您将获得一份由三重引号分隔的文档。您的任务是选择与以下问题相关的摘录：“人工智能历史上发生了哪些重大范式转变。”</span><br><span class="line"></span><br><span class="line">确保摘录包含解释它们所需的所有相关上下文——换句话说，不要提取缺少重要上下文的小片段。提供JSON格式的输出，如下所示：</span><br><span class="line"></span><br><span class="line">[&#123;“摘录”：“……”&#125;，</span><br><span class="line">…</span><br><span class="line">&#123;“摘录”：“……”&#125;]</span><br><span class="line">&#x27;&#x27;&#x27;</span><br><span class="line">USER=&quot;&quot;&quot;&lt;insert document here&gt;&quot;&quot;&quot;</span><br><span class="line"></span><br><span class="line">ASST=&quot;&quot;&quot;[&#123;&quot;摘录&quot;：&quot;模型在这里写摘录&quot;&#125;，</span><br><span class="line">…</span><br><span class="line">&#123;&quot;摘录&quot;：&quot;模型在这里写另一个摘录&quot;&#125;]&quot;&quot;&quot;</span><br><span class="line"></span><br><span class="line">USER=&quot;&quot;&quot;还有更多相关的摘录吗？注意不要重复摘录。还要确保摘录包含解释它们所需的所有相关上下文——换句话说，不要摘录缺少重要上下文的小片段。</span><br><span class="line">&quot;&quot;&quot;</span><br></pre></td></tr></table></figure></li></ul><h3 id="2-4-将复杂任务拆分为更简单的子任务"><a href="#2-4-将复杂任务拆分为更简单的子任务" class="headerlink" title="2.4 将复杂任务拆分为更简单的子任务"></a>2.4 将复杂任务拆分为更简单的子任务</h3><ul><li><p>[开发者策略] 使用意图分类来识别与用户查询最相关的指令，这条策略直接说不好理解。</p><p>举个例子：在客服场景下，直接问模型“我连不上网了”模型需要从查找整个知识库，去匹配连不上网了该怎么办。将这个任务进行拆解，第一步根据用户的问题，来判断这个问题对应的是预先设定好的哪个类别的服务</p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br></pre></td><td class="code"><pre><span class="line">SYSTEM=&#x27;&#x27;&#x27;您将获得客户服务查询。将每个查询分类为主要类别和次要类别。以json格式提供带有键的输出：主要和次要。</span><br><span class="line"></span><br><span class="line">主要类别：计费、技术支持、账户管理或一般查询。</span><br><span class="line"></span><br><span class="line">计费二级类别：</span><br><span class="line">-取消订阅或升级</span><br><span class="line"></span><br><span class="line">技术支持二级类别：</span><br><span class="line">-故障排除</span><br><span class="line"></span><br><span class="line">账户管理二级类别：</span><br><span class="line">-密码重置</span><br><span class="line"></span><br><span class="line">一般查询二级类别：</span><br><span class="line">-产品信息</span><br><span class="line">-和人类说话&#x27;&#x27;&#x27;</span><br><span class="line"></span><br><span class="line">USER=&#x27;&#x27;&#x27;我连不上网络怎么办&#x27;&#x27;&#x27;</span><br></pre></td></tr></table></figure><p>这一步会对输入的问题进行意图判断，假设认为用户要找”技术支持&#x2F;故障排除”，接下来根据第一步得到的结果找到该类别下的内容，将该内容作为上下文，用来回答用户的问题。</p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><span class="line">SYSTEM=&#x27;&#x27;&#x27;您将获得需要在技术支持上下文中进行故障排除的客户服务查询。通过以下方式帮助用户：</span><br><span class="line"></span><br><span class="line">-请他们检查所有进出路由器的电缆是否已连接。请注意，随着时间的推移，电缆松动是很常见的。</span><br><span class="line">-如果所有电缆都已连接并且问题仍然存在，请询问他们使用的路由器型号</span><br><span class="line">-现在您将建议他们如何重新启动设备：</span><br><span class="line">--如果型号是MTD-327J，建议他们按下红色按钮并按住5秒钟，然后等待5分钟再测试连接。</span><br><span class="line">-如果客户的问题在重新启动设备并等待5分钟后仍然存在，请通过输出&#123;“请求IT支持”&#125;将他们连接到IT支持。</span><br><span class="line">-如果用户开始问与此主题无关的问题，请确认他们是否愿意结束当前关于故障排除的聊天并根据以下方案对他们的请求进行分类：</span><br><span class="line"></span><br><span class="line">&lt;技术支持/故障排除&gt;&#x27;&#x27;&#x27;</span><br><span class="line"></span><br><span class="line">USER=我连不上网络怎么办</span><br></pre></td></tr></table></figure><p>通过将任务拆解，可以有效提升准确率并减少上下文的长度。</p></li><li><p>[开发者策略] 长文本对话，总结或者过滤之前的对话或者使用RAG方案</p><p>因为模型具有固定的上下文长度，因此用户和助手之间的对话无法无限期地继续，一般的解决办法是：</p><ul><li><p>总结对话中的历史记录。一旦输入的大小达到预定的阈值长度，这可能会触发总结部分对话的查询，并且先前对话的摘要可以作为系统消息的一部分包括在内；</p></li><li><p>或者，可以在整个对话过程中在后台异步总结之前的对话；</p></li><li><p>或者，把过去的所有聊天记录存成向量库，后续跟用户对话的时候动态查询embedding[5]，这里设计要如何进行特征压缩和信息嵌入；</p></li></ul></li><li><p>[开发者策略] 分段总结长文档并递归构建完整摘要</p><p>让大模型总结一本书，肯定是超Token上限了，所以可以使用一系列查询来总结文档的每个部分。章节摘要可以连接和总结，生成摘要的摘要。这个过程可以递归地进行，直到总结整个文档。openai对实现方案进行了详细的阐述[6]。</p><blockquote><p>Our model works by first summarizing small sections of a book, then summarizing those summaries into a higher-level summary, and so on.</p></blockquote></li></ul><h3 id="2-5-使用外部工具"><a href="#2-5-使用外部工具" class="headerlink" title="2.5 使用外部工具"></a>2.5 使用外部工具</h3><p>对于一些数学，查天气之类的问题，外部的工具可以获得稳定且正确的结果。LLM擅长的是逻辑推理，擅长写公式或者function但是并不是擅长具体执行。那最优的办法是，让LLM来告知该怎么做，拿到代码或者执行语句之后使用专业的软件去执行，只让大模型做一个答案组装的工作就够了。</p><ul><li>RAG技术的使用，将信息检索的工作外放给专门的向量模型来执行（不在这里赘述）</li><li>使用代码执行来进行更准确的计算或调用外部API</li><li>[开发者策略]给模型提供特定的功能[9]</li></ul><h3 id="2-6-开发者策略-系统的测试变更-10"><a href="#2-6-开发者策略-系统的测试变更-10" class="headerlink" title="2.6 [开发者策略]系统的测试变更[10]"></a>2.6 [开发者策略]系统的测试变更[10]</h3><p>一条新指令或一个新设计是让你的系统变得更好还是更坏。看几个例子可能会暗示哪个更好，但在样本量较小的情况下，很难区分真正的改进还是随机的运气。也许这种变化有助于某些输入的性能，但会损害其他输入的性能[10]。那么如何评估呢？</p><h2 id="3-实践派"><a href="#3-实践派" class="headerlink" title="3. 实践派"></a>3. 实践派</h2><h3 id="3-1-生成引文格式"><a href="#3-1-生成引文格式" class="headerlink" title="3.1 生成引文格式"></a>3.1 生成引文格式</h3><p>在基于RAG的请求中，让模型能够数据出带引文编号的格式。这个考验的是prompt编写能力和模型的指令追随能力，此外为了提升模型的生产准确性，会使用fewshot。在论文[2]中给出了好用的prompt模板。</p><ul><li><strong>Instruction</strong> <strong>for</strong> <strong>VANILLA.</strong></li></ul><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">Instruction: Write an accurate, engaging, and concise answer for the given question using only the provided search results (some of which might be irrelevant) and cite them properly. Use an unbiased and journalistic tone. Always cite for any factual claim. When citing several search results, use [1][2][3]. Cite at least one document and at most three documents in each sentence. If multiple documents support the sentence, only cite a minimum sufficient subset of the documents.</span><br></pre></td></tr></table></figure><ul><li><strong>Short instruction</strong> <strong>for</strong> <strong>VANILLA.</strong></li></ul><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">Instruction: Write a high-quality answer for the given question using only the provided search results and cite them properly using [1][2][3].</span><br></pre></td></tr></table></figure><ul><li><p>在<strong>VANILLA</strong>基础上扩展出中文模板</p><p>在下面的模板中可以看到，坚定的贯穿了理论中的各种prompt策略：准确的表达，给出例子。</p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br></pre></td><td class="code"><pre><span class="line">你是一个专业，聪明的汽车助手。使用提供的参考内容（其中一些可能无关，参考内容在两个&#x27;===&#x27;之间）编写用户给定问题的准确、简洁的答案，并确保正确引用。要使用无偏见的新闻语气。对任何事实主张都应提供引用。在引用多个搜索结果时，使用[1][2][3]。在每个句子中，至少引用1个文档，最多引用3个文档。如果多个文档支持这个句子，只引用最少的足够的文档子集。如果连续的句子都引用同一个文档，那么只在最后1个句子处引用文档。如果所有的参考内容都与给定的问题不相关，那么不依赖参考内容进行回答。</span><br><span class="line"></span><br><span class="line">按照下面给出的两个例子进行生成</span><br><span class="line"></span><br><span class="line">示例1开始</span><br><span class="line">参考内容如下：</span><br><span class="line">===</span><br><span class="line">参考内容[0] (标题:提示信息；摘要:排放控制系统因发动机型号不同会有差异。；作者:无)：排放控制系统因发动机型号不同会有差异，具体配备请以实车为准。禁止对发动机或排放控制系统的任何部件进行改装。</span><br><span class="line">参考内容[1] (标题:无；摘要:涡轮增压和自然吸气发动机的动力表现差异，以及昂科威和自由光在外观和尺寸上的差异。；作者:无)：涡轮PK自吸 有人觉得带“T”的发动机动力表现够强劲，再加上不大的排气量也能保证较低的油耗；又有人觉得涡轮增压发动机或多或少会在低转速时遇到动力迟滞，不如自然吸气发动机来的平顺。</span><br><span class="line">===</span><br><span class="line">参考内容全部结束。</span><br><span class="line"></span><br><span class="line">用户给定的问题：排放控制系统是否会因为发动机型号不同而有差异？各有什么优势?</span><br><span class="line">回答：排放控制系统会因发动机型号不同而有差异[0]。例如，涡轮增压发动机动力表现强劲，排气量小可以保证较低的油耗；但可能在低转速时遇到动力迟滞。相比之下，自然吸气发动机运行更平顺[1]。具体的设备配置需要以实车为准[0]。另外，对发动机或排放控制系统的任何部件进行改装是被禁止的[0]。</span><br><span class="line">示例1结束</span><br><span class="line"></span><br><span class="line">示例2开始</span><br><span class="line">参考内容如下：</span><br><span class="line">===</span><br><span class="line">参考内容[0] (标题:提示信息；摘要:排放控制系统因发动机型号不同会有差异。；作者:无)：排放控制系统因发动机型号不同会有差异，具体配备请以实车为准。禁止对发动机或排放控制系统的任何部件进行改装。</span><br><span class="line">参考内容[1] (标题:无；摘要:涡轮增压和自然吸气发动机的动力表现差异。；作者:无)：涡轮PK自吸 有人觉得带“T”的发动机动力表现够强劲，再加上不大的排气量也能保证较低的油耗；又有人觉得涡轮增压发动机或多或少会在低转速时遇到动力迟滞</span><br><span class="line">===</span><br><span class="line">参考内容全部结束。</span><br><span class="line"></span><br><span class="line">燃油车有什么优势</span><br><span class="line">回答：燃油车可能的优势包括更广泛的加油站网络、更长的驾驶距离（在需要加油/充电前）和更短的“加油”时间。然而，具体的优势可能取决于特定的车型和驾驶条件。</span><br><span class="line">示例2结束</span><br><span class="line"></span><br><span class="line">参考内容如下：</span><br><span class="line">===</span><br><span class="line">&#123;refers&#125;</span><br><span class="line">===</span><br><span class="line">参考内容全部结束。</span><br><span class="line"></span><br><span class="line">用户给定的问题：&#123;question&#125;</span><br><span class="line">回答：</span><br><span class="line">&quot;&quot;&quot;</span><br></pre></td></tr></table></figure></li></ul><h3 id="3-2-使用LLM来作为evaluator"><a href="#3-2-使用LLM来作为evaluator" class="headerlink" title="3.2 使用LLM来作为evaluator"></a>3.2 使用LLM来作为evaluator</h3><p>在很多场景下会使用GPT模型作为evaluator，来对比来对于同一个问题的两个回答AB的优劣，在这种AB对比的场景下，为了消除位置偏见，在[3]给出了一个模板，用来解决这种情况。对于一条数据，会进行两个验证，分别是A在前和B在前，使用GPT模型对A,B进行两次打分，取两次打分的均值。prompt的设计可以参考下面代码。</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">def</span> <span class="title function_">gen_prompt</span>(<span class="params">ques, ans1, ans2</span>):</span><br><span class="line">    sys_prompt = <span class="string">&#x27;You are a helpful and precise assistant for checking the quality of the answer.&#x27;</span></span><br><span class="line">    prompt_template = <span class="string">&quot;[Question]\n&#123;question&#125;\n\n[The Start of Assistant 1&#x27;s Answer]\n&#123;answer_1&#125;\n[The End of Assistant 1&#x27;s Answer]\n\n[The Start of Assistant 2&#x27;s Answer]\n&#123;answer_2&#125;\n[The End of Assistant 2&#x27;s Answer]\n\n[System]\n&#123;prompt&#125;\n&quot;</span></span><br><span class="line">    default_prompt =  <span class="string">&quot;&quot;&quot;We would like to request your feedback on the performance of two AI assistants in response to the user question displayed above.</span></span><br><span class="line"><span class="string">    Please rate the helpfulness, relevance, accuracy, level of details of their responses. </span></span><br><span class="line"><span class="string"></span></span><br><span class="line"><span class="string">    Each assistant receives an overall score on a scale of 1 to 10, where a higher score indicates better overall performance.</span></span><br><span class="line"><span class="string">    Please first provide a comprehensive explanation of your evaluation, avoiding any potential bias and ensuring that the order in which the responses were presented does not affect your judgment. </span></span><br><span class="line"><span class="string">    Then, output two lines indicating the scores for Assistant 1 and 2, respectively.</span></span><br><span class="line"><span class="string"></span></span><br><span class="line"><span class="string">    Output with the following format:</span></span><br><span class="line"><span class="string">    Evaluation evidence: &lt;your evluation explanation here&gt;</span></span><br><span class="line"><span class="string">    Score of the Assistant 1: &lt;score&gt;</span></span><br><span class="line"><span class="string">    Score of the Assistant 2: &lt;score&gt;&quot;&quot;&quot;</span></span><br><span class="line">    <span class="keyword">return</span> sys_prompt, prompt_template.<span class="built_in">format</span>(question=ques, answer_1=ans1, answer_2=ans2, prompt=default_prompt)</span><br></pre></td></tr></table></figure><p>这个模板可以扩展成只包含一个答案的评估，代码如下所示</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">def</span> <span class="title function_">gen_prompt</span>(<span class="params">ques, ans1</span>):</span><br><span class="line">    sys_prompt = <span class="string">&quot;You are a helpful and precise assistant for checking the quality of the answer.&quot;</span></span><br><span class="line">    prompt_template = <span class="string">&quot;[Question]\n&#123;question&#125;\n\n[The Start of Assistant  Answer]\n&#123;answer_1&#125;\n[The End of Assistant  Answer]\n\n[System]\n&#123;prompt&#125;\n&quot;</span></span><br><span class="line"></span><br><span class="line">    default_prompt = <span class="string">&quot;&quot;&quot;We would like to request your feedback on the performance of two AI assistants in response to the user question displayed above.</span></span><br><span class="line"><span class="string">    Please rate the helpfulness, relevance, accuracy, level of details of their responses.</span></span><br><span class="line"><span class="string"></span></span><br><span class="line"><span class="string">    The assistant receives an overall score on a scale of 1 to 10, where a higher score indicates better overall performance.</span></span><br><span class="line"><span class="string">    Please first provide a comprehensive explanation of your evaluation, avoiding any potential bias and ensuring that the order in which the responses were presented does not affect your judgment.</span></span><br><span class="line"><span class="string">    Then, output one line indicating the score for Assistant&#x27;s response.</span></span><br><span class="line"><span class="string"></span></span><br><span class="line"><span class="string">    Output with the following format:</span></span><br><span class="line"><span class="string">    Evaluation evidence: </span></span><br><span class="line"><span class="string">    Score of the Assistant : &quot;&quot;&quot;</span></span><br><span class="line">    <span class="keyword">return</span> sys_prompt, prompt_template.<span class="built_in">format</span>(</span><br><span class="line">        question=ques, answer_1=ans1, prompt=default_prompt</span><br><span class="line">    )</span><br></pre></td></tr></table></figure><h3 id="3-3-query改写"><a href="#3-3-query改写" class="headerlink" title="3.3 query改写"></a>3.3 query改写</h3><p>这个任务比较简单，要标明改写的用于，例如是用来做搜索，还是用来做主题生成。列举一个rag-fusion中来进行query扩充的prompt</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br></pre></td><td class="code"><pre><span class="line">rag_fusion_query_rewrite_prompt = <span class="string">&quot;&quot;&quot;你是一个聪明的智能助手，可以根据单个输入查询语句生成多个与它相关的搜索查询语句。下面根据用户的问题生成3个用于查询的相关问题。要求逐行显示。</span></span><br><span class="line"><span class="string"></span></span><br><span class="line"><span class="string">约定生成的回答格式为：</span></span><br><span class="line"><span class="string">1. answer1</span></span><br><span class="line"><span class="string">2. answer2</span></span><br><span class="line"><span class="string">...</span></span><br><span class="line"><span class="string">N. answerN</span></span><br><span class="line"><span class="string"></span></span><br><span class="line"><span class="string">用户的问题为:&#123;question&#125;</span></span><br><span class="line"><span class="string">生成回答:</span></span><br><span class="line"><span class="string">&quot;&quot;&quot;</span></span><br><span class="line"></span><br><span class="line"><span class="comment">## from https://github.com/Raudaschl/rag-fusion/blob/master/main.py#L16</span></span><br><span class="line">rag_fusion_prompt_en=<span class="string">&quot;&quot;&quot;You are a helpful assistant that generates multiple search queries based on a single input query.</span></span><br><span class="line"><span class="string"></span></span><br><span class="line"><span class="string">Generate multiple search queries related to: &#123;question&#125;</span></span><br><span class="line"><span class="string">OUTPUT (4 querys):</span></span><br><span class="line"><span class="string">&quot;&quot;&quot;</span></span><br></pre></td></tr></table></figure><h3 id="3-4-…"><a href="#3-4-…" class="headerlink" title="3.4 …"></a>3.4 …</h3><h2 id="参考文献"><a href="#参考文献" class="headerlink" title="参考文献"></a>参考文献</h2><ol><li>OpenAI PromptEngineering：<a href="https://platform.openai.com/docs/guides/prompt-engineering">https://platform.openai.com/docs/guides/prompt-engineering</a></li><li>OpenAI的官方Prompt工程指南详解<a href="https://mp.weixin.qq.com/s/jOU2qT5o88tuZC1p6vLkJw">https://mp.weixin.qq.com/s/jOU2qT5o88tuZC1p6vLkJw</a></li><li>ALCE: <a href="https://arxiv.org/pdf/2305.14627.pdf">https://arxiv.org/pdf/2305.14627.pdf</a> </li><li>FairEval：<a href="https://github.com/i-Eval/FairEval">https://github.com/i-Eval/FairEval</a></li><li><a href="https://platform.openai.com/docs/guides/prompt-engineering/tactic-use-embeddings-based-search-to-implement-efficient-knowledge-retrieval">https://platform.openai.com/docs/guides/prompt-engineering/tactic-use-embeddings-based-search-to-implement-efficient-knowledge-retrieval</a></li><li><a href="https://openai.com/research/summarizing-books">https://openai.com/research/summarizing-books</a></li><li><a href="https://platform.openai.com/docs/guides/prompt-engineering/tactic-use-inner-monologue-or-a-sequence-of-queries-to-hide-the-model-s-reasoning-process">https://platform.openai.com/docs/guides/prompt-engineering/tactic-use-inner-monologue-or-a-sequence-of-queries-to-hide-the-model-s-reasoning-process</a></li><li><a href="https://www.promptingguide.ai/zh/techniques">https://www.promptingguide.ai/zh/techniques</a></li><li><a href="https://cookbook.openai.com/examples/how_to_call_functions_with_chat_models">https://cookbook.openai.com/examples/how_to_call_functions_with_chat_models</a></li><li><a href="https://platform.openai.com/docs/guides/prompt-engineering/strategy-test-changes-systematically">https://platform.openai.com/docs/guides/prompt-engineering/strategy-test-changes-systematically</a></li><li></li></ol>]]>
    </content>
    <id>https://xiaofengshi.com/2024/02/01/Survey-PromptEngineering/</id>
    <link href="https://xiaofengshi.com/2024/02/01/Survey-PromptEngineering/"/>
    <published>2024-02-01T11:06:39.000Z</published>
    <summary>
      <![CDATA[<h2 id="1-什么是PromptEngineering"><a href="#1-什么是PromptEngineering" class="headerlink" title="1. 什么是PromptEngineering"></a>1. 什么是PromptEngineering</h2><p>所谓prompt工程，就是让LLM模型清晰准确的知道你要干什么，引导模型充分的发掘它的能力上限，类比到人与人之间，就是提升沟通的效率。OpenAI提出了prompt工程的6条原则[1]，在这篇文档里，按照个人的理解，将这部分按照适用场景分成用户和开发者两个部分，一共6条（与openai的6条顺序有所不同）：</p>
<p>用户策略：</p>
<ul>
<li>Write clear instructions（写出清晰的指令）</li>
<li>Provide reference text（提供参考文本）</li>
<li>Give the model time to “think”（给模型时间“思考”）</li>
</ul>
<p>开发者策略：</p>
<ul>
<li>Split complex tasks into simpler subtasks（将复杂的任务拆分为更简单的子任务）</li>
<li>Use external tools（使用外部工具）</li>
<li>Test changes systematically（系统地测试变更）</li>
</ul>
<p>这几个原则概括了一个好的prompt应该是什么样子的。实际应用中，prompt工程能否有效，很大程度上依赖LLM的指令追随能力，要不然就变成 了，对着聋子打鼓–充耳不闻，说了也白说……</p>]]>
    </summary>
    <title>[Survey]PromptEngineering</title>
    <updated>2024-02-01T12:07:18.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Xiaofeng Shi</name>
    </author>
    <category term="LM" scheme="https://xiaofengshi.com/tags/LM/"/>
    <category term="KV-CACHE" scheme="https://xiaofengshi.com/tags/KV-CACHE/"/>
    <content>
      <![CDATA[<p>论文地址：<a href="https://arxiv.org/pdf/2309.17453.pdf">https://arxiv.org/pdf/2309.17453.pdf</a></p><p>代码地址：<a href="https://github.com/mit-han-lab/streaming-llm">https://github.com/mit-han-lab/streaming-llm</a></p><p>在LLM的训练和推理过程中，transformer的kv-cache一直是个非常头痛的问题，因为attention的计算机制，kv-cache是与输入的tokes数量呈平方关系的，在decoder结构中，第N步的forward都要计算前面的所有的N-1步的所有token，随着文本长度的增加，这会带来非常大的计算和存储开销。</p><p>在保证模型效果的条件小减少kv缓存是一个非常值得研究的事情。从下面徒可以看到，模型结合了window-attention和slide windiw的优势，有非常好的表现。</p><img src="/2024/02/01/%E8%AE%BA%E6%96%87%E9%98%85%E8%AF%BB-streaming-llm-%E8%A7%A3%E5%86%B3%E9%95%BF%E6%96%87%E6%9C%AC%E7%9A%84kv-cache%E9%97%AE%E9%A2%98/streaming-llm.png" class="" title="streaming-llm"><span id="more"></span><h2 id="如何实现"><a href="#如何实现" class="headerlink" title="如何实现"></a>如何实现</h2><h2 id="表现如何"><a href="#表现如何" class="headerlink" title="表现如何"></a>表现如何</h2><h2 id="有何启发"><a href="#有何启发" class="headerlink" title="有何启发"></a>有何启发</h2><h2 id="参考"><a href="#参考" class="headerlink" title="参考"></a>参考</h2>]]>
    </content>
    <id>https://xiaofengshi.com/2024/02/01/%E8%AE%BA%E6%96%87%E9%98%85%E8%AF%BB-streaming-llm-%E8%A7%A3%E5%86%B3%E9%95%BF%E6%96%87%E6%9C%AC%E7%9A%84kv-cache%E9%97%AE%E9%A2%98/</id>
    <link href="https://xiaofengshi.com/2024/02/01/%E8%AE%BA%E6%96%87%E9%98%85%E8%AF%BB-streaming-llm-%E8%A7%A3%E5%86%B3%E9%95%BF%E6%96%87%E6%9C%AC%E7%9A%84kv-cache%E9%97%AE%E9%A2%98/"/>
    <published>2024-02-01T10:27:05.000Z</published>
    <summary>
      <![CDATA[<p>论文地址：<a href="https://arxiv.org/pdf/2309.17453.pdf">https://arxiv.org/pdf/2309.17453.pdf</a></p>
<p>代码地址：<a href="https://github.com/mit-han-lab/streaming-llm">https://github.com/mit-han-lab/streaming-llm</a></p>
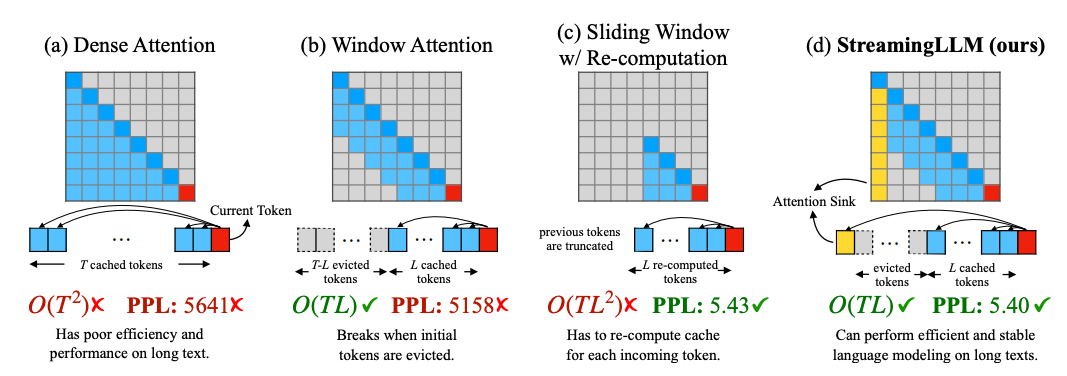
<p>在LLM的训练和推理过程中，transformer的kv-cache一直是个非常头痛的问题，因为attention的计算机制，kv-cache是与输入的tokes数量呈平方关系的，在decoder结构中，第N步的forward都要计算前面的所有的N-1步的所有token，随着文本长度的增加，这会带来非常大的计算和存储开销。</p>
<p>在保证模型效果的条件小减少kv缓存是一个非常值得研究的事情。从下面徒可以看到，模型结合了window-attention和slide windiw的优势，有非常好的表现。</p>
<img src="/2024/02/01/%E8%AE%BA%E6%96%87%E9%98%85%E8%AF%BB-streaming-llm-%E8%A7%A3%E5%86%B3%E9%95%BF%E6%96%87%E6%9C%AC%E7%9A%84kv-cache%E9%97%AE%E9%A2%98/streaming-llm.png" class="" title="streaming-llm">]]>
    </summary>
    <title>[论文阅读]streaming-llm:解决长文本的kv-cache问题</title>
    <updated>2024-02-01T10:38:04.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Xiaofeng Shi</name>
    </author>
    <category term="LLM" scheme="https://xiaofengshi.com/tags/LLM/"/>
    <category term="压缩" scheme="https://xiaofengshi.com/tags/%E5%8E%8B%E7%BC%A9/"/>
    <content>
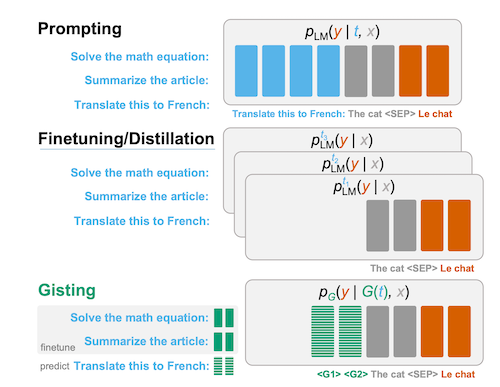
      <![CDATA[<p>论文链接：<a href="https://arxiv.org/pdf/2304.08467v1.pdf">https://arxiv.org/pdf/2304.08467v1.pdf</a></p><p>压缩instruction部分的token长度</p><img src="/2024/01/31/%E8%AE%BA%E6%96%87%E9%98%85%E8%AF%BB-Gist-token-%E5%B0%86instruction%E5%8E%8B%E7%BC%A9%E5%88%B0%E8%99%9A%E6%8B%9Ftoken/gisting.png" class="" title="gisting"><span id="more"></span><h2 id="主要做什么事情"><a href="#主要做什么事情" class="headerlink" title="主要做什么事情"></a>主要做什么事情</h2><p>LLM的指令微调数据输入的格式是（instruction,query,answer）格式，分别使用t,x,y指代，在这种格式下目前的训练策略 </p><ul><li>prompting-finetune（大模型目前主流方式） <ul><li>将instruction和query拼在一起，来自回归的学习answer，学习的是<code>P(y|t,x)</code> </li><li>优点是：可以做到多任务的学习 </li><li>缺点是：要学习prompt，如果prompt较长，这部分会占据模型的输入token长度，是冗余的</li></ul></li><li>Finetuning&#x2F;Distillation（之前小模型的路子） <ul><li>每个t设置一个任务，很多单任务模型，学习的是<code>P(y,x)</code> </li><li>优点是 不需要学习prompt</li></ul></li><li>新提出的Gisting <ul><li>上面两种的tradeoff，引入gist-token将prompt压缩，缩短prompt的长度（可以压缩到到1个token上 ），学习的是<code>P(y|g(t),x)</code> </li><li>泛化性：在seen上可以与prompt持平，在unseen上有25%左右胜率；</li></ul></li></ul><h2 id="做法"><a href="#做法" class="headerlink" title="做法"></a>做法</h2><ul><li><p>prompt的学习方式 </p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">Q: Translate French: The cat. </span><br><span class="line">A: Le Chat </span><br></pre></td></tr></table></figure></li><li><p>gist的输入方式： </p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">Q: Translate French: G1, G2,...Gn The cat. </span><br><span class="line">A: Le Chat </span><br></pre></td></tr></table></figure></li></ul><p>此外，x部分无法看到Gist之前的token，也就是说上面的例子上’The’只能向左看见到G1，再前面部分看不到。 </p><p>这样可以实现的目的：由于x看不到原始的instruction，只能看到Gist token，那么就强制让模型将原始的instruction信息压缩到Gist token中，要不然x无法生成指定的y。 </p><p>使用mask来实现，就是将gist之前的token mask掉 </p><h2 id="关键结论和效果"><a href="#关键结论和效果" class="headerlink" title="关键结论和效果"></a>关键结论和效果</h2><ul><li>平均instruction token数为26的数据集上测试，模型对gist-token数量多少不敏感，1个gist-token并没有造成过多的损失，过多的token对性能有损，这意味着26倍的压缩率</li></ul><Models were generally insensitive to the number of gist tokensk: compressing prompts into a single token did not substantially underperform more gist tokens.><ul><li><p>泛化性 </p><ul><li>gist token的表现介于阳性对照模型和阴性对照模型之间（没理解这俩对照模型啥意思） </li><li>llama的结构好于t5结构</li></ul></li><li><p>什么时候 gist 模型与对照组持平 </p><ul><li>对于已见过任务（但是未见过的输入），gist 模型几乎有一半的时间与对照组不相上下。 </li><li>对于未见过的任务，这一数字下降到了 20-25%。 </li><li>对于 OOD Human 任务，这一数字又下降到 10%</li></ul></li></ul><h2 id="启发和应用"><a href="#启发和应用" class="headerlink" title="启发和应用"></a>启发和应用</h2><ul><li>prompt比较短的时候，论文中的26，拿到的收益并不大，并且unseen差攻下会指标下降 </li><li>在垂类场景下，如果prompt相对固定或者比较长，这种方案是否可行？例如在nl2sql的场景下，如果查询范围相对固定，就是有数的几个表，prompt固定且长，压缩到n个gist-token中，这几个 token专门用来存prompt的信息</li></ul><h2 id="参考"><a href="#参考" class="headerlink" title="参考"></a>参考</h2><ul><li><p><a href="https://mp.weixin.qq.com/s/Tbs-9GewJD18CmNQKXR1pw">https://mp.weixin.qq.com/s/Tbs-9GewJD18CmNQKXR1pw</a></p></li><li><p><a href="https://zhuanlan.zhihu.com/p/627644504%3E">https://zhuanlan.zhihu.com/p/627644504&gt;</a></p></li></ul>]]>
    </content>
    <id>https://xiaofengshi.com/2024/01/31/%E8%AE%BA%E6%96%87%E9%98%85%E8%AF%BB-Gist-token-%E5%B0%86instruction%E5%8E%8B%E7%BC%A9%E5%88%B0%E8%99%9A%E6%8B%9Ftoken/</id>
    <link href="https://xiaofengshi.com/2024/01/31/%E8%AE%BA%E6%96%87%E9%98%85%E8%AF%BB-Gist-token-%E5%B0%86instruction%E5%8E%8B%E7%BC%A9%E5%88%B0%E8%99%9A%E6%8B%9Ftoken/"/>
    <published>2024-01-31T23:12:32.000Z</published>
    <summary>
      <![CDATA[<p>论文链接：<a href="https://arxiv.org/pdf/2304.08467v1.pdf">https://arxiv.org/pdf/2304.08467v1.pdf</a></p>
<p>压缩instruction部分的token长度</p>
<img src="/2024/01/31/%E8%AE%BA%E6%96%87%E9%98%85%E8%AF%BB-Gist-token-%E5%B0%86instruction%E5%8E%8B%E7%BC%A9%E5%88%B0%E8%99%9A%E6%8B%9Ftoken/gisting.png" class="" title="gisting">]]>
    </summary>
    <title>[论文阅读]Gist-token:将instruction压缩到虚拟token</title>
    <updated>2024-02-01T10:34:04.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Xiaofeng Shi</name>
    </author>
    <category term="AIGC" scheme="https://xiaofengshi.com/categories/AIGC/"/>
    <category term="AIGC" scheme="https://xiaofengshi.com/tags/AIGC/"/>
    <content>
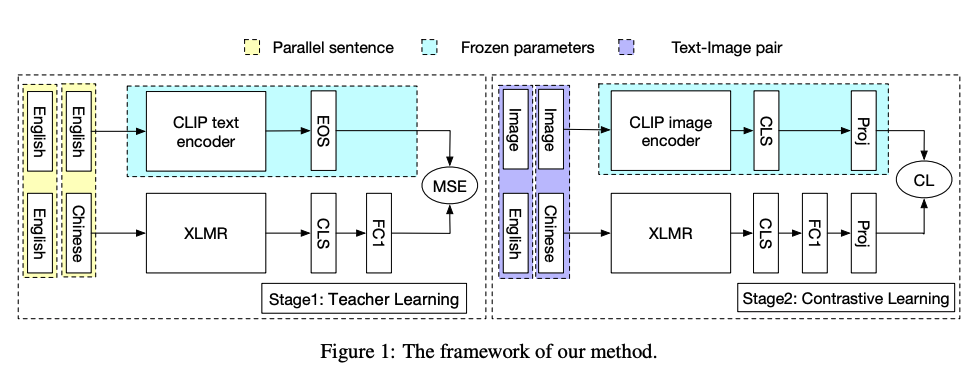
      <![CDATA[<h2 id="ALTCLIP"><a href="#ALTCLIP" class="headerlink" title="ALTCLIP"></a>ALTCLIP</h2><ul><li><p>目的：多语言版本多模态文本模型，主要想得到 text encoder，image encoder固定</p></li><li><p>论文：<a href="https://arxiv.org/abs/2211.06679">https://arxiv.org/abs/2211.06679</a></p></li><li><p>做法：</p><img src="/2023/03/30/AIGC/ALTCLIP.png" class="" title="image-20230330140536968"><ul><li>两阶段训练<ul><li>阶段1：<ul><li>目的：XLMR在保持多语言能力的同时，从CLIP中获取两种语言的文本-图像对齐能力</li><li>teacher：权重固定的 clip text encoder</li><li>student：Facebook的多语言NLP模型XLMR</li><li>数据：语言平行语料</li><li>任务设计：xlmr和clip_text_encoder的mse</li></ul></li><li>阶段2：<ul><li>目的：对比学习，微调模型，进一步提升图文对齐能力</li><li>teacher：权重固定的clip image encoder</li><li>student：一阶段训练之后的XLMR</li><li>数据：图文对数据</li><li>任务设计：图文对比学习</li></ul></li></ul></li></ul></li></ul><h2 id="latent-diffusion"><a href="#latent-diffusion" class="headerlink" title="latent diffusion"></a>latent diffusion</h2><ul><li><p>论文地址：<a href="https://arxiv.org/abs/2112.10752">https://arxiv.org/abs/2112.10752</a></p></li><li><p>代码地址：<a href="https://github.com/CompVis/latent-diffusion">https://github.com/CompVis/latent-diffusion</a></p></li><li><p>博客文章：</p><ul><li><a href="https://zhuanlan.zhihu.com/p/563543020">https://zhuanlan.zhihu.com/p/563543020</a> </li><li><a href="https://zhuanlan.zhihu.com/p/582693939">https://zhuanlan.zhihu.com/p/582693939</a></li></ul></li><li><p>训练方式：两阶段</p><ul><li>阶段1：训练autoencoder</li><li>阶段2：训练LMD</li></ul><h2 id="stable-diffusion"><a href="#stable-diffusion" class="headerlink" title="stable diffusion"></a>stable diffusion</h2></li></ul>]]>
    </content>
    <id>https://xiaofengshi.com/2023/03/30/AIGC/</id>
    <link href="https://xiaofengshi.com/2023/03/30/AIGC/"/>
    <published>2023-03-30T13:40:32.000Z</published>
    <summary>
      <![CDATA[<h2 id="ALTCLIP"><a href="#ALTCLIP" class="headerlink" title="ALTCLIP"></a>ALTCLIP</h2><ul>
<li><p>目的：多语言版本多模态文本模型，主要想得到 text encoder，image]]>
    </summary>
    <title>AIGB</title>
    <updated>2024-01-31T23:32:56.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Xiaofeng Shi</name>
    </author>
    <category term="深度学习" scheme="https://xiaofengshi.com/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    <category term="多模态" scheme="https://xiaofengshi.com/tags/%E5%A4%9A%E6%A8%A1%E6%80%81/"/>
    <content>
      <![CDATA[<p>本篇主要总结一下当前视觉模型的发展，算是一个论文汇总，主要包含: EVA,PAINTER,VIT22B,MAE,SWIN-T等模型</p><span id="more"></span><p>默认对Vit已经有所了解了。</p><h2 id="EVA"><a href="#EVA" class="headerlink" title="EVA"></a>EVA</h2><ul><li>论文地址：<a href="https://arxiv.org/abs/2211.07636">https://arxiv.org/abs/2211.07636</a></li><li>关键词：简单，高效，无需图文对数据</li><li>想干什么：训练一个视觉大模型</li><li>怎么干：结合了视觉模型的两个路子，Beit的MIM任务和模型蒸馏<ul><li>MIM：可以看做最强的视觉低纬度特征学习，可以在具有弱语义和运动任务重表现出色<ul><li><a href="https://baijiahao.baidu.com/s?id=1734333972141495878&wfr=spider&for=pc">https://baijiahao.baidu.com/s?id=1734333972141495878&amp;wfr=spider&amp;for=pc</a></li></ul></li><li>模型蒸馏<ul><li><a href="https://arxiv.org/pdf/2205.14141v3.pdf">https://arxiv.org/pdf/2205.14141v3.pdf</a> <a href="https://zhuanlan.zhihu.com/p/563288232">https://zhuanlan.zhihu.com/p/563288232</a></li><li>可以使student模型在不经过teacher模型复杂任务的前提下获得优异的性能。</li><li>teacher一般选择clip模型</li></ul></li></ul></li><li>EVA怎么训练<ul><li>模型结构：一个足够深的VIT模型，VIT-G，参数量 1B</li><li>任务设计：MIM</li><li>拟合目标：CLIP模型视觉编码器的对应patch的特征</li><li>Loss设计：cosine</li><li>数据量：29.6M 无标签数据，只需要图片即可</li><li>表现如何：sota</li></ul></li></ul><h2 id="MAE"><a href="#MAE" class="headerlink" title="MAE"></a>MAE</h2><ul><li>目的：获取视觉编码器</li><li>MAE怎么训练<ul><li>图片切分patch，使用75%比例进行mask</li><li>encoder只接受未mask的视觉patch</li><li>decoder的输入为encoder输出和mask位置的MASK_EMB</li><li>encoder负责进行图片编码，decoder负责mask patch的pixel 复原</li><li>任务设计：mask位置的像素复原，各patch归一化之后的mse</li></ul></li><li></li></ul>]]>
    </content>
    <id>https://xiaofengshi.com/2023/03/30/%E8%A7%86%E8%A7%89%E7%BC%96%E7%A0%81%E5%99%A8%E7%9A%84%E5%8F%91%E5%B1%95/</id>
    <link href="https://xiaofengshi.com/2023/03/30/%E8%A7%86%E8%A7%89%E7%BC%96%E7%A0%81%E5%99%A8%E7%9A%84%E5%8F%91%E5%B1%95/"/>
    <published>2023-03-30T10:55:10.000Z</published>
    <summary>
      <![CDATA[<p>本篇主要总结一下当前视觉模型的发展，算是一个论文汇总，主要包含: EVA,PAINTER,VIT22B,MAE,SWIN-T等模型</p>]]>
    </summary>
    <title>视觉编码器的发展</title>
    <updated>2023-03-30T13:40:01.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Xiaofeng Shi</name>
    </author>
    <category term="多模态" scheme="https://xiaofengshi.com/tags/%E5%A4%9A%E6%A8%A1%E6%80%81/"/>
    <content>
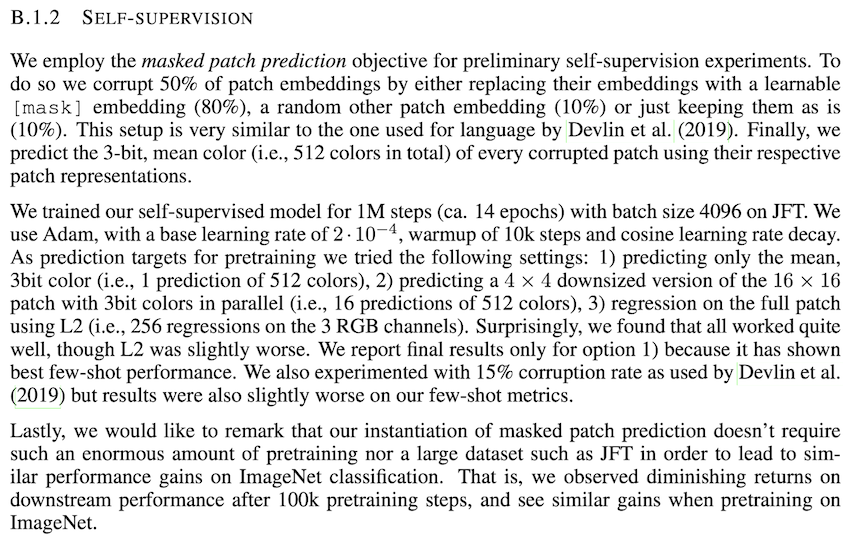
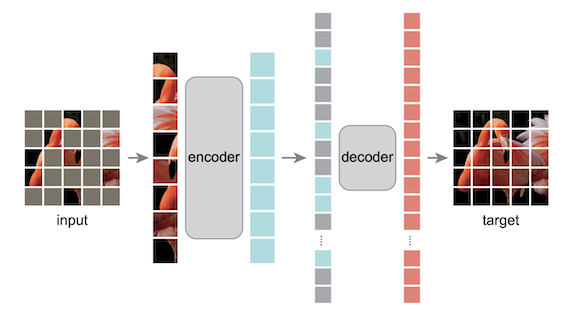
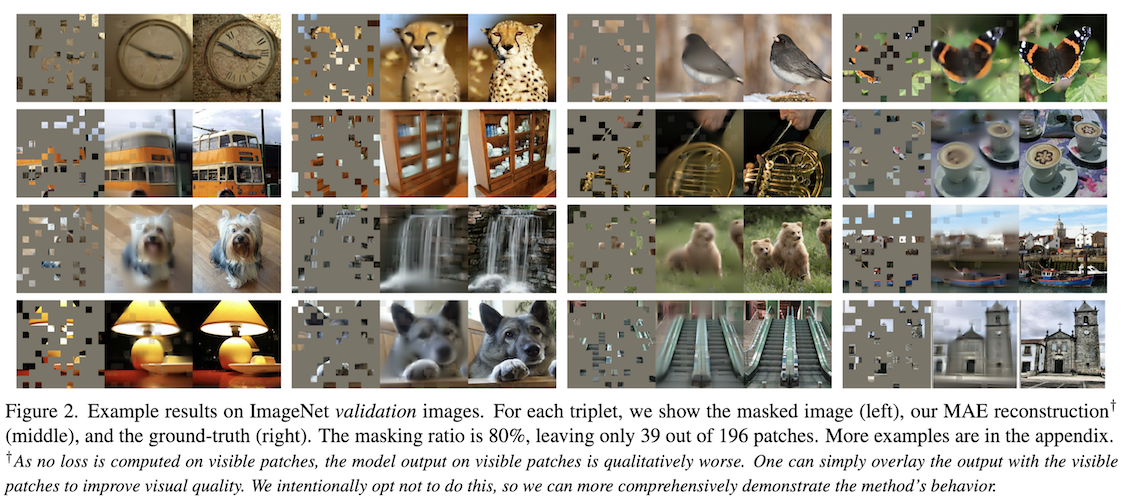
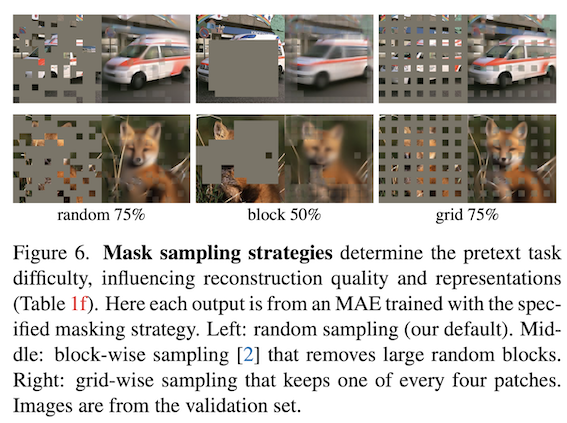
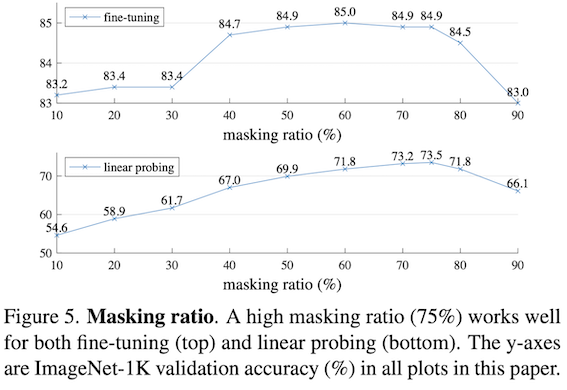
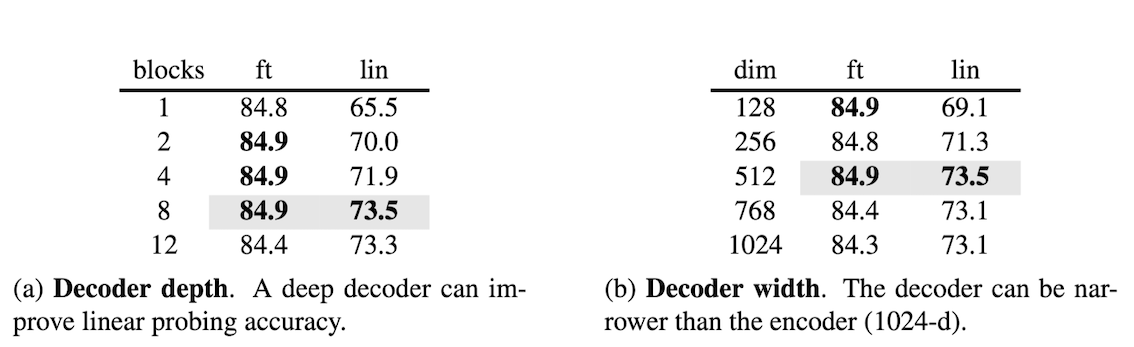
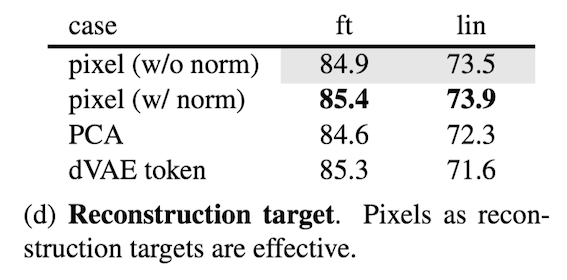
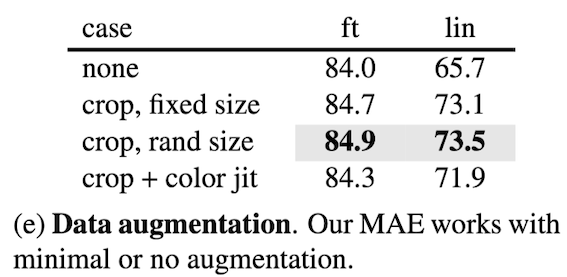
      <![CDATA[<p>恺明大神在2021年的时候发布了论文<a href="https://arxiv.org/pdf/2111.06377.pdf">MAE</a>(Masked Autoencoders Are Scalable Vision Learners)，给大家指出了如何在cv预训练任务中设计无监督任务。</p><span id="more"></span><hr><p>受知乎大佬<a href="https://www.zhihu.com/people/rumor-lee">李rumor</a>启发，重新堵了vision transformer的附录部分(之前没读过附录部分-_-||)，在VIT论文中作者探究了无监督任务的表现，但是指标不如有监督任务，所以在附录中给出来但是正文中没写。</p><img src="/2023/03/23/%E8%AE%BA%E6%96%87%E7%B2%BE%E8%AF%BB-MAE-%E5%A6%82%E4%BD%95%E5%9C%A8CV%E4%BB%BB%E5%8A%A1%E4%B8%AD%E8%BF%9B%E8%A1%8CMASK/vit_self_supervised.png" class="" title="vit_self_supervised"><p>翻译翻译这一段</p><p>首先选择50%的patch，然后在这部分patch中80%使用可学习的[mask]替代，10%使用随机其他的patch替代，10%保持不变。这部分设计和BERT的MLM的设计很像，在MLM中是选了15%的token，在这里用了50%的patch，是因为对于NLP任务，少量的mask就可以保证任务的难度，但是在CV中，信息是很冗余的，要更多的MASK比例才能保证任务的难度，让模型学习到有用的信息。任务设计主要有3种</p><ul><li>预测mask的patch的均值</li><li>预测16*16的原始patch下采样之后的4x4的patch的值</li><li>对所有patch使用L2回归计算，</li></ul><p>这三种方式第一种表现最好，第三张最差，但是还是不如有监督任务下的指标，现在回过头来看，第三个任务设计与本文的主角MAE非常相似，那么为啥当时在VIT中没能做出效果来呢？稍后分解。</p><p>在BEIT中提出了MIM任务(<strong>在后面的EVA论文中发现MIM任务并不是很有效</strong>)，使用dvae对patch进行离散化，然后使用训练好的dvae的patch特征作为mask_patch的学习target，去掉dvae部分，BEIT就跟BERT基本一模一样。在BEIT中使用的事40%的mask比例，此外在论文中尝试了复原pixel，但是效果并不好，和我之前在vlbert任务重使用MRM任务负向的表现基本一致，对于图像来说，我们需要的是图像的全局的，高维的信息，回归pixel任务会使模型过多的关注非常局部的细节，缺少了对全局的刻画(<strong>在GLIP中给出开了一种不一样的任务设计，使模型能cover图片的全局信息和局部的object信息</strong>)。</p><h2 id="使什么导致视觉和文本的mask-autoencoing不一样"><a href="#使什么导致视觉和文本的mask-autoencoing不一样" class="headerlink" title="使什么导致视觉和文本的mask autoencoing不一样"></a>使什么导致视觉和文本的mask autoencoing不一样</h2><ul><li>模型结构的问题，在传统的CNN结构中，很难将mask标记集成到卷积网络中，随着VIT的提出，这部分算是被解决了，可以很好的使用transformer来做视觉任务</li><li>信息密度的不同，在NLP中语言是高度语义化并且信息密度很高，少量的mask就可以保证任务的难度，使模型学习到有效信息，但是图片的信息是很冗余的，mask的视觉patch可以被周边的patch很好的复原，这就意味着，要对视觉patch更高比例的mask才能保证任务的难度，只有这样模型才能学习到有效信息。</li><li>decoder的设计很关键，将mask的向量进行复原在图文任务中发挥的作用不同。在视觉任务中，decoder用来重建像素值，这个任务输出的语义是显著低于常见的视觉任务的，比如图像分类任务，需要获取全局语义，而对于patch的重建语义信息显然更低维度。在NLP中decoder用来恢复mask的token，使用MLP实现，decoder没那么重要，所以在视觉任务中decoder要更精细的设计。<ul><li>在BEIT中，使用encoder，如果太关注细节就会丧失高维的语义抽象能力，所以恺明大神在encoder后面加了一个decoder，让encoder负责高维语义的抽取，让decoder负责低纬的细粒度还原，如此训练得到的encoder就能具有高维语义的能力了，这也是我们想让视觉encoder做到的。</li></ul></li></ul><img src="/2023/03/23/%E8%AE%BA%E6%96%87%E7%B2%BE%E8%AF%BB-MAE-%E5%A6%82%E4%BD%95%E5%9C%A8CV%E4%BB%BB%E5%8A%A1%E4%B8%AD%E8%BF%9B%E8%A1%8CMASK/mae_model.png" class="" title="mae_model"><hr><ul><li>PIPELINE<ul><li>encoder只处理没有进mask的patch</li><li>encoder输出的结果中插入mask的patch的embedding</li><li>encoder处理后的embedding输入到decoder中</li><li>对decoder的输出进行reshape，复原到原始图片的尺寸</li><li>计算mask的patch的和重建之后的patch的MSE Loss</li></ul></li><li>总结起来，有两个特点<ul><li>非对称的encoder decoder设计<ul><li>输入上，encoder接收没有mask的视觉patch，decoder部分接收全部的图像块</li><li>参数上，encoder使用多层堆叠的transformer，decoder使用较少层甚至一层即可</li></ul></li><li>使用较高的MASK设计，75%<ul><li>对比NLP任务的15%mask比例，在视觉任务要更高比例的mask才能保证任务的难度。</li></ul></li></ul></li></ul><img src="/2023/03/23/%E8%AE%BA%E6%96%87%E7%B2%BE%E8%AF%BB-MAE-%E5%A6%82%E4%BD%95%E5%9C%A8CV%E4%BB%BB%E5%8A%A1%E4%B8%AD%E8%BF%9B%E8%A1%8CMASK/mae_result.png" class="" title="mae_result"><p>模型的效果过于惊艳，每3列是一组，每组中最左侧是mask之后的图片，mask的比例是80%，中间是重建之后的图片，右侧是原始图片。给大佬来杯卡布奇诺。</p><h2 id="MASK策略"><a href="#MASK策略" class="headerlink" title="MASK策略"></a>MASK策略</h2><h3 id="mask的方式"><a href="#mask的方式" class="headerlink" title="mask的方式"></a>mask的方式</h3><p>mask方式对结果的影响非常重要，论文中给出了不同的mask方式得到的结果的差异</p><img src="/2023/03/23/%E8%AE%BA%E6%96%87%E7%B2%BE%E8%AF%BB-MAE-%E5%A6%82%E4%BD%95%E5%9C%A8CV%E4%BB%BB%E5%8A%A1%E4%B8%AD%E8%BF%9B%E8%A1%8CMASK/mae_mask_method.png" class="" title="mae_mask_method"><hr><p>可以看到random的时候表现最好，“block”表示mask掉大块的patch，gride是表示网格的方式mask</p><h3 id="mask的比例"><a href="#mask的比例" class="headerlink" title="mask的比例"></a>mask的比例</h3><img src="/2023/03/23/%E8%AE%BA%E6%96%87%E7%B2%BE%E8%AF%BB-MAE-%E5%A6%82%E4%BD%95%E5%9C%A8CV%E4%BB%BB%E5%8A%A1%E4%B8%AD%E8%BF%9B%E8%A1%8CMASK/mae_mask_ratio.png" class="" title="mae_mask_ratio"><p>不同的mask比例意味着不同难度的任务，从曲线中可以看出，随着mask比例的增加可以看到指标是逐渐提升的，在80%的时候指标出现下降。</p><p>在finetune任务和linear probing任务中，趋势不是很一致，在finetune任务中，mask在30%-40%的时候指标激增，然后就趋于饱和了，而在linear probing任务中几乎是线性递增的。</p><p>这是为啥呢？</p><ul><li>linear probe，仅调整模型最后的几层分类头(fix 住其它部分，如 Encoder)。因此，mask比例越高，在预训练时得到的 Encoder 就越强，但这部分在下游任务中是不能够再被训练的了，所以其性能就随着 mask 比例的增加呈线性增涨的趋势，体现的事encoder的模型能力。</li><li>finetune，继续训练 Encoder 的参数去适配下游任务，因此在 mask 比例超过一定程度后，对于下游任务的性能提升就不那么明显了，因为finetune的数据毕竟是较少的，上游的encoder不太容易提升。</li></ul><h2 id="ENCODER"><a href="#ENCODER" class="headerlink" title="ENCODER"></a>ENCODER</h2><p>在MAE中encoder只用来处理没有被mask掉的视觉patch，模型默认用的是VIT，由于unmasked的区域很少(mask的比例是75%)，encoder的计算消耗会变得很小，也就是可以训练更大的模型。</p><p>为啥encoder中要抛弃掉masked token呢？论文中给出了encoder使用masked的指标</p><img src="/2023/03/23/%E8%AE%BA%E6%96%87%E7%B2%BE%E8%AF%BB-MAE-%E5%A6%82%E4%BD%95%E5%9C%A8CV%E4%BB%BB%E5%8A%A1%E4%B8%AD%E8%BF%9B%E8%A1%8CMASK/decoder_depth_width.png" class="" title="decoder_depth_width"><p>可以看到，添加masked的token之后模型存在掉点，至于原因，这是因为上游任务和下游任务存在着gap，在下游任务中没有masked token。</p><h2 id="DECODER"><a href="#DECODER" class="headerlink" title="DECODER"></a>DECODER</h2><p>在decoder中不仅要处理encoder的输出，还要处理masked的patch特征，这部分masked的特征是怎么来的呢？这里用的是一个可学习的共享向量来表示，全部的masked-patch都用一个向量来表征，再加上masked的位置特征，这就构造了masked的特征。</p><p>DEcoder的目的是为了重建图像，因此在这里就和encoder进行了解耦，并且encoder才是后面我们想要的部分，所以decoder完全可以设计的轻量化一些，让模型更多的去学习encoder部分，如此encoder模型参数可以很多，但是输入的数据少；decoder接收的数据很多，要处理全量的token，但是模型可以设计的很轻量化，这就实现了efficient，真是牛掰。</p><p>论文中给出了decoder的深度和宽度对下游任务的影响</p><img src="/2023/03/23/%E8%AE%BA%E6%96%87%E7%B2%BE%E8%AF%BB-MAE-%E5%A6%82%E4%BD%95%E5%9C%A8CV%E4%BB%BB%E5%8A%A1%E4%B8%AD%E8%BF%9B%E8%A1%8CMASK/decoder_depth_width.png" class="" title="decoder_depth_width"><p>可以看出来，decoder的深度和宽度对linear probing有更大的影响，对于finetune的影响不太显著。</p><p>这里的原因实际上跟mask对下游任务的影响基本一致。</p><ul><li>decoder更深更宽，那么他就有更好的特征重建能力，这样encoder就能更好的专注特征的提取，也就是能得到有更好能力的encoder</li><li>在linear probing任务中，encoder是固定住的，也就是更多的体现的是encoder的能力，encoder越强，下游表现越好；</li><li>在finetune任务中，encoder是开放学习的，可以继续训练encoder参数。</li></ul><h2 id="任务目标：像素重建"><a href="#任务目标：像素重建" class="headerlink" title="任务目标：像素重建"></a>任务目标：像素重建</h2><p>MAE中的任务是对masked的patch进行像素值重建，LOSS就是简单的MSE，为什么不计算全部的patch的mse，而只计算masked的mase呢？论文中给出的结论是如果计算全部patch的mse loss会出现掉点。</p><img src="/2023/03/23/%E8%AE%BA%E6%96%87%E7%B2%BE%E8%AF%BB-MAE-%E5%A6%82%E4%BD%95%E5%9C%A8CV%E4%BB%BB%E5%8A%A1%E4%B8%AD%E8%BF%9B%E8%A1%8CMASK/loss.png" class="" title="loss"><p>对比了像素重建任务(有无归一化)，PCA的方式(对 patch 空间实施 PCA 并预测最大的因子)，BEIT类似的预测dVAE的token的方式，从指标上可以看出来，像素重建+归一化表现最好，Beit的搞法表现也不错。</p><p>为啥归一化的像素重建可行呢？</p><p>每个patch都独立统计各自的均值和方差，如此将每个patch都归一化到不同的表征空间，相比于使用全局均值和方差的归一化方式，每个patch经过归一化之后的差异性更强，有更多的高频信息，相当于将各个patch构成了边缘和纹理，从cv的角度上看，对比度更高。从而使得模型更有针对性地学习各个patch的特征模式。同时，数值上由于做了归一化，因此又不会使得模型在这方面有所偏倚。</p><p>高频性质的目标能够“迫使”特征提取器(Encoder)编码出来的各类特征更有差异性和区分性，它们之间的margin更大。</p><h2 id="数据增强"><a href="#数据增强" class="headerlink" title="数据增强"></a>数据增强</h2><p>论文中探究了数据增强对模型的影响，都是常用的老套路，剪裁，固定尺寸&#x2F;随机尺寸，颜色扰动，可以看到固定尺寸和随机尺寸对指标的影响不大，但是原色扰动会带来指标下降。</p><p>这里结合MAE的过程，在MAE中对patch进行mask，然后进行像素值预测，这里已经相当于是一种数据增强，因此不需要过分的额外数据增强就可以取得不错的效果（颜色扰动，在mask掉一些patch之后，还扰乱原来的像素值，对模型来说太难搞了）</p><img src="/2023/03/23/%E8%AE%BA%E6%96%87%E7%B2%BE%E8%AF%BB-MAE-%E5%A6%82%E4%BD%95%E5%9C%A8CV%E4%BB%BB%E5%8A%A1%E4%B8%AD%E8%BF%9B%E8%A1%8CMASK/data_aug.png" class="" title="data_aug"><h2 id="linear-probe的调整"><a href="#linear-probe的调整" class="headerlink" title="linear probe的调整"></a>linear probe的调整</h2><p>Linear probe一直是比较流行的搞法，预训练完成好，下游固定住backbone，只训练下面几层fc来适配不同的任务。它和finetune的不同是，finetune在下游开放encoder的权重，encoder部分始终保持学习。在论文中能看到Linear probe和Finetune总是会存在一些偏差，例如decoder的深度和宽度对linear probe的影响很大，但是对finetune影响不大。</p><p>在论文里面，作者将linear prob和finetune进行了融合，即“放开encoder后几层”，这种搞法在工业界算是基操了。因为只靠几层的fc是很难捕捉高层的非线性特征的。</p><h2 id="参考文献"><a href="#参考文献" class="headerlink" title="参考文献"></a>参考文献</h2><ul><li><a href="https://zhuanlan.zhihu.com/p/439554945">https://zhuanlan.zhihu.com/p/439554945</a></li><li><a href="https://www.zhihu.com/zvideo/1452458167968251904">https://www.zhihu.com/zvideo/1452458167968251904</a></li></ul>]]>
    </content>
    <id>https://xiaofengshi.com/2023/03/23/%E8%AE%BA%E6%96%87%E7%B2%BE%E8%AF%BB-MAE-%E5%A6%82%E4%BD%95%E5%9C%A8CV%E4%BB%BB%E5%8A%A1%E4%B8%AD%E8%BF%9B%E8%A1%8CMASK/</id>
    <link href="https://xiaofengshi.com/2023/03/23/%E8%AE%BA%E6%96%87%E7%B2%BE%E8%AF%BB-MAE-%E5%A6%82%E4%BD%95%E5%9C%A8CV%E4%BB%BB%E5%8A%A1%E4%B8%AD%E8%BF%9B%E8%A1%8CMASK/"/>
    <published>2023-03-23T14:11:59.000Z</published>
    <summary>
      <![CDATA[<p>恺明大神在2021年的时候发布了论文<a href="https://arxiv.org/pdf/2111.06377.pdf">MAE</a>(Masked Autoencoders Are Scalable Vision Learners)，给大家指出了如何在cv预训练任务中设计无监督任务。</p>]]>
    </summary>
    <title>[论文精读]MAE-如何在CV任务中进行MASK</title>
    <updated>2023-03-28T20:10:44.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Xiaofeng Shi</name>
    </author>
    <category term="多模态" scheme="https://xiaofengshi.com/categories/%E5%A4%9A%E6%A8%A1%E6%80%81/"/>
    <category term="多模态" scheme="https://xiaofengshi.com/tags/%E5%A4%9A%E6%A8%A1%E6%80%81/"/>
    <content>
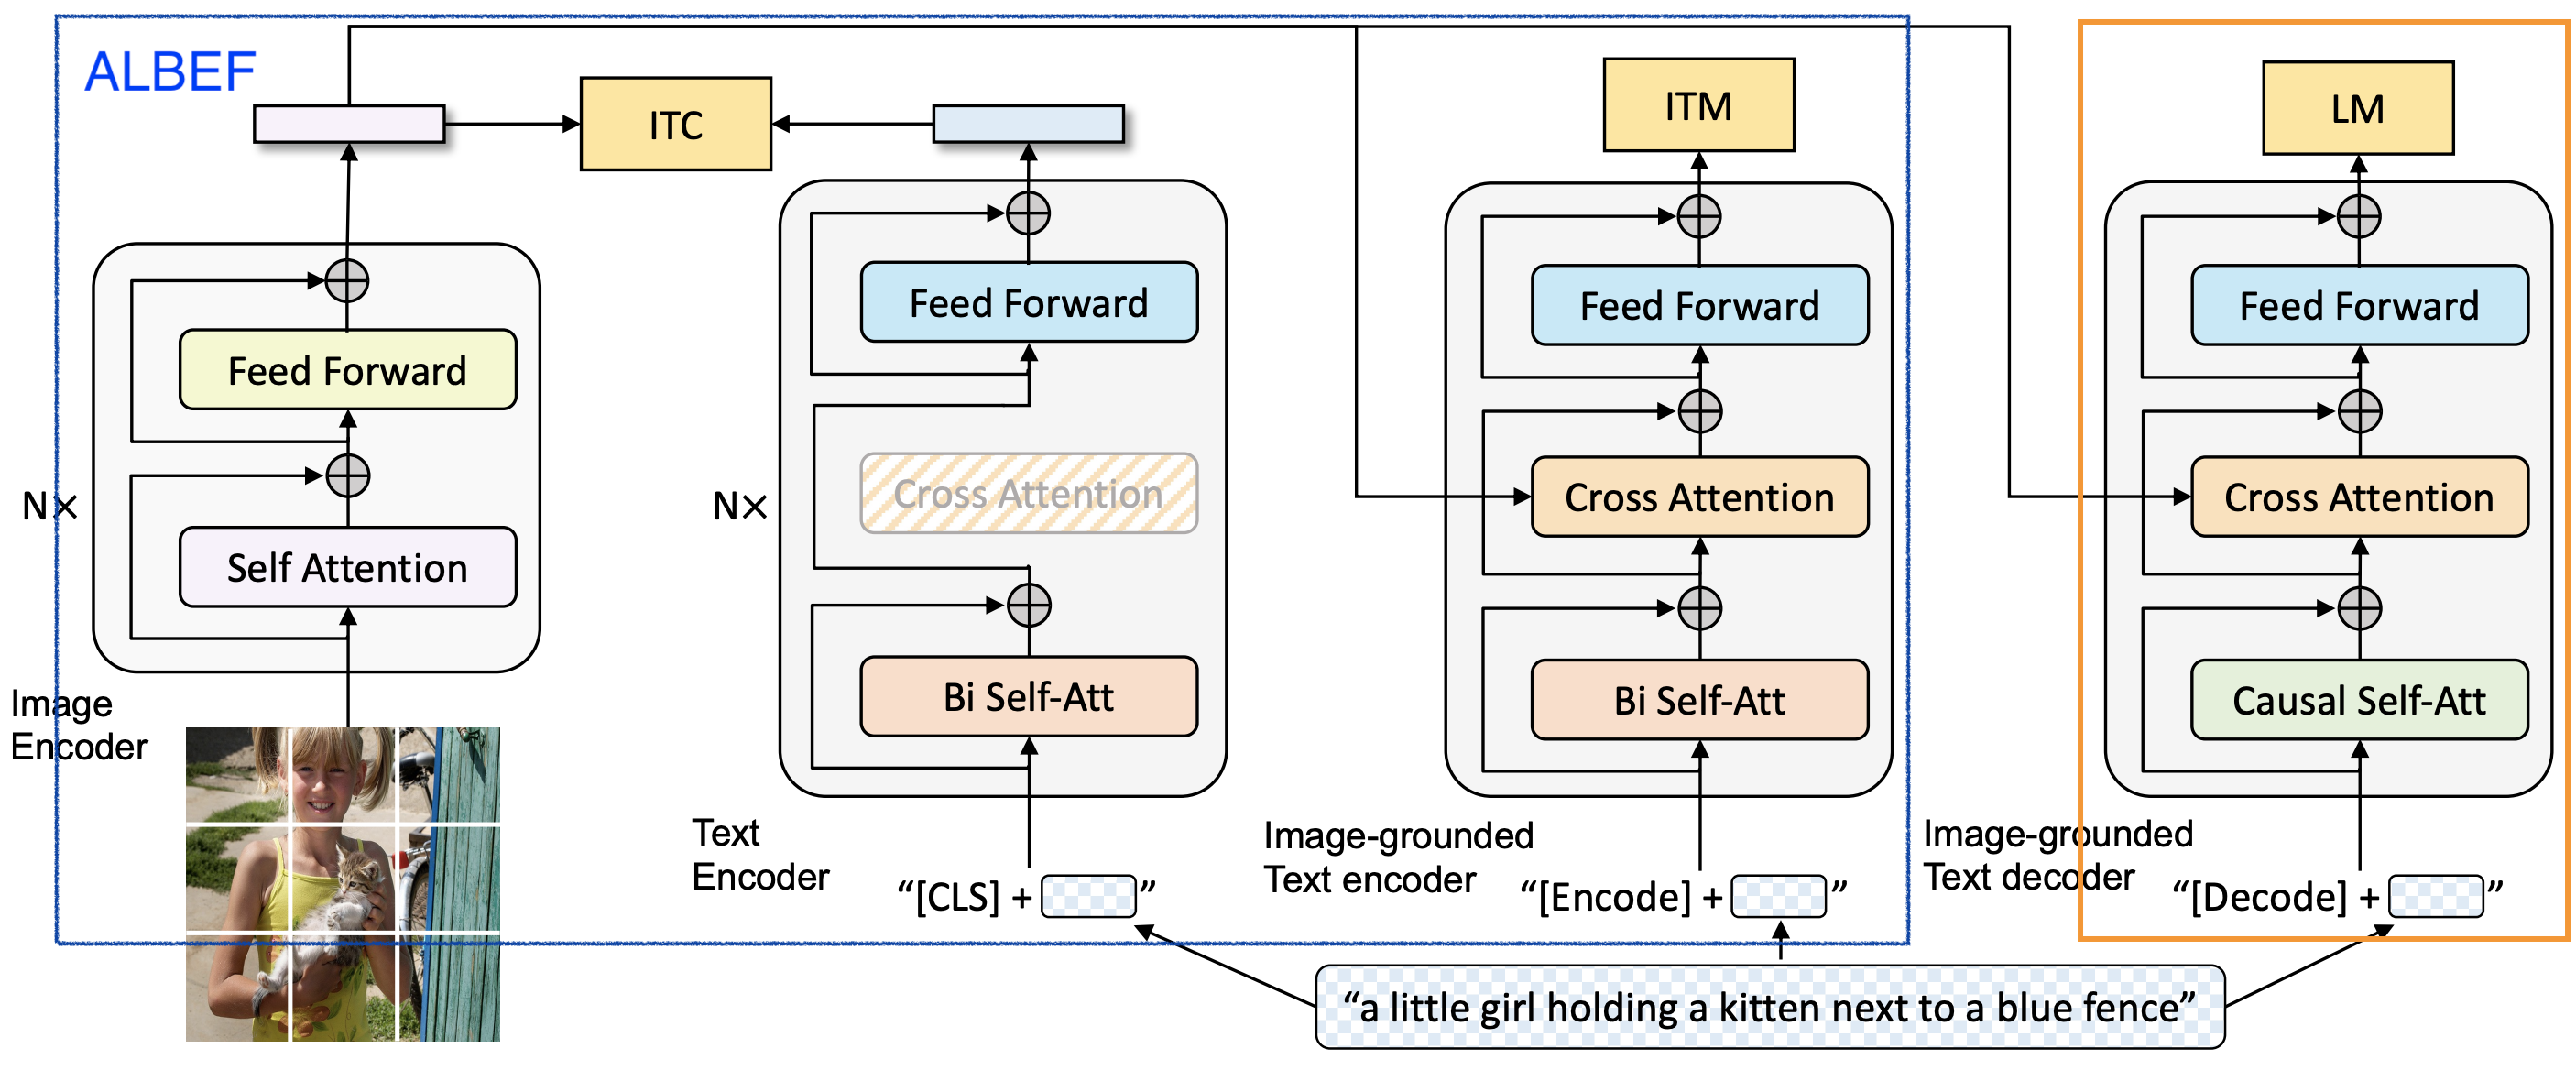
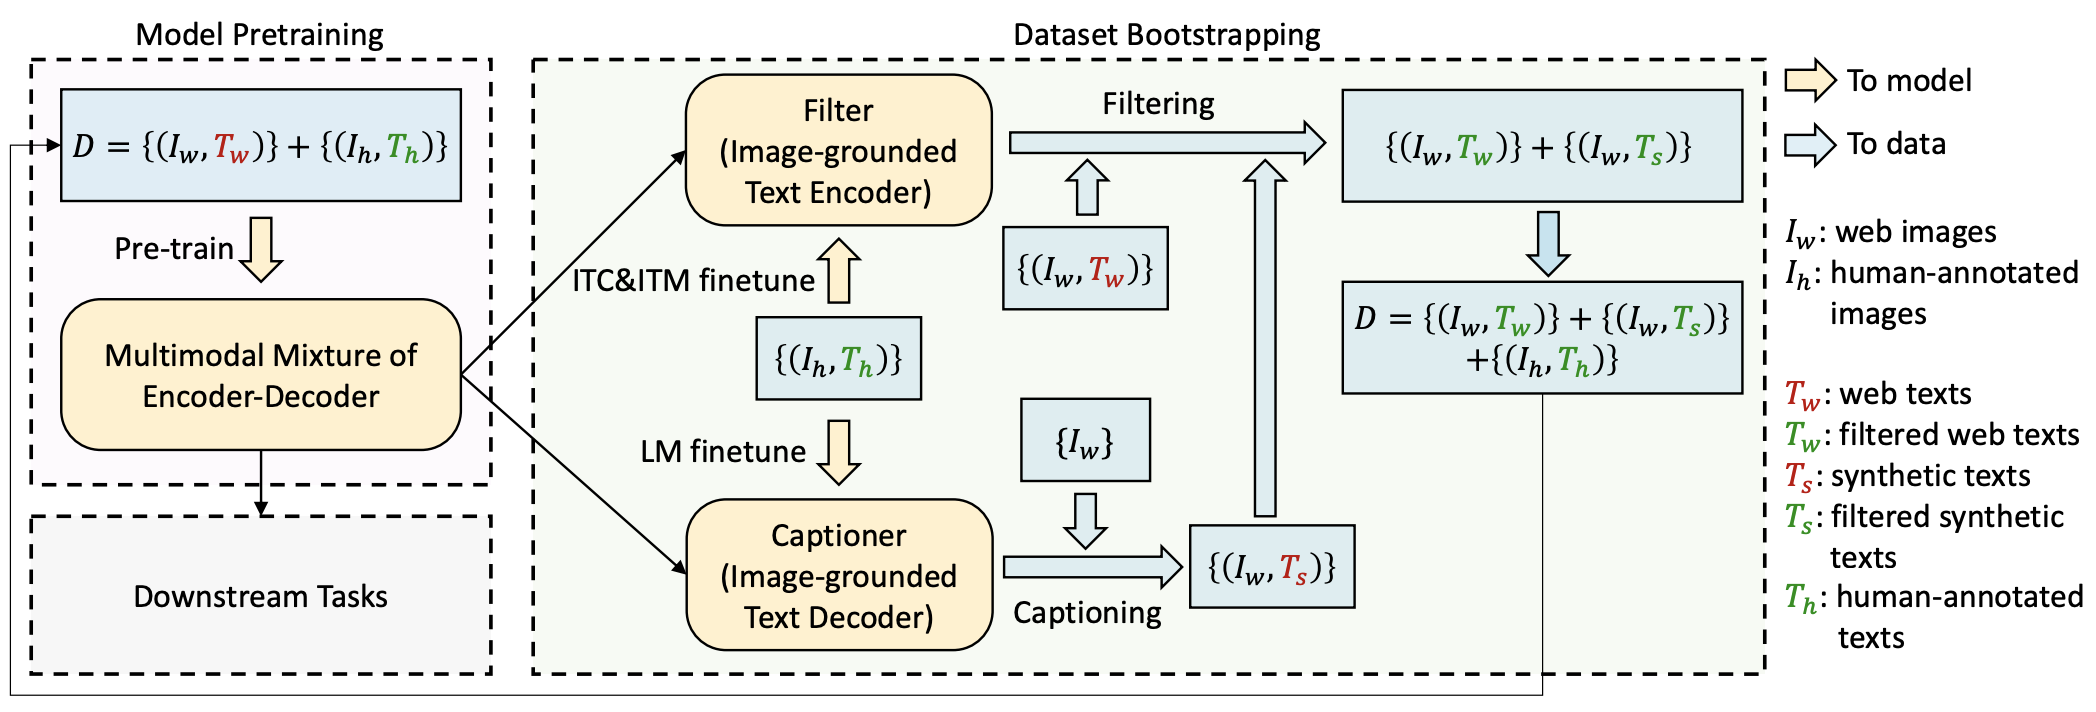
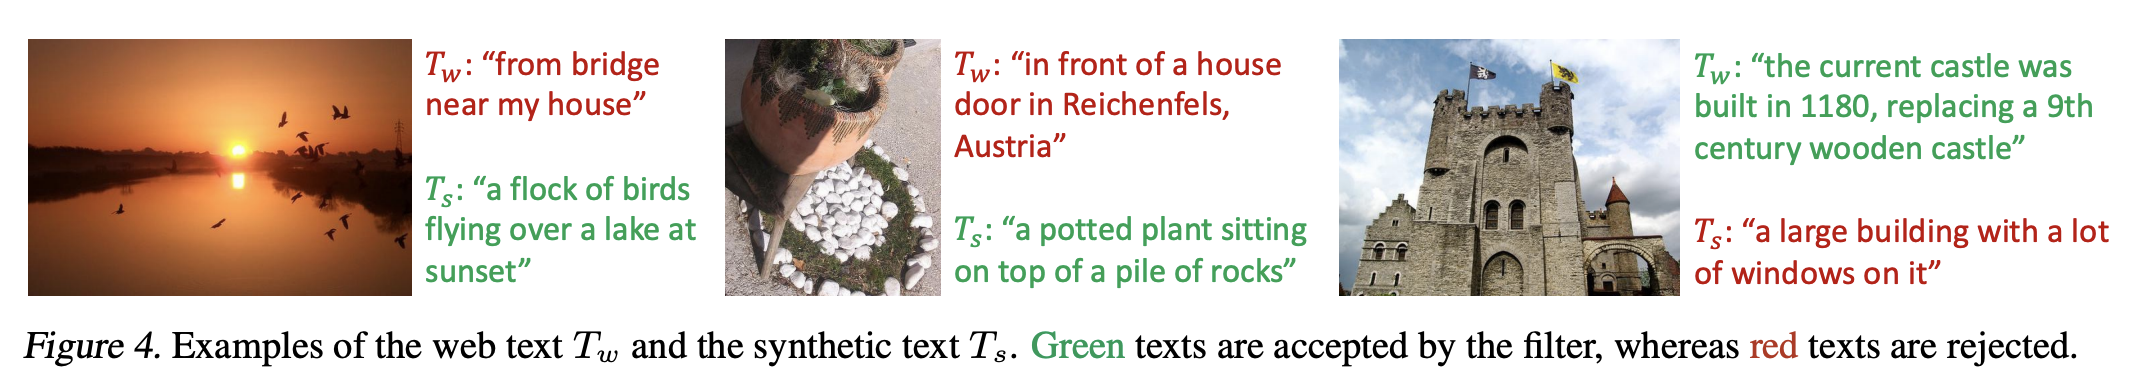
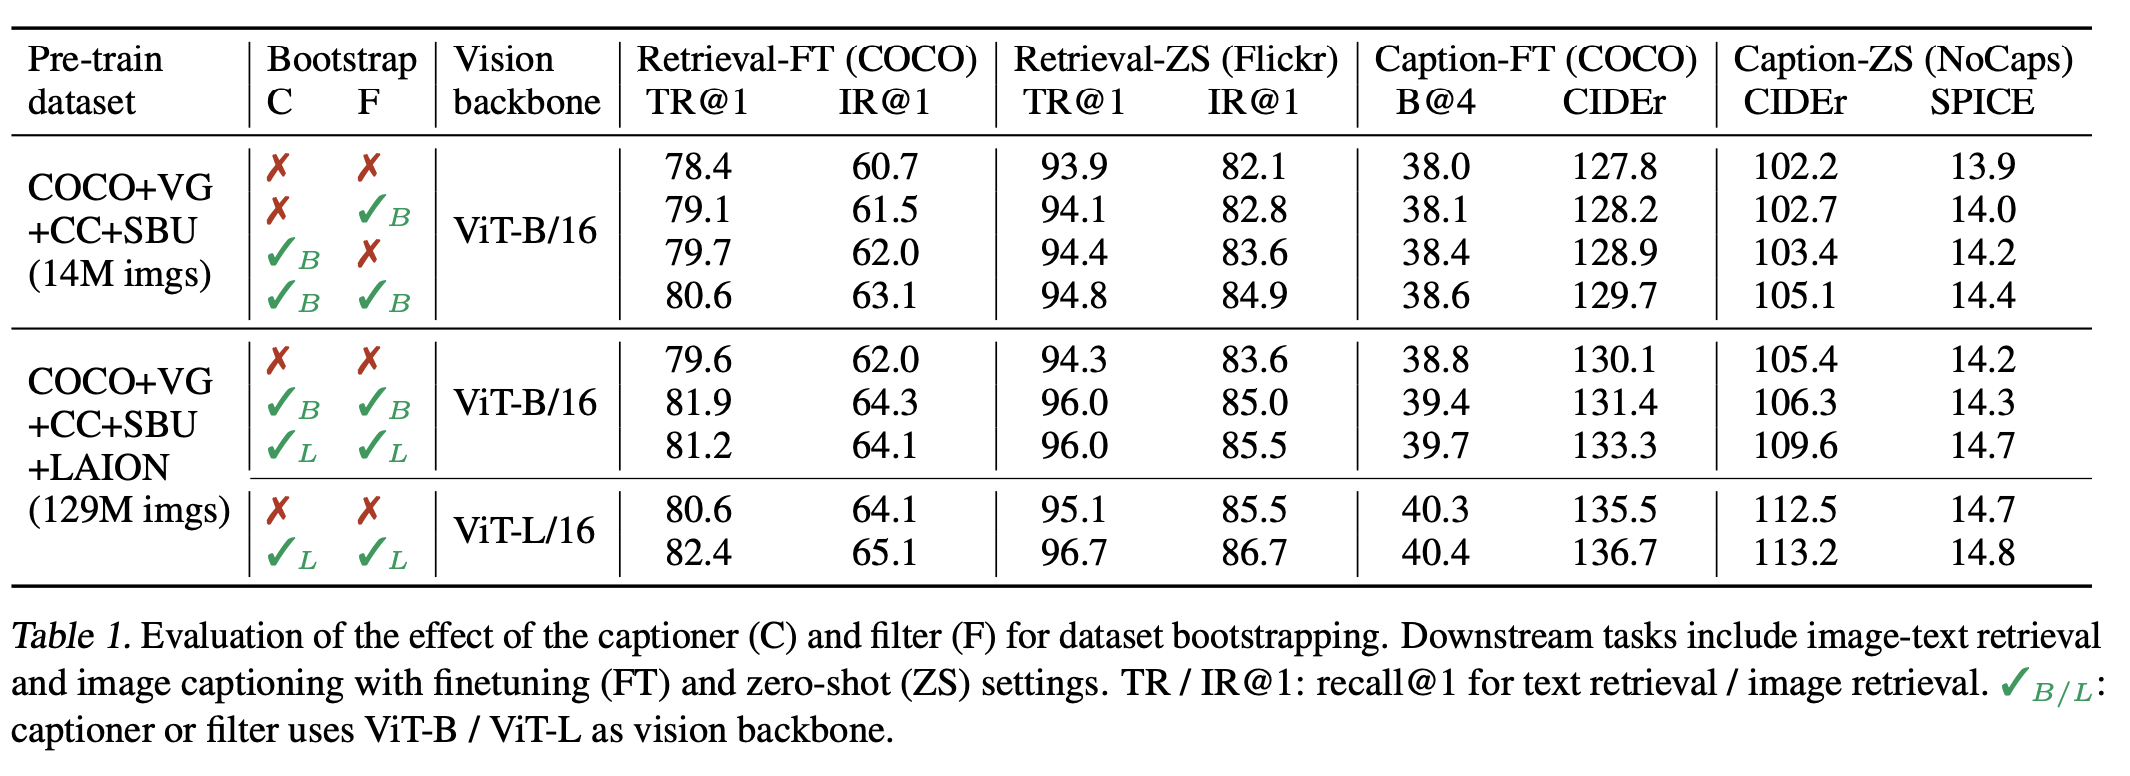
      <![CDATA[<p>2022年多模态领域的一篇很棒的工作，由ALBEF原班人马打造，结合了ALBEF和VLMO的共同优点，提出了统一结构的多阶段多模态模型，此外提出了一套可行的基于caption-filter的数据筛选self-training策略，值得一读。</p><p>论文链接：<a href="https://arxiv.org/abs/2201.12086">https://arxiv.org/abs/2201.12086</a></p><p>主要参考b站：<a href="https://www.bilibili.com/video/BV1fA411Z772/?spm_id_from=333.788.recommend_more_video.0&vd_source=e8b74628d0beb8e8c369a368ed8a3889">多模态论文串讲·下【论文精读·49】</a></p><p>BLIP的贡献值主要有两个</p><ol><li>模型层面，提出了encoder-decder的多模态结构，弥补了encoder-based的结构，例如CLIP这种做不了生成任务，Fusion-encoder模型结构例如ALBEF、VLMo没办法直接用来做retrieval的问题；</li><li>数据层面，提出了基于image-caption和image-text-filter策略的数据过滤方法，该操作显著提升了模型的性能，这种方式可以当做一个通用的数据筛选策略。</li></ol><span id="more"></span><h2 id="模型"><a href="#模型" class="headerlink" title="模型"></a>模型</h2><p>在ALBEF，CLIP这种encoder-only的多模结构，能很好的用在IR任务上，但是没办法用来做生成任务；对于encoder-decoder结构，可以用来做生成任务，但是模型又太大，再者结合VLMO提出来的MHA共享参数FFN做MMOE的观点，结合ALBEF，VLMO，和encoder-decoder结构，做一个统一的模型是可行的。</p><img src="/2023/02/13/%E8%AE%BA%E6%96%87%E7%B2%BE%E8%AF%BB-BLIP-%E5%A4%9A%E4%BB%BB%E5%8A%A1%E7%BB%93%E6%9E%84%E7%BB%9F%E4%B8%80%E4%B8%8E%E6%95%B0%E6%8D%AE%E7%AD%9B%E9%80%89%E7%AD%96%E7%95%A5/BLIP-MODEL.png" class="" title="BLIP-MODEL"><p>从模型结构可以看出</p><ol><li>整个模型中相同颜色的模块共享参数，这里明显借鉴了VLMo的思路，可以看到，相比encoder-only的模型只多了一个casual-self-attention模块；</li><li>蓝色框内可以看成和ALBEF是一样的结构，在交互之前使用ITC任务进行align，在交互之后使用ITM任务进行多模交互；</li><li>整个模型包含3个encoder和1个decoder</li><li>为了适配生成任务，将使用的是LM任务，给定前面的词，预测后面的词，和GPT的做法一致。</li></ol><h2 id="数据"><a href="#数据" class="headerlink" title="数据"></a>数据</h2><p>预训练的数据一般是图文对的形式，并且基本是从网上爬取来的，这个数据就有很大的噪声，在ALBEF中，使用的基于动量蒸馏的方式进行标签修正，在BLIP中，除了延续ALBEF中的策略外，又离线做了一个数据筛选策略。简单来说训练过程是这样的。</p><img src="/2023/02/13/%E8%AE%BA%E6%96%87%E7%B2%BE%E8%AF%BB-BLIP-%E5%A4%9A%E4%BB%BB%E5%8A%A1%E7%BB%93%E6%9E%84%E7%BB%9F%E4%B8%80%E4%B8%8E%E6%95%B0%E6%8D%AE%E7%AD%9B%E9%80%89%E7%AD%96%E7%95%A5/blip-dataset.png" class="" title="blip-dataset"><ol><li><p>使用离线抓取的数据和ALBEF的训练trick来训练blip模型，得到了几个encoder模型</p></li><li><p>生成caption和filter模型</p><ul><li><p>使用预训练之后的image-grounded text encoder在coco数据上进行finetune，得到具有图文匹配判别能力的filter模型</p></li><li><p>使用预训练之后的image-grounded text decoder在coco数据上进行finetune，得到具有图片描述生成能力的caption模型</p></li><li><p>caption和filter模型的初始参数一致，finetune是单独进行的</p></li></ul></li><li><p>数据处理流程</p><ul><li>对于有caption的数据，使用filter模型判断caption与图片是否match，不match的删掉，数据删除的过程；</li><li>对于没有caption的数据，使用caption模型生成caption信息，然后再用filter模型判断，不满足的删掉，满足的留下，数据增加的过程；</li></ul></li><li><p>经过数据筛选，得到数量更多，质量更好的图文对数据</p></li><li><p>将新的数据重新拿去训练BLIP模型，self-training的思路</p></li></ol><p>数据处理流程是独立的，离线的，这个方法完全可以移到其他领域中，用来数据筛选。</p><p>在论文中，作者给出了caption的效果，从例子中能看出来效果出乎意料的好，生产出来的caption有时候比原始的caption信息更好，通常来讲更高质量的数据对应着更好的性能。</p><img src="/2023/02/13/%E8%AE%BA%E6%96%87%E7%B2%BE%E8%AF%BB-BLIP-%E5%A4%9A%E4%BB%BB%E5%8A%A1%E7%BB%93%E6%9E%84%E7%BB%9F%E4%B8%80%E4%B8%8E%E6%95%B0%E6%8D%AE%E7%AD%9B%E9%80%89%E7%AD%96%E7%95%A5/blip-caption.png" class="" title="blip-caption"><p>数据策略是否有效呢？从论文中给出来的指标看</p><ol><li>Caption-filter策略一共能带来两个点左右的提升</li><li>Caption策略相比filter策略带来的提升更多一些，这个是符合直觉的，一定程度的noisy是不影响模型性能的，而caption提升了训练数据量，并且提高了数据的多样性。</li></ol><img src="/2023/02/13/%E8%AE%BA%E6%96%87%E7%B2%BE%E8%AF%BB-BLIP-%E5%A4%9A%E4%BB%BB%E5%8A%A1%E7%BB%93%E6%9E%84%E7%BB%9F%E4%B8%80%E4%B8%8E%E6%95%B0%E6%8D%AE%E7%AD%9B%E9%80%89%E7%AD%96%E7%95%A5/blip-exp.png" class="" title="blip-exp"><h2 id=""><a href="#" class="headerlink" title=""></a></h2>]]>
    </content>
    <id>https://xiaofengshi.com/2023/02/13/%E8%AE%BA%E6%96%87%E7%B2%BE%E8%AF%BB-BLIP-%E5%A4%9A%E4%BB%BB%E5%8A%A1%E7%BB%93%E6%9E%84%E7%BB%9F%E4%B8%80%E4%B8%8E%E6%95%B0%E6%8D%AE%E7%AD%9B%E9%80%89%E7%AD%96%E7%95%A5/</id>
    <link href="https://xiaofengshi.com/2023/02/13/%E8%AE%BA%E6%96%87%E7%B2%BE%E8%AF%BB-BLIP-%E5%A4%9A%E4%BB%BB%E5%8A%A1%E7%BB%93%E6%9E%84%E7%BB%9F%E4%B8%80%E4%B8%8E%E6%95%B0%E6%8D%AE%E7%AD%9B%E9%80%89%E7%AD%96%E7%95%A5/"/>
    <published>2023-02-13T12:05:00.000Z</published>
    <summary>
      <![CDATA[<p>2022年多模态领域的一篇很棒的工作，由ALBEF原班人马打造，结合了ALBEF和VLMO的共同优点，提出了统一结构的多阶段多模态模型，此外提出了一套可行的基于caption-filter的数据筛选self-training策略，值得一读。</p>
<p>论文链接：<a href="https://arxiv.org/abs/2201.12086">https://arxiv.org/abs/2201.12086</a></p>
<p>主要参考b站：<a href="https://www.bilibili.com/video/BV1fA411Z772/?spm_id_from=333.788.recommend_more_video.0&vd_source=e8b74628d0beb8e8c369a368ed8a3889">多模态论文串讲·下【论文精读·49】</a></p>
<p>BLIP的贡献值主要有两个</p>
<ol>
<li>模型层面，提出了encoder-decder的多模态结构，弥补了encoder-based的结构，例如CLIP这种做不了生成任务，Fusion-encoder模型结构例如ALBEF、VLMo没办法直接用来做retrieval的问题；</li>
<li>数据层面，提出了基于image-caption和image-text-filter策略的数据过滤方法，该操作显著提升了模型的性能，这种方式可以当做一个通用的数据筛选策略。</li>
</ol>]]>
    </summary>
    <title>[论文精读]BLIP-多任务结构统一与数据筛选策略</title>
    <updated>2023-02-17T16:00:34.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Xiaofeng Shi</name>
    </author>
    <category term="深度学习" scheme="https://xiaofengshi.com/categories/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    <category term="多模态" scheme="https://xiaofengshi.com/categories/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/%E5%A4%9A%E6%A8%A1%E6%80%81/"/>
    <category term="多模态" scheme="https://xiaofengshi.com/tags/%E5%A4%9A%E6%A8%A1%E6%80%81/"/>
    <content>
      <![CDATA[<p>从2020年8月左右开始接触多模态，当时也是业界多模态刚起步的阶段，到现在为止，经过了两年半左右的时间，多模态也经历了一系列的发展和工业界应用，这里进行一下总结回顾。</p><img src="/2023/02/10/%E6%88%AA%E6%AD%A22022%E5%A4%9A%E6%A8%A1%E6%80%81%E8%BF%9B%E5%B1%95/mm-overview2022.jpg" class="" title="mm-overview2022"><span id="more"></span><p>首先说，什么是多模态，目前在学术界和工业界更多还是说的图文多模态，那么在模型的角度上，要做的就是如何将图像和文本编码到一起。由此，多模态被拆分出来这么几个问题：</p><ul><li>视觉部分的特征如何提取<ul><li>关键词：FasterRcnn，Resnet50，VisionTransformer</li></ul></li><li>文本的特征如何提取<ul><li>关键词：Bert，Roberta，Albert</li></ul></li><li>多模态之间如何交互<ul><li>关键词：esim，transformer</li></ul></li><li>多模的任务如何设计<ul><li>关键词：ITC，ITM，MLM，MIM</li></ul></li></ul><p>在深度学习领域，哪些部分会影响模型的效果呢，经过这几年的学习和积累，目前总结了这几个方向</p><ol><li>更高的数据质量，更大的数据规模，已经被多种模型和对比实验反复验证的策略<ul><li>比如T5的数据筛选，ALBEF的动量蒸馏，BLIP的capfit策略</li><li>这是一个长久并且非常重要的方向，因为随着业务的开展会发现数据才是王道。</li></ul></li><li>增大模型的容量和复杂度<ul><li>比如bert larg，T5让模型更深，albert让模型更宽到4096维度</li><li>在业务中先把模型做的更大更深，拿到更高的性能，然后再进行模型蒸馏，就是这个思路</li></ul></li><li>更充分的预训练，Roberta训练的batchsize变大，步数增加<ul><li>这可以看成是一个训练策略了，为了对比模型或策略是否有效，在学术界或工业界一般采用的都是固定的训练配置，这里不过多赘述</li><li>业务中训练多少步，bsz多大要有对比实验来支撑。</li></ul></li><li>有难度或合理的的训练任务<ul><li>NLP方向中有albert的sop，Roberta的动态mlm，spanbert的replace span策略</li><li>多模方向中有ALBEF的ITC、ITM，BEIT的MIM等任务设计</li></ul></li></ol><p>具体到多模态领域，还有一个方向是多模统一框架模型，目前业界的共识是，多模态应该有一个统一的foundation model，它可以cover不同的模态，并能适配不同的下游任务，这个方向是有VLMO，Perceiver-IO，BEIT3</p><p>多模态领域也是归纳到这几个方向上，如上图所示，几个重点的模型有Vit，CLIP，ALBEF，VLMO，BEIT。下面会对这些模型进行简要说明，并且后续会对重要的模型进行重点说明。</p><h2 id="更好的视觉编码器"><a href="#更好的视觉编码器" class="headerlink" title="更好的视觉编码器"></a>更好的视觉编码器</h2><h3 id="CNN-based"><a href="#CNN-based" class="headerlink" title="CNN based"></a>CNN based</h3><p>在2020年的多模态模型，大量的多模态视觉encoder使用的是detection based方案，当时比较流行的模型有UNITER，VL-BERT，LXMERT，使用目标检测的得到的视觉特征当做image-token-sequence使用，和text-token拼接起来，交互方式使用的是transformer结构。这就是端到端多模态模型最开始的样子。如下是当时有名的VL-Bert的模型结构</p><img src="/2023/02/10/%E6%88%AA%E6%AD%A22022%E5%A4%9A%E6%A8%A1%E6%80%81%E8%BF%9B%E5%B1%95/vl-bert.png" class="" title="vl-bert"><h3 id="ViT"><a href="#ViT" class="headerlink" title="ViT"></a>ViT</h3><p><strong>基于目标检测的视觉方案缺点很明显，就是非常笨重</strong>。在2021等来了vision transformer，使用基于transformer的方式进行图片分类，验证了transformer对视觉的处理能力。至此，detection based的模型退出历史舞台，<strong>vision transformer正式接棒，当做视觉encoder直到现在</strong>。</p><img src="/2023/02/10/%E6%88%AA%E6%AD%A22022%E5%A4%9A%E6%A8%A1%E6%80%81%E8%BF%9B%E5%B1%95/vit-model.png" class="" title="vit-model"><p>在这个时间点看，在多模态领域使用基于transformer的vit方案，是比基于CNN的视觉方案更优的选择，不仅仅是transformer结构的性能的问题，而是在多模态领域，transformer有更好的适应性，既能处理文本特征，又能处理视觉特征，有助于模型结构的统一，Vit很大程度上影响了后续多模态的发展方向。</p><hr><h2 id="更合理的任务设计"><a href="#更合理的任务设计" class="headerlink" title="更合理的任务设计"></a>更合理的任务设计</h2><h3 id="CLIP"><a href="#CLIP" class="headerlink" title="CLIP"></a>CLIP</h3><p>ViT提出之后多模态领域出现了一篇现象级论文CLIP，使用两个独立的encoder和对比学习策略来进行zero-shot的图像分类任务，并验证了非常好的性能，至此<strong>对比学习正式进入多模态领域的任务设计</strong>。模型结构非常简单，训练方式非常直接，并且在retival领域验证了非常好的性能。</p><p><img src="/clip.png?100x" alt="clip"></p><h3 id="ViLT"><a href="#ViLT" class="headerlink" title="ViLT"></a>ViLT</h3><p>在ViLT中，可以看成将视觉encoder由基于检测的方案换成ViT之后的VL-Bert，视觉侧使用ViT的patch embedding+linear projection，文本侧使用Bert特征，并用多层transformer进行交互。</p><p><img src="/vilt-model.png" alt="vilt_model"></p><h3 id="ALBEF"><a href="#ALBEF" class="headerlink" title="ALBEF"></a>ALBEF</h3><p>在模型结构设计上，ALBEF可以看成是CLIP的对比学习策略和ViLT模型的合成体。ALBEF是一个非常棒的模型，尤其是在理解类型任务中；本文先概述它的关键设计。</p><p>ALBEF主要解决的是多模交互和数据噪声的问题，</p><ul><li>两个没有关系的模态直接用transformer进行交互，会导致性能不好，所以在交互之前先进行跨模态之间的对齐，这样有助于多模态交互的时候学习；</li><li>训练数据是存在很多噪声的，所以在ALBEF中引入了MOCO中的动量蒸馏策略，来修正数据的标签。</li></ul><p>ALBEF整体的结构如下</p><p><img src="/albef-model.png" alt="albef-model"> </p><p>ALBEF大体的贡献有如下几点：</p><ul><li>模型的整体结构与ViLT基本一致，是一个品字形结构，一共有3个encoder，分别对应language，visual，visual-language-multimodal，来进行特征提取和多模特征融合；</li><li>借鉴CLIP的对比学习思路，两个单模态交互之前进行对比学习，提前将两个模态进行特征对齐，有助于多模之间进行融合；</li><li>加入了动量蒸馏设计，修正网络数据中的噪声标签；</li><li>总共有5个Loss<ul><li>ITC，ITM，ITM_momentum，MLM，MLM_momentum</li></ul></li></ul><p>从本篇文章最开始的图中能看到，ALBEF对后续很多模型产生了影响，是一个非常重要的模型。交互之前使用对比学习进行对齐这一思想在后续的COCA，BLIP也被体现</p><h2 id="更统一的模型结构"><a href="#更统一的模型结构" class="headerlink" title="更统一的模型结构"></a>更统一的模型结构</h2><h3 id="VLMO"><a href="#VLMO" class="headerlink" title="VLMO"></a>VLMO</h3><p>VLMO可以看成是ALBEF的工程优化模型，并且VLMO提出的方案在后续的BLIP，BEIT_V3中被借鉴使用。在ALBEF中包含3个独立的encoder，存在这参数量较大的情况，在VLMO中，提出了<strong>共享MHA模块，训练各自的FFN部分</strong>的模型设计方案。这样可以实现多模态模型参数的有效减少，此外MHA共享参数，这样相比于ALBEF有更好的多模表现能力。</p><blockquote><p>这里值得一提的是，为什么可以共享MHA，记得在AlBert中测试过transformer中各个部分共享参数对指标的影响，试验显示，多层之间共享MHA部分的权重并不会降低模型的性能，验证了MHA对于不同层次特征的捕获能力，那么在不同模态之间共享MHA是否也可以呢？通过本文的实验指标，可以看出答案是肯定的，这说明MHA这一结构在横向纵向的参数共享仍能保持性能，MHA这一结构感觉仍值得继续挖掘使用。</p></blockquote><p><img src="/vlmo-train.png" alt="vlmo-train"> </p><p>模型结构不需要过多赘述，整个模型就是一个MHA共享参数，FFN单独训练的多层transformer模型。整个模型包含3个FFN，分别对应视觉，文本和多模。</p><p>VLMO模型分阶段训练的：</p><ol><li><p>第一步，训练V-FFN，这一步使用的是机遇CLIP方式训练的ViT模型，经过这一步mha+v-ffn具有对视觉模态的语义刻画能力；</p></li><li><p>第二步，固定MHA，训练L-FFN部分，这部分使用纯文本数据，使用MLM的LOSS，经过这一步L-FFN具有文本语义能力；</p></li><li><p>第三步，开放全部权重，训练多模数据，这里包含多个多模任务，这里的任务设计和ALBEF一致，没有用动量蒸馏的策略</p><ul><li><p>ITC：训练MHA，V-FFN，L-FFN使模型有多模态之间的对齐能力；</p></li><li><p>ITM：训练MHA，V-FFN，L-FFN，VL-FFN，使多模之间有进行交互，提升模型对多模的语义关系对齐能力，这里也用了和ALBEF中一样的hard negative mining的策略，筛选难负例送到下游交互来算ITM损失；</p></li><li><p>MLM：训练MHA，V-FFN，L-FFN，VL-FFN，对文本部分进行mask，使用全量视觉特征和剩余的文本信息对mask的文本进行预测，使模型具有多模之间信息补充能力。</p></li></ul></li></ol><p>第三阶段多模Loss部分如下图所示</p><p><img src="/vlmo-loss.png" alt="vlmo-loss"> </p><hr><h3 id="BLIP"><a href="#BLIP" class="headerlink" title="BLIP"></a>BLIP</h3><p>沿着ALBEF和VLMO继续发展，到了2022年，ALBEF的原班人马打造了BLIP模型，这篇文章中作者将ALBEF和VLMO的优点进行了结合，提出了统一的模型框架来适配不同的下游任务，和一套行之有效的数据筛选策略。</p><p>BLIP这篇论文研究动机有两个：</p><ol><li>encoder-based的模型，例如CLIP，ALBEF没办法做生成类型的任务；encoder-decoder的模型，例如SimVLM没办法做retrieval任务，所以一个能cover不同类型的下游任务的统一框架模型是有必要的。</li><li>与训练的数据基本都是从网上爬下来的，所以高质量的数据是有必要的，在ALBEF中用的是动量蒸馏的方法来进行标签修正，在BLIP中作者更进一步，提出了一个离线数据筛选策略。</li></ol><p>那么对应的BLIP的主要贡献就是这两个了。后续会开一个单独的文章进行详细说明，这里简要说一下。</p><h4 id="模型"><a href="#模型" class="headerlink" title="模型"></a>模型</h4><p>模型结构如下所示，可以看到ALBEF和VLMO的影子</p><ul><li>整个模型包含3个encoder和1个decoder(为了能cover生成类型任务)；</li><li>图中相同颜色的模块共享参数，这里明显借鉴了VLMO的思想；</li><li>任务设计上，除了将MLM换成了适配生成任务的LM(GPT用的loss)，其他的ITC，ITM走的ALBEF的路子；</li><li>Image-grounded text encoder和Image-grounded text decoder的数据输入方式，借鉴了GPT的思路，将任务编码到输入数据中；</li><li>为了适配生成任务，Decoder中加了一个因果自注意力模块，也就是masked attention，这里和transformer的decoder一致。</li></ul><p><img src="/BLIP-MODEL.png" alt="BLIP-MODEL"></p><p>可以看到BLIP集成了多种模型已经验证有效的优点。</p><h4 id="数据"><a href="#数据" class="headerlink" title="数据"></a>数据</h4><p>在数据上，除了继续保留了ALBEF基于动量蒸馏的训练策略之前，提出了一个基于caption-filter模型的数据筛选策略。简而言之，先用全部数据训练第一版模型，然后用这个模型对数据进行筛选和扩增，产出更高质量的数据，再用这个新数据在第一版模型基础上再训练第二版数据，如此得到最终模型，一个典型的self-training的思路，有点对第一版模型进行蒸馏的感觉。</p><p><img src="/blip-capfit.png" alt="blip-capfit"></p><h3 id="COCA"><a href="#COCA" class="headerlink" title="COCA"></a>COCA</h3><p>论文链接：<a href="https://arxiv.org/pdf/2205.01917.pdf">https://arxiv.org/pdf/2205.01917.pdf</a></p><p>coca是google的一篇工作，提出一个foundation model，模型结构和ALBEF实在是太像了，主要三个地方不同，</p><ul><li>一个是encoder换成了decoder，任务换成了LM，这里和BLIP，GPT一致；</li><li>另一个视觉部分的encoder使用attention pooling之后在于text部分进行corss-att交互</li><li>去掉了ITM loss</li></ul><p><img src="/coca-model.png" alt="coca"></p><p>训练完之后，可以直接用来做下游任务</p><p><img src="/coca-down.png" alt="coca-down"></p><p>COCA比BLIP的提出晚了大约4个月的时间，模型的设计方面可说的倒是不多，在数据上COCA用了更大量的数据，将COCA的效果进行了大幅度的提升，基本在各个下游的单项任务上进行了刷榜。</p><p><img src="/coca-result.png" alt="coca-result"></p><p>NLP预训练的发展</p><p>预训练模型</p><p>Word2Vec-&gt;ELMo-&gt;GPT-&gt;BERT-&gt;MT-DNN-&gt;GPT2</p><p>WordEmbedding</p><p>在说Word Embedding之前，先更粗略地说下语言模型，因为一般NLP里面做预训练一般的选择是用语言模型任务来做。</p><table><thead><tr><th></th></tr></thead><tbody><tr><td><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic.png" alt="pastedGraphic.png"></td></tr></tbody></table><p><strong>什么是语言模型？</strong></p><p>看上面这张图就明白了，为了能够量化地衡量哪个句子更像一句人话，可以设计如上图所示函数，核心函数P的思想是根据句子里面前面的一系列前导单词预测后面跟哪个单词的概率大小（理论上除了上文之外，也可以引入单词的下文联合起来预测单词出现概率）,看图片中的分解公式，明显的马尔科夫链。句子里面每个单词都有个根据上文预测自己的过程，把所有这些单词的产生概率乘起来，数值越大代表这越像一句人话。</p><p>2013年之前的语言模型</p><p>在2013年的时候，最火的用语言模型做Word Embedding的工具就是Word2Vec。Word2Vec有两种训练方法：</p><ul><li>第一种叫CBOW，核心思想是从一个句子里面把一个词抠掉，用这个词的上文和下文去预测被抠掉的这个词，是不是跟BERT的MLM很相似；</li><li>第二种叫做Skip-gram，和CBOW正好反过来，输入某个单词，要求网络预测它的上下文单词。</li></ul><p><strong>word2vector的缺陷在哪里？</strong></p><p>Word Embedding对于很多下游NLP任务是有帮助的，只是帮助没有大到很了不起的程度。那么问题来了，为什么这样训练及使用Word Embedding的效果没有期待中那么好呢？</p><p>答案很简单，因为Word Embedding有问题。最大的问题就是多义词。因为对于一个多义词尽管上下文环境中出现的单词不同，但是在用语言模型训练的时候，不论什么上下文的句子经过word2vec，都是预测相同的单词，而同一个单词占的是同一行的参数空间，这导致两种不同的上下文信息都会编码到相同的word embedding空间里去。所以word embedding无法区分多义词的不同语义，这就是它的一个比较严重的问题。</p><p>对于这个情况，ELMo给出了一个简洁优雅的方案。</p><p>ELMo 2018</p><p>论文链接：</p><p>代码链接</p><p>博客讲解：</p><p><a href="https://www.cnblogs.com/huangyc/p/9860430.html">https://www.cnblogs.com/huangyc/p/9860430.html</a></p><p><a href="https://zhuanlan.zhihu.com/p/63115885">https://zhuanlan.zhihu.com/p/63115885</a> </p><p>虽然是一个比较老的模型了，但是这个模型对后面的bert，gpt都是有启发意义的。之前说到词向量，用的是word2vec的方式，因为在它提出的词向量概念给NLP的发展带来了巨大的提升。而ELMo的主要做法是先训练一个完整的语言模型，再用这个语言模型去处理需要训练的文本，生成相应的词向量，所以ELMo的模型对同一个字在不同句子中能生成不同的词向量，所以说，ELMO最重要的一点是训练一个语言模型。</p><table><thead><tr><th>结构：双向LSTM模型，一个前向一个后向语言模型   特征：得到三个特征，E1,E2,E3 三者共同构建下游任务输入   目标函数：预测对应位置的下一个单词，T1的label是E2</th><th><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_1.png" alt="pastedGraphic_1.png"></th></tr></thead><tbody><tr><td>下游任务</td><td><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_2.png" alt="pastedGraphic_2.png"></td></tr><tr><td>from <a href="https://zhuanlan.zhihu.com/p/54578457">https://zhuanlan.zhihu.com/p/54578457</a></td><td></td></tr></tbody></table><p>总结：ELMo通过语言模型任务得到句子中的单词的向量，这个向量是结合左向右向的信息，但是仅仅是拼接的实现。</p><p><strong>ELMo为什么比word2vector有效？</strong></p><ul><li>ELMo的假设前提一个词的词向量不应该是固定的，所以在一词多意方面ELMo的效果一定比word2vec要好。</li><li>word2vec的学习词向量的过程是通过中心词的上下窗口去学习，学习的范围太小了，而ELMo在学习语言模型的时候是从整个语料库去学习的，而后再通过语言模型生成的词向量就相当于基于整个语料库学习的词向量，更加准确代表一个词的意思。</li><li>ELMo还有一个优势，就是它建立语言模型的时候，可以运用非领域任务的超大语料库去学习，一旦学习好了，可以平行的运用到相似问题，这就是后面bert预训练的搞法，目前NLP的通用训练范式。</li></ul><p>Transformer-Attention is all you need</p><table><thead><tr><th></th></tr></thead><tbody><tr><td><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_3.png" alt="pastedGraphic_3.png"></td></tr><tr><td></td></tr></tbody></table><p>原始的transformer是一个encoder-decoder结构，这种结构在NMT任务中验证了成功，之后的很多工作尝试去掉encoder或者decoder，也就是只使用一套堆叠得尽可能多的 transformer 模块，然后使用海量文本、耗费大量的算力进行训练。</p><table><thead><tr><th></th></tr></thead><tbody><tr><td><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_4.png" alt="pastedGraphic_4.png"></td></tr><tr><td></td></tr></tbody></table><p>GPT系列</p><p>博客收集：<a href="https://blog.csdn.net/yimenren/article/details/122286135">https://blog.csdn.net/yimenren/article/details/122286135</a> </p><p>GPT是一系列的模型，目前已经发展到了第三代，这里逐个的说一下 </p><p>这里有几点要说明</p><ol><li>GPT系列可以看做NLG领域的标杆，主攻文本生成方向，和Google的BERT主攻NLU文本理解方向，可以说统治NLP的两大领域。</li><li>GPT使用的是单向transformer模型结构</li><li>最近大火的ChatGPT可以看成GPT3的聊天定制版，更小巧，更适合商用。</li></ol><p><strong>GPT-1</strong></p><p>论文链接：Improving Language Understanding by Generative Pre-Training</p><p>代码链接</p><p>博客讲解：</p><p><a href="https://juejin.cn/post/6949891635735953438">https://juejin.cn/post/6949891635735953438</a> </p><p><a href="https://www.cnblogs.com/huangyc/p/9860430.html">https://www.cnblogs.com/huangyc/p/9860430.html</a></p><p><a href="https://zhuanlan.zhihu.com/p/63115885">https://zhuanlan.zhihu.com/p/63115885</a> </p><p>承接ELMo，使用transformer结构替代了ELMO中的LSTM结构，构建了新的模型结构，并且给出了一系列的下游任务的用法。一般GPT和Bert会一起提起，这里将二者放在一起说。</p><table><thead><tr><th><strong>BERT VS GPT</strong></th><th></th></tr></thead><tbody><tr><td><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_5.png" alt="pastedGraphic_5.png"></td><td></td></tr><tr><td>BERT 预训练：每个token可以看到整个序列 训练任务：MLM+NSP 模型效果：适合NLU语言理解任务 模型结构：Transformer中的encoder部分</td><td>GPT:  预训练：使用transformer结构，只能看到当前token前面的部分，看不到后面，通过MASK实现； 训练任务：LM 模型效果：适合NLG语言生成类任务 模型结构：Transformer中的decoder部分，去掉了cross-attention部分</td></tr></tbody></table><p>GPT的训练范式是先预训练后微调，和BERT一致。</p><p>预训练</p><p>在无标注的数据上，GPT通过最大化似然估计来进行模型训练，每个token使用左侧的token进行预测，整个transformer是从左到右的结构。模型包含12层transformer。</p><p>finetune</p><p>预训练结束之后进行少量数据的finetune，对于每一个输入，经过预训练之后的模型，使用最后一层最有个时间步输出的向量作为下游任务的输入，根据任务设计不同的下游任务head，并计算loss。在finetune的时候也会将预训练的语言模型任务保留下来，当做辅助任务，这样能加速模型收敛和提高模型的通用能力。</p><p><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/equation.pdf" alt="equation.pdf"></p><p>其中<img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/equation_1.pdf" alt="equation_1.pdf">。</p><p>不同的下游任务该怎么进行数据设计呢？</p><table><thead><tr><th><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_6.png" alt="pastedGraphic_6.png"></th></tr></thead><tbody><tr><td>s</td></tr><tr><td>entailment：文本包含任务，用一个$负号将文本和假设进行拼接，并在拼接后的文本前后加入开始符 start 和结束符end，然后将拼接后的文本直接传入transformer，最后一层+linear+softmax</td></tr><tr><td>similarity：文本相似度任务，由于相似度不需要考虑两个句子的顺序关系，因此，为了反映这一点，作者将两个句子分别与另一个句子进行拼接，中间用“$”进行隔开，并且前后还是加上起始和结束符，然后分别将拼接后的两个长句子传入Transformer，最后分别得到两个句子的emb，将这两个向量进行元素相加，然后再接如线性层和softmax层。</td></tr><tr><td>multiple choice：问答和尝试推理任务，首先将本经信息与问题进行拼接，然后再将拼接后的文本一次与每个答案进行拼接，最后依次传入Transformer模型，最后接一层线性层得到每个输入的预测值</td></tr></tbody></table><p><strong>GPT-2</strong></p><p>论文链接：<a href="https://d4mucfpksywv.cloudfront.net/better-language-models/language-models.pdf">Language Models are Unsupervised Multitask Learners</a> </p><p>代码链接：<a href="https://github.com/openai/gpt-2">https://github.com/openai/gpt-2</a> </p><p>DEMO链接：<a href="https://demo.allennlp.org/next-token-lm">https://demo.allennlp.org/next-token-lm</a> </p><p>博客链接：</p><p><a href="https://zhuanlan.zhihu.com/p/57251615">https://zhuanlan.zhihu.com/p/57251615</a></p><p><a href="https://www.cnblogs.com/zhongzhaoxie/p/13064404.html">https://www.cnblogs.com/zhongzhaoxie/p/13064404.html</a> </p><p><a href="https://zhuanlan.zhihu.com/p/343922021">https://zhuanlan.zhihu.com/p/343922021</a> </p><p><strong>核心思想</strong></p><p>模型结构上与GPT1相同，GPT-2的核心思想是用无监督的预训练任务模型做有监督的任务，去掉原来的预训练+finetune的二阶段训练范式。GPT2的具体实现方式如下？</p><ul><li>LM语言模型本质上是给序列进行条件概率建模，也就是计算<img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/equation_2.pdf" alt="equation_2.pdf"></li><li>任何的有监督任务，本质上是在进行估计<img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/equation_3.pdf" alt="equation_3.pdf">，一般会用特定的网络结构进行任务建模，但是如果要做成通用模型，建模方式要变成<img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/equation_4.pdf" alt="equation_4.pdf">形式。</li></ul><p><strong>在NLP中如何将 task建模进去呢？</strong></p><p>对于不同的任务可以将输入改成类似的形式</p><ul><li><ul><li><ul><li>翻译任务 <img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/equation_5.pdf" alt="equation_5.pdf"></li><li>问答任务 <img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/equation_6.pdf" alt="equation_6.pdf"></li></ul></li></ul></li></ul><p>这样可以使用一个模型进行有监督的多任务学习。</p><ul><li>语言模型 &#x3D; 有监督多任务学习，在第二条中，无监督的语言模型对比有监督的多任务学习，语言模型只是不需要显示地定义哪些字段是要预测的输出，所以，有监督的输出可以看成语言模型序列中的一个子集。</li></ul><p>有点绕，举个🌰</p><p>比如在训练语言模型时，有一句话“The translation of word Machine Learning in chinese is 机器学习”，那在训练完这句话时，语言模型就自然地将翻译任务和任务的输入输出都学到了。再比如，又碰到一句话“美国的总统是特朗普”，这一句话训练完，也就是一个QA任务了。</p><p>当然，要想用无监督任务完成有监督的多任务，无监督任务的训练数据是要经过挑选设计的，也就是需要高质量的预训练数据。</p><p><strong>和BERT的区别</strong></p><ul><li><p>模型结构的区别</p></li><li><ul><li>BERT是双向transformer，可以看到整个序列的信息；</li><li>gpt2是单向transformer，和传统的语言模型一样，一次只输出一个单词，并且只能看到前面的信息；</li></ul></li><li><p>为什么BERT无法实无监督预训练做有监督多任务呢?</p></li></ul><p>BERT是双向Transformer，建模方式为<img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/equation_7.pdf" alt="equation_7.pdf">，使用整个序列的所有信息进行建模，这种方式如果套用到有监督多任务上是存在数据泄漏的，所有没办法实现<img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/equation_8.pdf" alt="equation_8.pdf">这种方式建模。</p><p><strong>GPT2的改动</strong></p><ol><li>去掉finetune部分，不再针对不同的下游任务进行finetune，全部使用无监督完成，模型会根据输入识别出要做什么任务；</li><li>增加数据集规模，和筛选得到高质量数据，数据量扩增到40G；</li><li>增加网络参数，GPT2模型是48层，隐藏层维度1600，参数大约17E，是bert的5倍；</li><li>调整transformer结构，LN挪到了block且每个attention后面再加一个LN；</li><li>词表数量增加到50257；</li><li>最大的上下文从GPT1的512提升到1024；</li><li>batch size增加到512</li><li>残差层的初始值用<img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/equation_9.pdf" alt="equation_9.pdf">进行缩放，其中<img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/equation_10.pdf" alt="equation_10.pdf">是残差的个数。</li></ol><p><strong>模型效果</strong></p><table><thead><tr><th>一共训练4个模型 最大模型参数为17E</th><th><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_7.png" alt="pastedGraphic_7.png"></th></tr></thead><tbody><tr><td>随着模型参数增长，指标提升</td><td><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_8.png" alt="pastedGraphic_8.png"></td></tr></tbody></table><p><strong>GPT-3</strong></p><p>论文链接：<a href="https://arxiv.org/abs/2005.14165">Language Models are Few-Shot Learners</a></p><p>代码链接：<a href="https://github.com/openai/gpt-3">https://github.com/openai/gpt-3</a></p><p>博客链接：</p><pre><code>&lt;https://zhuanlan.zhihu.com/p/200978538&gt; [李宏毅《深度学习人类语言处理》国语课程(2020)](https://www.bilibili.com/video/BV1QE411p7z3/?p=30&amp;share_medium=iphone&amp;share_plat=ios&amp;share_source=COPY&amp;share_tag=s_i&amp;timestamp=1594474448&amp;unique_k=yytcW7&amp;vd_source=e8b74628d0beb8e8c369a368ed8a3889)</code></pre><p>延续GPT系列的单向transformer结构，模型容量更大175B，训练数据更多45T，GPT3更聚焦通用的NLP模型，和GPT2、T5一个思路，旨在用更少的领域数据，并且不经过微调去解决问题。</p><p><strong>出发点</strong></p><p>pretrain+finetune的两阶段训练方式，存在如下三个问题，所以有必要并且可以去掉fnetune。</p><ol><li>对不同的下游任务要准备不同的标注数据，并且这个数据的准备是需要一定的时间和成本的，并且不利于语言模型的应用；</li><li>下游数据的数据规模相比预训练的数据是非常少的，模型的finetune是去过拟合标注数据的分布，也就是提升模型表征能力的同时降低了数据的分布，这样的模型有过拟合风险。</li><li>对于人类，不需要大量的标注数据学习就能很好的切换和融合不同的任务，这样的能力语言模型是不具备的。</li></ol><p><strong>移除finetune的方法</strong></p><ol><li>meta-learning 元学习，模型在训练阶段具备了一系列模式识别的能力和方法，并通过在预测过程中利用这些能力和方法以快速适应一个下游任务。最近的一些研究尝试通过称为in-context learning的方法来实现上述过程，然而效果距离期待的相差甚远。</li><li>Large scale transformers：Transformer语言模型参数的每一次增大都会让文本理解能力和其他的NLP下游任务的性能得到提升。此外，有研究指出描述许多下游任务性能的log损失能让模型的性能和参数之间服从一个平滑趋势。考虑到in-context learning会将学习到的知识和方法存在模型的参数中，in-context learning也会随着模型参数规模的增长而变强。</li></ol><p><strong>什么是in-context learning？</strong></p><p>在被给定的几个任务示例或一个任务说明的情况下，模型应该能通过简单预测以补全任务中其他的实例。即，情境学习要求预训练模型要对任务本身进行理解。情境学习三种分类定义和示例如下：</p><ul><li><p>few-shot learning</p></li><li><ul><li>定义：允许输入数条范例和一则任务说明</li><li>示例：向模型输入“这个任务要求将中文翻译为英文。你好-&gt;hello，再见-&gt;goodbye，购买-&gt;purchase，销售-&gt;”，然后要求模型预测下一个输出应该是什么，正确答案应为“sell”。</li></ul></li><li><p>one-shot learning</p></li><li><ul><li>定义：只允许输入一条范例和一则任务说明</li><li>示例：向模型输入“这个任务要求将中文翻译为英文。你好-&gt;hello，销售-&gt;”，然后要求模型预测下一个输出应该是什么，正确答案应为“sell”。</li></ul></li><li><p>zero-shot learning</p></li><li><ul><li>定义：不允许输入任何范例，只允许输入一则任务说明</li><li>示例：向模型输入“这个任务要求将中文翻译为英文。销售-&gt;”，然后要求模型预测下一个输出应该是什么，正确答案应为“sell”。</li></ul></li></ul><p> <img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_9.png" alt="pastedGraphic_9.png"> </p><p><strong>主要贡献</strong></p><p>证明了通过增大参数量就能让语言模型显著提高下游任务在Few-shot（仅给定任务说明和少量示例）设置下的性能，即证明了大规模语言模型使用元学习策略的可能和fine-tuning策略的非必要性。</p><ol><li>训练了包含175B参数（以往非稀疏语言模型的10倍大小）的GPT3自回归语言模型，并在多个数据集上测试没有fine-tune过程的性能表现。</li><li>虽然GPT3在文本翻译、问答系统、完型填空、新词使用和代数运算等任务表现不错，但在阅读理解和推理任务数据集上的表现仍有待提高，还是不是BERT结构。</li><li>由于GPT-3的训练依赖于大量的网页语料，所以模型在部分测试数据集上可能出现方法论级别的data containation问题。</li><li>GPT-3能够编写出人类难以区分的新闻文章，论文讨论了该能力的社会影响力。</li></ol><p><strong>GPT3.5(davincci001&#x2F;002&#x2F;003)</strong></p><p>GPT-3.5 系列是在 2021 年第四季度之前的文本代码混合体上训练的一系列模型，包括这些模型：<a href="https://platform.openai.com/docs/model-index-for-researchers">https://platform.openai.com/docs/model-index-for-researchers</a> </p><ul><li>code-davinci-002是一个基础模型，适合于纯代码补全任务</li><li>text-davinci-002 是基于 code-davinci-002 的 InstructGPT 模型</li><li>text-davinci-003 是对 text-davinci-002 的改进</li></ul><p><strong>ChatGPT</strong></p><p>论文链接：<a href="https://openai.com/blog/instruction-following/">https://openai.com/blog/instruction-following/</a></p><p>代码链接：</p><p>博客链接：</p><pre><code>&lt;https://openai.com/blog/chatgpt/&gt;  [ChatGPT会取代搜索引擎吗 ](https://zhuanlan.zhihu.com/p/589533490)  </code></pre><p>经过两年的蛰伏，2022年12月等来了引爆全网的ChatGPT，火爆程度不要于当年的AlphaGo。具体的例子现在已经全网流传，人们目前在广泛讨论ChatGPT对各个行业的冲击，作为搜索算法工程师，个人感觉ChatGPT可能会改变一直以来的搜索方式，由从候选里面选择相关doc变成直接生成用户需要的答案，这是一个颠覆性的变革，当然对于其他领域，例如文字编辑类，创意生成，智能客服等都可能带来冲击。此外本人深切感受到，目前国内的Ai研究相比Google，openai，deepmid存在着很大的差距。此外，这次GPT家族在和bert的竞争中扳回了一局，并且给深度学习续命了最少5年时间，相比AlphaGo下象棋，这次让人们切实看到了Ai的能力。</p><p><strong>ChatGPT和GPT3的关系</strong></p><p>作为GPT3的继任者，ChatGPT和GPT3的关系如下：</p><ul><li>GPT3是一个通用语言模型，是有史以来最大、最强大的语言模型之一，拥有 1750亿个参数。GPT-3 旨在执行各种语言处理任务，包括语言翻译、摘要和文本生成</li><li>ChatGPT是一种更小、更专业的语言模型，专为聊天应用程序设计。它基于相同的 GPT-3 技术构建，但已经过微调以处理会话语言的特定挑战，例如理解上下文、识别意图和提供适当的响应。与通用语言模型 GPT-3 不同，chatGPT 专注于提供自然且引人入胜的对话体验。</li></ul><table><thead><tr><th><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_10.png" alt="pastedGraphic_10.png"></th><th><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_11.png" alt="pastedGraphic_11.png"></th></tr></thead><tbody><tr><td>from  <a href="https://zhuanlan.zhihu.com/p/590389451">https://zhuanlan.zhihu.com/p/590389451</a></td><td>from  <a href="https://arxiv.org/pdf/2203.02155.pdf">https://arxiv.org/pdf/2203.02155.pdf</a></td></tr></tbody></table><p><strong>ChatGPT怎么训练的</strong></p><ol><li>第一阶段：冷启动阶段的监督策略模型。靠GPT3.5本身，尽管它很强，但是它很难理解人类不同类型指令中蕴含的不同意图，也很难判断生成内容是否是高质量的结果。为了让GPT3.5初步具备理解指令中蕴含的意图，首先会从测试用户提交的prompt(就是指令或问题)中随机抽取一批，靠专业的标注人员，给出指定prompt的高质量答案，然后用这些人工标注好的&lt;prompt,answer&gt;数据来Fine-tune GPT 3.5模型。经过这个过程，我们可以认为GPT 3.5初步具备了理解人类prompt中所包含意图，并根据这个意图给出相对高质量回答的能力，但是很明显，仅仅这样做是不够的。</li><li>第二阶段：训练回报模型（Reward Model,RM）。这个阶段的主要目的是通过人工标注训练数据，来训练回报模型。具体而言，随机抽样一批用户提交的prompt(大部分和第一阶段的相同)，使用第一阶段Fine-tune好的冷启动模型，对于每个prompt，由冷启动模型生成K个不同的回答，于是模型产生出了&lt;prompt,answer1&gt;,&lt;prompt,answer2&gt;….&lt;prompt,answerK&gt;数据。之后，标注人员对K个结果按照很多标准（上面提到的相关性、富含信息性、有害信息等诸多标准）综合考虑进行排序，给出K个结果的排名顺序，这就是此阶段人工标注的数据。</li></ol><p>接下来，我们准备利用这个排序结果数据来训练回报模型，采取的训练模式其实就是平常经常用到的pair-wise learning to rank。对于K个排序结果，两两组合，形成<img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/equation_11.pdf" alt="equation_11.pdf">个训练数据对，ChatGPT采取pair-wise loss来训练Reward Model。RM模型接受一个输入&lt;prompt,answer&gt;，给出评价回答质量高低的回报分数Score。对于一对训练数据&lt;answer1,answer2&gt;，我们假设人工排序中answer1排在answer2前面，那么Loss函数则鼓励RM模型对&lt;prompt,answer1&gt;的打分要比&lt;prompt,answer2&gt;的打分要高，常用的margin loss。</p><p>归纳下：在这个阶段里，首先由冷启动后的监督策略模型为每个prompt产生K个结果，人工根据结果质量由高到低排序，以此作为训练数据，通过pair-wise learning to rank模式来训练回报模型。对于学好的RM模型来说，输入&lt;prompt,answer&gt;，输出结果的质量得分，得分越高说明产生的回答质量越高。</p><ol><li>采用强化学习来增强预训练模型的能力。本阶段无需人工标注数据，而是利用上一阶段学好的RM模型，靠RM打分结果来更新预训练模型参数。具体而言，首先，从用户提交的prompt里随机采样一批新的命令（指的是和第一第二阶段不同的新的prompt，这个其实是很重要的，对于提升LLM模型理解instruct指令的泛化能力很有帮助），且由冷启动模型来初始化PPO模型的参数。然后，对于随机抽取的prompt，使用PPO模型生成回答answer， 并用上一阶段训练好的RM模型给出answer质量评估的回报分数score，这个回报分数就是RM赋予给整个回答（由单词序列构成）的整体reward。有了单词序列的最终回报，就可以把每个单词看作一个时间步，把reward由后往前依次传递，由此产生的策略梯度可以更新PPO模型参数。这是标准的强化学习过程，目的是训练LLM产生高reward的答案，也即是产生符合RM标准的高质量回答。</li></ol><p>BERT</p><p>博客链接：</p><pre><code>张俊林：从word embedding到Bert  &lt;https://zhuanlan.zhihu.com/p/49271699&gt; </code></pre><p>按照ELMO-&gt;GPT1-&gt;BERT的顺序，终于来到了BERT，BERT可以看成是EMMO和GPT1的合成体，特征抽取器采用GPT1相同的Transformer；预训练的时候采用ELMO相同的双向语言模型。它和GPT的训练范式是完全一致的，都是预训练+finetune的方式。</p><p>要说的是，BERT和后续的变种是目前NLU的首选，在上面GPT里面对BERT进行了一些说明，这里进行详细的说一下。</p><ul><li><p>预训练：</p></li><li><ul><li>1）MLM任务。就是随便盖住一个单词来预测，使用contex-before和contex-after来预测这个单词，这等价于双向语言模型，MLM是BERT的根本。BERT中MLM的的实现方式选择15%的token，其中的80%替换成MASK，10%替换成一个随机token，10%保持不动。</li><li>2）NSP 是否是下一句。判断两句是否相连的二分类问题，第二个句子是不是真的是第一个句子的后续句子，增加这个任务有助于下游句子关系判断任务。</li></ul></li><li><p>网络结构：全连的网络结构（与GPT1比较），每个token能看到整个sequence的信息。</p></li><li><p>输入向量：词向量，段落（segment）向量与位置（position）向量。与transformer不同的是，这些向量都要模型学习。</p></li><li><p>输入的格式：输入的格式的变化。增加了[cls]与[sep]。</p></li></ul><table><thead><tr><th>训练范式： stage1: 预训练：NSP+MLM stage2: 下游微调</th><th><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_12.png" alt="pastedGraphic_12.png"></th></tr></thead><tbody><tr><td>输入格式： token_emb+seg_emb+pos_emb</td><td><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_13.png" alt="pastedGraphic_13.png"></td></tr><tr><td>下游任务： 左上：句子关系任务 右上：单句子分类，情感分析 左下：阅读理解任务 右下：序列标注任务</td><td><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_14.png" alt="pastedGraphic_14.png"></td></tr></tbody></table><p><strong>BERT为什么有效？</strong></p><table><thead><tr><th></th></tr></thead><tbody><tr><td><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_15.png" alt="pastedGraphic_15.png"></td></tr></tbody></table><p>对比实验可以看出来，跟GPT相比，双向语言模型起到了最主要的作用，对于那些需要看到下文的任务来说尤其如此。而NSP预测下个句子来说对整体性能来说影响不算太大，跟具体任务关联度比较高。</p><p><strong>BERT的意义和评价</strong></p><p>BERT是一个里程碑式的工作，是对历史工作的集大成者，在工业界有深远影响，集成了EMLO和GPT的优点，提出了MLM和NSP的预训练任务，并且MLM目前已经是NLP预训练中的一个必选任务。</p><p>Bert最大的亮点在于效果好及普适性强，几乎所有NLP任务都可以套用Bert这种两阶段解决思路，而且效果应该会有明显提升。</p><p>XL-Net</p><p>论文链接：</p><p>代码链接：</p><p>博客链接：<a href="https://zhuanlan.zhihu.com/p/70257427">https://zhuanlan.zhihu.com/p/70257427</a></p><p>Bert使用双向语言模型在NLP中取得了巨大的成就，但是Bert的自编码语言模型也有对应的缺点，就是XLNet在文中指出的。</p><ol><li>预训练阶段因为采取引入[Mask]标记来Mask掉部分单词的训练模式，而Fine-tuning阶段是看不到这种被强行加入的Mask标记的，所以两个阶段存在使用模式不一致的情形，这可能会带来一定的性能损失；</li><li>Bert在第一个预训练阶段，假设句子中多个单词被Mask掉，这些被Mask掉的单词之间没有任何关系，是条件独立的，而有时候这些单词之间是有关系的。</li></ol><p>上述两点是XLNet要解决的问题。</p><p><strong>Permutation Language Model：context before中引入context after</strong></p><p>在Bert中使用双向语言模型+MLM的方式引入context before和after信息，XLNet中通过任务设计在单向语言模型中，将context before中引入context after信息。</p><p>XLNet中是怎么引入这个信息的呢？</p><p>假如一个句是x1,x2,x3,…,xi,…,xn，xi的选取方式，如何在保持left2right的形式的前提下将xi之后的内容引入到xi的前面呢？在除xi之外中随机选择i-1条数据，将在这部分数据挪到xi前面，将没被选上的数据mask掉。这样在输入的数据形式上还是从左到右的形式，并且将context after的数据挪到了context before中。这里不禁有个疑问，after的信息挪到了before中，before的信息肯定是丢了一些的，并且由于是随机选择，丢失和新增的信息是不可控的。</p><p>实现方式：Attention mask来实现，输入的数据形式保持不变，通过使用Attention mask来实现不同的token可以看到的范围。</p><p>举例说明，输入原始数据是x1,x2,x3,x4，随机random之后的数据可以看成x3,x2,x4,x1，如果用这个例子用来从左到右训练LM，意味着当预测x2的时候，它只能看到上文x3；当预测x4的时候，只能看到上文x3和x2，以此类推……这样，比如对于x2来说，就看到了下文x3了。这种在输入侧维持表面的x句子单词顺序，但是其实在Transformer内部，看到的已经是被重新排列组合后的顺序，是通过Attention掩码来实现的。</p><p>RoBERTa</p><p>论文链接：<a href="https://arxiv.org/pdf/1907.11692.pdf">https://arxiv.org/pdf/1907.11692.pdf</a></p><p>代码链接：</p><p>博客链接：</p><p>可以认为RoBERTa是一个调优的Bert，可以看成Bert优化指南，这些改动对后续的模型研究都有一定的启发，主要的改动有如下。</p><p><strong>创新点</strong></p><ul><li>修改了超参，将adam中的参数beta从0.999改为了0.98；</li><li>加入了混合精度训练；</li><li>加大了batchsize，从Bert的256改为2k，训练步数从1M降到500K；</li><li>去掉了NSP任务，这个任务用处不大；</li><li>BERT的MLM静态MASK改成了动态MASK；</li><li>在更长的语料上进行训练，包含更多得到语义信息；</li><li>延长训练时间或者增加训练步数能改善模型效果；</li><li>增加新的预训练数据，数据规模从16G到64G，能改善模型效果；</li><li>更大byte-level的BEP词表</li></ul><p><strong>MLM Static vs Dynamic</strong></p><p>在BERT-MLM中，每个样本复制了10遍，并且进行10次不同的mask，训练40个epoch，这样模型对每个样本见过10次不同方式的mask形式；在RoBERTa中，每个样本在喂进模型的时候进行随机mask，在数据量大或者跑的步数多的时候，这个方式很有效。</p><table><thead><tr><th>MLM dynamic 对比static在各种验证集上指标均提升</th><th><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_16.png" alt="pastedGraphic_16.png"></th></tr></thead><tbody><tr><td></td><td></td></tr></tbody></table><p><strong>NSP任务的有效性？</strong></p><p>在bert中NSP任务判断两句话是不是连续的一句话，正例是从文章中挑选的连续的两句话，负例是从不同的文章中挑选的两句话。在训练数据中50%的句子是连续的话，剩下的50%的句子是负例。为了判断NSP任务是否对模型的效率有所提升，RoBERTa进行了多种实验。</p><ul><li><ul><li>SEGMENT-PAIR+NSP：传统的Bert的输入和NSP任务，每一对Pair的长度都小于512；</li><li>SENTENCE-PAIR+NSP：输入和Bert相同，每一对Pair的长度远小于512，增大batchsize，使token数与segment-pair基本一致；</li><li>FULL-SENTENCES：不会截断句子，句子的边界可能会跨过Document，不采用NSP Loss</li><li>DOC-SENTENCES：数据和Full-Sentence类似，句子不会超过Document，不采用NSP Loss，调整batch size大小，使token数与full-sentence一致 。</li></ul></li></ul><table><thead><tr><th>sentence-pair对比segment-pair：单个句子缺少长距离依赖的学习，下游任务有损； doc-sentence对比segment-pair：去掉NSP后对下游指标有提升 doc-sentence对比full-sentence：动态调整的batchsize对任务有益</th><th><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_17.png" alt="pastedGraphic_17.png"></th></tr></thead><tbody><tr><td></td><td></td></tr></tbody></table><p>总结：NSP对下游任务帮助不大，可以去掉了，在后续的Albert中NSP就被下掉了，并提出了新的SOP任务。</p><p><strong>batchsize的影响</strong></p><p>更大的batch可以提高模型的训练速度和下游任务的效率？在论文中给出了实验，</p><table><thead><tr><th>不同的bsz和step配比，对应的模型见过的数据量是基本一致的，指标上bsz&#x3D;2k，step&#x3D;125k的时候表现做好。 bsz增到到8K，指标下降了，这个结论是稳定的吗？</th><th><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_18.png" alt="pastedGraphic_18.png"></th></tr></thead><tbody><tr><td></td><td></td></tr></tbody></table><p>XLMR</p><p>Facebook的多语种预训练模型，</p><p>ALBERT</p><p>论文链接：<a href="https://arxiv.org/abs/1909.11942">ALBERT: A LITE BERT FOR SELF-SUPERVISED LEARNING OF LANGUAGE REPRESENTATIONS</a> </p><p>代码链接：<a href="https://github.com/google-research/albert">https://github.com/google-research/albert</a> <a href="https://github.com/albertlauncher/albert">https://github.com/albertlauncher/albert</a> <a href="https://github.com/brightmart/albert_zh">https://github.com/brightmart/albert_zh</a> </p><p>博客链接：<a href="https://www.zhihu.com/question/347898375">https://www.zhihu.com/question/347898375</a> </p><p>代码链接</p><p>Albert可以理解成，成功瘦身并且更健康的bert，参数量变小了，效果变好了。</p><table><thead><tr><th>Albert的large,xlarge参数量少于Bert-base,效果持平或者更好 Albert-xxlarge对比Bert-large，参数减少30%，指标提升3个点。</th><th><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_19.png" alt="pastedGraphic_19.png"> <img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_20.png" alt="pastedGraphic_20.png"></th></tr></thead><tbody><tr><td></td><td></td></tr></tbody></table><p><strong>创新点</strong></p><ol><li>缩小了词表的维度，参数略微减少，性能有损；</li><li>transformer内所有参数共享极大降低训练参数，对inference效率没啥影响，减参数不减计算。</li><li>SOP任务，将BERT中NSP进行了升级，将负样本换成了同一篇文章中的两个逆序的句子，消除“topic prediction”，性能提升，NSP算是寿终正寝了；</li><li>segments pair，数据中包含更多长句子，对性能有提升；</li><li>Masked-ngarm-LM，使用ngram替换mlm，更长的句子的mask，提高了任务难度，对性能有提升；</li><li>模型结构“高瘦”变成“矮胖”，再加上参数共享，性能会得到提升。</li></ol><p><strong>减小词表维度的影响</strong></p><p>在bert中词表的维度和transformer的隐藏层维度一致的，随着训练词表的规模变大，词表的参数量膨胀明显，此外，我们的预训练是为了训练和强化transformer的能力，并不是为了获得词表的embedding，词表的维度搞太高是意义不大的，所以这里搞了一个矩阵分解，简单说就是词表维度设为A，加一个全连接，转成维度B输入tf，这里A&lt;B，如此降低了embedding的维度。</p><p>结合实验指标来看，ALBERT base not shared模型下，E从128降低到64，参数量从89M降到87M，减少了不足2%，指标从81.7降低到81.3。</p><p>结论：缩小词表维度，减少了一些模型参数，但是并不多，但是性能下降了。</p><table><thead><tr><th>Albert中不同的embedding维度对指标和参数量的影响  E从128到64，参数量89-&gt;87，效果掉点81.7-&gt;81.3 E对参数量影响不大，性能存在掉点线性</th><th><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_21.png" alt="pastedGraphic_21.png"></th></tr></thead><tbody><tr><td></td><td></td></tr></tbody></table><p><strong>TF参数共享的影响-参数变少但掉点</strong></p><p>论文中开展了3个对比实验：只对attention共享，只对FFN共享 ，全部参数共享。</p><p>结合实验指标，ALBERT base并且E&#x3D;128的参数下，all-shared对比not shared，参数为12M和89M，权重共享带来了参数量86%的减少，此外，观看指标not shared对比 shared-attention也有32%的参数量减少，并且在指标上并没有掉点的情况，但是这个配置在E&#x3D;768的时候存在掉点，所以不能作为一个确切的结论。参数缩减的幅度相比于词表维度带来了更多的影响。但是论文中作者还是选择了all-shared这个配置，这个配置下参数下降最多，但是掉点了，作者为了把指标拉上来，将large升级到了xxlarge，进一步加大tf的维度，把参数量又拉上去了，但是还是比bert要小。</p><p>结论：参数共享极大减少了参数量，但是掉点，参数共享的时候E变小并没有掉点。</p><table><thead><tr><th>all-shared相比not-shared参数减少86% shared条件下，E减小并不影响指标 not shared条件小，E减小存在掉点</th><th><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_22.png" alt="pastedGraphic_22.png"></th></tr></thead><tbody><tr><td></td><td></td></tr></tbody></table><p><strong>SOP的影响-涨点</strong></p><p>SOP&#x3D;sentence order prediction，Bert中的NSP任务预测的是第二个句子是否是第一个句子的下一句，负例用的是随机负例，这个任务对模型来说，因为负例太简单了，随机选一个负例的句子，两个句子属于同一个主题语义的可能性很小，模型只需要判断两个句子不是一个主题，大概率就能分对。SOP就是增大难度的NSP，将负样本换成了同一个文章中的两个逆序的句子，这样选择的样本，满足主题语义一致的条件，消除了NSP任务中存在的“topic prediction”情况。</p><table><thead><tr><th>NSP对比None，有0.2%优势，优势很小 SOP比NSP更靠谱，有1个点优势</th><th><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_23.png" alt="pastedGraphic_23.png"></th></tr></thead><tbody><tr><td></td><td></td></tr></tbody></table><p>通过论文中重点介绍的这3种搞法，模型实际上是掉点的，那么怎么把指标拉上来的呢？这里说的指标是BERT-large对比ALBERT-xxlarge</p><p><strong>segment-pairs的影响</strong></p><table><thead><tr><th>数据对比：  Bert中90%的情况长度为128，10%为512 AlBert中90%的情况长度为512  AlBert有更多的语义训练</th><th><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_24.png" alt="pastedGraphic_24.png"></th></tr></thead><tbody><tr><td>RoBERTa实验结论： 在nsp任务中，更长的文本有更多的语义信息，带来更多指标提升</td><td><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_25.png" alt="pastedGraphic_25.png"></td></tr></tbody></table><p>结论：Albert训练的时候用了更多的语义信息，结合Roberta的结论，更多的语义信息对模型性能提升有帮助。</p><p><strong>Msked-Ngram—LM</strong></p><p>Bert中MLM是随机选择15%的token，再从里面选择80%进行mask，10%替换 ，10%不变。Albert中用的是n-gram片段，包含更完整的语义信息。</p><table><thead><tr><th>n-gram最大为3 根据公式1-gram，2-gram，3-gram对应的概率是6&#x2F;11，3&#x2F;11，2&#x2F;11，越长被mask的概率越小，符合常理</th><th><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_26.png" alt="pastedGraphic_26.png"></th></tr></thead><tbody><tr><td></td><td></td></tr></tbody></table><p>此外，根据MacBert中给出的结论：“N-gram mask 在文本分类任务中似乎更有效，而阅读理解任务的性能似乎从相似的单词中受益更多”，from <a href="https://www.qin.news/mask/">https://www.qin.news/mask/</a> </p><p><strong>模型规模和结构</strong></p><table><thead><tr><th>Albert的large,xlarge参数量少于Bert-base,效果持平或者更好 Albert-xxlarge对比Bert-large，参数减少30%，指标提升3个点。 吞吐速度，bert-large为基准，Albert-xxlarge为0.3，速度慢了3倍 图3所示，同样的训练时间，Albert-xxlarge的指标好于Bert-large 图4所示，在标准任务上，Albert指标最优</th><th><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_19.png" alt="pastedGraphic_19.png"><img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_20.png" alt="pastedGraphic_20.png"> <img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_27.png" alt="pastedGraphic_27.png"> <img src="/var/folders/2h/0049prkd1b148x_ffgbq2c400000gn/T/abnerworks.Typora/42B94118-C73E-4B3D-A420-4A0D53ED71DE/pastedGraphic_28.png" alt="pastedGraphic_28.png"></th></tr></thead><tbody><tr><td></td><td></td></tr></tbody></table><ul><li>模型参数和性能上</li></ul><p>Albert对比Bert，获得优势的是Albert-xxlarge和Bert-large，参数对比为235M和334M，参数减少了30%，平均指标85.2%提升到88.7%。</p><ul><li>模型结构上</li></ul><p>Bert-large的结构是24层1024维度的，Albert-xxlarge结构是12层4096维度，也就是“瘦高”结构变为了“矮胖”结构</p><ul><li>运算速度上</li></ul><p>对比bert-large，Albert-xxlarge速度变慢了3倍，也就是跑同样的step，Albert需要3倍的时间，这里显然无法说明Albert是一个“Lite”模型，论文中又做了进一步的实验，就是在训练时间差不多的时候，Ablert-xxlarg的性能是88.7%好于Bert-large的87.2。</p><ul><li>标准1M训练步数表现</li></ul><p>在标准的1M训练步数上，Albert指标对比Bert，RoBERTa，XLNet提升，此外，屠榜的是1.5M下的Albert模型。</p><p>DeBERTA</p><p>BART</p><p>是一个seq2seq模型，包含encoder和decoder，encoder是bert，decoder是GPT，双向语言生成模型。</p><p>T5：Transfer Text-to-Text Transformer </p><p>代码链接：<a href="https://github.com/google-research/text-to-text-transfer-transformer">https://github.com/google-research/text-to-text-transfer-transformer</a> </p><pre><code>    &lt;https://huggingface.co/docs/transformers/model_doc/t5&gt; </code></pre><p>博客链接：<a href="https://zhuanlan.zhihu.com/p/88438851">https://zhuanlan.zhihu.com/p/88438851</a> </p><p><strong>结论</strong></p><ol><li>统一的NLP预训练任务框，都转成text-to-text任务形式，GPT2的提出的路子；</li><li>encoder-decoder的transformer模型结构；</li><li>bert-style形式的任务设计，mask一部分，任务是还原出来</li><li>MLM使用replace span方式， Mask法中相邻 [M] 都合成了一个特殊符，每一小段替换一个特殊符，提高计算效率，SpanBERT也验证过了</li><li>MLM的破坏比例选择15%</li><li>replace span的长度选择3表现最好</li></ol><p>ChatGPT </p><p>参考文献</p><p>blog-<a href="https://openai.com/blog/chatgpt/">https://openai.com/blog/chatgpt/</a></p><p>blog-beit: <a href="https://www.qbitai.com/2022/08/37270.html">https://www.qbitai.com/2022/08/37270.html</a></p><p>blog 从 One-Hot 到 ChatGPT -<a href="https://juejin.cn/post/7188876269281345594">https://juejin.cn/post/7188876269281345594</a> </p><p>blog 预训练进展：<a href="https://zhuanlan.zhihu.com/p/254821426">https://zhuanlan.zhihu.com/p/254821426</a> </p><p>blog mask in nlp: <a href="https://www.qin.news/mask/">https://www.qin.news/mask/</a> </p><h3 id="BEIT3"><a href="#BEIT3" class="headerlink" title="BEIT3"></a>BEIT3</h3><p>BEIT3可以按照BEIT-&gt;BEIT2-&gt;VLMO-&gt;BEITV3顺序看。在 BEIT3中，就像题目说的那样，把图片当做语言来用。</p><p><img src="/beit3-model.png" alt="BEIT3-MODEL"></p><p>在BEIT3中，核心内容有如下几点：</p><ol><li>提出了一个统一的多模模型框架；适配不同的下游任务</li><li>借鉴了VLMO的模型设计，共享MHA，使用FFN-Expert的方式</li><li>将图片当做语言来看，去掉了之前的各种多模任务，只保留了mask modeling任务，这样简化了复杂度，避免了多个Loss之间的权重调参和为了计算各种loss要进行多次forward的问题</li><li>数据并不是越大越好，数据质量的作用非常重要，比COCA的数据规模少，但是指标要好。</li></ol><h2 id="生成模型"><a href="#生成模型" class="headerlink" title="生成模型"></a>生成模型</h2><h3 id="DALL-E系列"><a href="#DALL-E系列" class="headerlink" title="DALL.E系列"></a>DALL.E系列</h3><h2 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h2><p>在深度学习领域，哪些部分会影响模型的效果呢，经过这几年的学习和积累，总结为这几个方向：</p><ol><li>更高的数据质量，更大的数据规模，已经被多种模型和对比实验反复验证的策略<ul><li>比如T5的数据筛选，ALBEF的动量蒸馏，BLIP的capfit策略</li><li>这是一个长久并且非常重要的方向，因为随着业务的开展会发现数据才是王道。</li></ul></li><li>增大模型的容量和复杂度<ul><li>比如bert larg，T5让模型更深，albert让模型更宽到4096维度</li><li>在业务中先把模型做的更大更深，拿到更高的性能，然后再进行模型蒸馏，就是这个思路</li></ul></li><li>更充分的预训练，Roberta训练的batchsize变大，步数增加<ul><li>这可以看成是一个训练策略了，为了对比模型或策略是否有效，在学术界或工业界一般采用的都是固定的训练配置，这里不过多赘述</li><li>业务中训练多少步，bsz多大要有对比实验来支撑。</li></ul></li><li>有难度或合理的的训练任务<ul><li>NLP方向中有albert的sop，Roberta的动态mlm，spanbert的replace span策略</li><li>多模方向中有ALBEF的ITC、ITM，BEIT的MIM等任务设计</li></ul></li></ol><p>具体到多模态领域，还有一个方向是多模统一框架模型，目前业界的共识是，多模态应该有一个统一的foundation model，它可以cover不同的模态，并能适配不同的下游任务，这个方向是有VLMO，Perceiver-IO，BEIT3。</p>]]>
    </content>
    <id>https://xiaofengshi.com/2023/02/10/%E6%88%AA%E6%AD%A22022%E5%A4%9A%E6%A8%A1%E6%80%81%E8%BF%9B%E5%B1%95/</id>
    <link href="https://xiaofengshi.com/2023/02/10/%E6%88%AA%E6%AD%A22022%E5%A4%9A%E6%A8%A1%E6%80%81%E8%BF%9B%E5%B1%95/"/>
    <published>2023-02-10T19:30:05.000Z</published>
    <summary>
      <![CDATA[<p>从2020年8月左右开始接触多模态，当时也是业界多模态刚起步的阶段，到现在为止，经过了两年半左右的时间，多模态也经历了一系列的发展和工业界应用，这里进行一下总结回顾。</p>
<img src="/2023/02/10/%E6%88%AA%E6%AD%A22022%E5%A4%9A%E6%A8%A1%E6%80%81%E8%BF%9B%E5%B1%95/mm-overview2022.jpg" class="" title="mm-overview2022">]]>
    </summary>
    <title>截止2022多模态进展</title>
    <updated>2023-02-15T16:19:04.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Xiaofeng Shi</name>
    </author>
    <category term="图像检索" scheme="https://xiaofengshi.com/categories/%E5%9B%BE%E5%83%8F%E6%A3%80%E7%B4%A2/"/>
    <category term="度量学习" scheme="https://xiaofengshi.com/tags/%E5%BA%A6%E9%87%8F%E5%AD%A6%E4%B9%A0/"/>
    <content>
      <![CDATA[<p>最近和同学@liguoqing.sant有聊到图像检索相关方面的工作，主要是这么一篇论文 <a href="https://arxiv.org/abs/1709.01353">Learning Non-Metric Visual Similarity for Image Retrieval</a>，本篇文章主要结合个人理解来记录一下这篇论文。</p><img src="/2020/06/03/%E5%9B%BE%E5%83%8F%E6%A3%80%E7%B4%A2-None_Metric/metric_and_non_metric.png" class=""><p>如图，左侧是我们常用的度量学习方法，右侧是本论文提出来的使用一个similarity-network来代替常用的线性度量方程。</p><span id="more"></span><p>在进行图像检索的时候，一般是通过query图像和doc图像之间的相似度来进行检索。这里的样本之间相似度的度量方式可以认为是一种metric，一般使用余弦距离，或者欧式距离来表示相似度，这种计算样本之间相似度的方法是线性的。</p><p>在说Non-Metric之前，先说一下什么是metric-learning。</p><h2 id="Metric-learning"><a href="#Metric-learning" class="headerlink" title="Metric learning"></a>Metric learning</h2><p>关于度量学习，在知乎或者csdn上面都有不少的资料<a href="https://blog.csdn.net/JNingWei/article/details/80641184">机器学习: Metric Learning (度量学习)</a>,<a href="https://zhuanlan.zhihu.com/p/68200241">Deep Metric Learning</a>，简单来说度量学习就是学习一个度量相似度的函数，最终的目标是相似的目标离得近,不相似的离得远。就像开篇那副图左侧那样，通过cnn抽取图像特征，使用cosine或者euclidean的方式计算样本对的相似度。</p><p>基于pair&#x2F;triplet方式的triplet-loss，center-loss或者contrast-loss以及基于softmax的arceface-loss, circle-loss等都是在metric learning的基础上设计的loss，优化的目标更多的是特征提取网络。</p><h2 id="Non-Metric"><a href="#Non-Metric" class="headerlink" title="Non Metric"></a>Non Metric</h2><p>这里的这个论文是一种非线性的Non-Metric的方法来计算样本之间的相似度。</p><p>看完论文之后，这篇论文的的设计思路比较有意思，使用一个similarity-network来代替cos_distance或者euclidean_metric的方式来计算输入样本对之间的相似度，这个similarit-network的参数是可学习的。之所以这么设计是因为在计算样本对相似度的时候，我们从人的角度出发，一般情况下对样本对的相似度的要求是</p><ol><li>非负性，d(a,b)&gt;&#x3D;0</li><li>等价性，d(a,b)&#x3D;0 等价于 a&#x3D;b</li><li>交换性，d(a,b)&#x3D;d(b,a)</li><li>三角不等性，d(a,b)&lt;&#x3D;d(a,c)+d(b,c)</li></ol><p>我们平时使用的相似度度量方式，不论是cosine还是euclidean的方式，都或多或少的不满足上面的四个要求。这也是这一篇文章的设计原因，既然现在的相似度度量方法和我们认为的相似度不太一致，那直接搞一个网络来计算两个样本的相似度岂不美哉，还省了很多的推导和公式设计。</p><p>本篇中所说的similarity-network就是一个输出维度为1的全连接网络，并且这里使用的除了最后一层，其余层全部使用的relu激活函数，之所以使用relu，一个是为了使得特征稀疏，一定程度提升模型的鲁棒性，另一个感觉是基于上面非负性要求的设计。</p><h2 id="训练方法"><a href="#训练方法" class="headerlink" title="训练方法"></a>训练方法</h2><p>训练的过程如下</p><ol><li><p>预训练的CNN网络提取图片特征，这一部分权重固定 </p></li><li><p>将一个pair的feature进行拼接，拼接的维度是[Batch,dimx2]</p></li><li><p>两层全连接层，中间的激活函数是Relu，最终输出维度为1</p></li><li><p>Loss设计<br><span class="katex-display" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML" display="block"><semantics><mtable rowspacing="0.25em" columnalign="right" columnspacing=""><mtr><mtd><mstyle scriptlevel="0" displaystyle="true"><mrow><mi mathvariant="script">L</mi><mrow><mo fence="true">(</mo><msub><mi>I</mi><mi>i</mi></msub><mo separator="true">,</mo><msub><mi>I</mi><mi>j</mi></msub><mo fence="true">)</mo></mrow><mo>&#x3D;</mo><mi mathvariant="normal">∣</mi><msub><mi>s</mi><mrow><mi>i</mi><mo separator="true">,</mo><mi>j</mi></mrow></msub><mo>−</mo><msub><mi mathvariant="normal">ℓ</mi><mrow><mi>i</mi><mo separator="true">,</mo><mi>j</mi></mrow></msub><mrow><mo fence="true">(</mo><mi mathvariant="normal">sim</mi><mo>⁡</mo><mrow><mo fence="true">(</mo><msub><mi>x</mi><mi>i</mi></msub><mo separator="true">,</mo><msub><mi>x</mi><mi>j</mi></msub><mo fence="true">)</mo></mrow><mo>+</mo><mi mathvariant="normal">Δ</mi><mo fence="true">)</mo></mrow></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="true"><mrow><mo>−</mo><mrow><mo fence="true">(</mo><mn>1</mn><mo>−</mo><msub><mi mathvariant="normal">ℓ</mi><mrow><mi>i</mi><mo separator="true">,</mo><mi>j</mi></mrow></msub><mo fence="true">)</mo></mrow><mrow><mo fence="true">(</mo><mi mathvariant="normal">sim</mi><mo>⁡</mo><mrow><mo fence="true">(</mo><msub><mi>x</mi><mi>i</mi></msub><mo separator="true">,</mo><msub><mi>x</mi><mi>j</mi></msub><mo fence="true">)</mo></mrow><mo>−</mo><mi mathvariant="normal">Δ</mi><mo fence="true">)</mo></mrow></mrow></mstyle></mtd></mtr></mtable></semantics></math></span></span><br>其中<br><span class="math-render-error" role="note">Formula rendering unavailable: <code>\ell_&#123;i, j&#125;=\left&#123;\begin&#123;array&#125;&#123;ll&#125;1 &amp; \text &#123; if &#125; I_&#123;i&#125; \text &#123; and &#125; I_&#123;j&#125; \text &#123; are similar &#125; \ 0 &amp; \text &#123; otherwise &#125;\end&#123;array&#125;\right.$</code></span></p><ol><li>Label: 根据CNN特征和标注数据来确定label<ol><li>如果标注当前pair相似，那么在cos(emb1,emb2)的基础上加上margin，让相似的相似度更高</li><li>如果标注当前pair不相似，那么在cos(emb1,emb2)的基础上减去margin，让不相似的相似度更低</li></ol></li><li>使用FC输出的logits来回归label，使用MSE损失</li></ol></li></ol><p>网络设计的很简单，解决的任务也很简单，就是用这个similarity-network代替cosine&#x2F;euclidean的方式，来计算样本之间的相似度，用这个相似度来进行图像检索。</p><h2 id="思考"><a href="#思考" class="headerlink" title="思考"></a>思考</h2><p>看这篇文章的时候，刚开始没太明白，以为这是一种可以替代triplet-loss或者pair_loss的的新的训练网络的方法，看到后面明白本论文解决的是特征之间度量的问题。</p><p>###解决什么问题？</p><p>在平常进行图像检索或者reid领域，实际上很重要的一点是设计更高效的loss来训练特征提取网路，如果这个网络训练好了，一般直接使用cosine的方式或者归一化向量內积的方式来表征不同样本之间的相似度。这篇文章解决的就是CNN网络训练好了之后的事情。</p><h3 id="论文实验对比公平吗？"><a href="#论文实验对比公平吗？" class="headerlink" title="论文实验对比公平吗？"></a>论文实验对比公平吗？</h3><p>先说结论，个人感觉论文中的结果对比是不公平的。</p><p>这篇文章给出了一个很有意思的结论，当similarity-network训练的数据比较好的时候，对比cosine优势明显，当训练数据不太好的时候，那么cosine是更好的选择。</p><p>consine可以看成是一个线性变换，就是一个简单的公式，而这个网络使用的使用了两个特征拼接经过FC再回归计算loss的方式，个人感觉这种对比方式是不公平的。</p><ol><li>consine的方式在测试的时候是不需要训练的，而similarity-network需要训练，不管在什么数据集上，在训练集训练，在测试集测试，这个时候similarity-network是见过类似的数据的，这样直接对比consine是不公平的，应该使用同样的方式，给cosine的也引入两个fc层，并且在同样的数据进行训练，只不过换成直接优化cosine的方式，个人感觉这样才相对公平。</li><li>Loss设计的时候使用的cosine和margin，对比的目标是cosine，这个天然就是不合理的。</li></ol><h3 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h3><ol><li>在工业界similarity-network的设计思路可以相对更快速适配新的检索特征。</li><li>在学术界这有可能被当成一篇灌水文章。</li><li>模型设计很简单，参数很少，没有可以学习到的trick。</li><li>探讨了不同fc的隐藏层节点数得到的结果，直白讲，节点越多结果越好，参数量越大，这个要取一个trade-off。</li></ol><p>审稿人@liguoqing.sant</p>]]>
    </content>
    <id>https://xiaofengshi.com/2020/06/03/%E5%9B%BE%E5%83%8F%E6%A3%80%E7%B4%A2-None_Metric/</id>
    <link href="https://xiaofengshi.com/2020/06/03/%E5%9B%BE%E5%83%8F%E6%A3%80%E7%B4%A2-None_Metric/"/>
    <published>2020-06-03T22:05:25.000Z</published>
    <summary>
      <![CDATA[<p>最近和同学@liguoqing.sant有聊到图像检索相关方面的工作，主要是这么一篇论文 <a href="https://arxiv.org/abs/1709.01353">Learning Non-Metric Visual Similarity for Image Retrieval</a>，本篇文章主要结合个人理解来记录一下这篇论文。</p>
<img src="/2020/06/03/%E5%9B%BE%E5%83%8F%E6%A3%80%E7%B4%A2-None_Metric/metric_and_non_metric.png" class="">

<p>如图，左侧是我们常用的度量学习方法，右侧是本论文提出来的使用一个similarity-network来代替常用的线性度量方程。</p>]]>
    </summary>
    <title>深度学习-None_Metric</title>
    <updated>2020-06-05T18:55:24.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Xiaofeng Shi</name>
    </author>
    <category term="深度学习" scheme="https://xiaofengshi.com/categories/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    <category term="Loss" scheme="https://xiaofengshi.com/categories/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/Loss/"/>
    <category term="IOU-Loss" scheme="https://xiaofengshi.com/tags/IOU-Loss/"/>
    <content>
      <![CDATA[<p>在目标检测领域，为了判断预测框和gt之间的重叠程度 ，一般情况下使用iou来表示，本篇主要分析IoU以及相关改进，主要涉及iou，giou，diou，ciou。</p><span id="more"></span><h2 id="IoU"><a href="#IoU" class="headerlink" title="IoU"></a>IoU</h2><p>IoU是Intersection over Union的缩写，顾名思义，交并比。</p><ol><li><p>优点</p><ol><li>IoU可以作为一种距离的度量，反应两个box的相交程度，衡量检测模型的效果，loss&#x3D;1-IOU。</li><li>IoU 对尺度变化具有不变性，不受两个物体尺度大小的影响。 在box回归任务中，判断predict box和gt的距离最直接的指标就是IoU。**(满足非负性；同一性；对称性；三角不等性)**</li></ol></li><li><p>缺点</p><ol><li>无法衡量两框是相邻还是甚远，针对不同的情况，模型的优化方向应该是不同的。并且当两个box不想交的时候iou&#x3D;0，这个时候没有回传的梯度，网络无法优化学习</li><li>IOU不能反映两个物体如何重叠相交的，对于相同的iou值的情况，存在着无数种相交情形，这些情况的优劣通过iou无法表述出来。</li></ol><p>上述两个方面实际是上说的是一回事，通俗的讲，通过IoU我们只能知道两个box是否有交集，但是并不知道box相交的位置和box之间的距离，如下图所示.这样从模型优化的角度来说，不利于模型想更好地方向优化。</p><img src="/2020/03/21/Loss-IOUs/iou.jpg" class="" title="IOU"><p>1. </p></li><li><p>代码</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">def</span> <span class="title function_">bboxes_iou</span>(<span class="params">boxes1,boxes2</span>):</span><br><span class="line">    <span class="string">&#x27;&#x27;&#x27;</span></span><br><span class="line"><span class="string">    cal IOU of two boxes or batch boxes</span></span><br><span class="line"><span class="string">    such as: (1)</span></span><br><span class="line"><span class="string">            boxes1 = np.asarray([[0,0,5,5],[0,0,10,10],[0,0,10,10]])</span></span><br><span class="line"><span class="string">            boxes2 = np.asarray([[0,0,5,5]])</span></span><br><span class="line"><span class="string">            and res is [1.   0.25 0.25]</span></span><br><span class="line"><span class="string">            (2)</span></span><br><span class="line"><span class="string">            boxes1 = np.asarray([[0,0,5,5],[0,0,10,10],[0,0,10,10]])</span></span><br><span class="line"><span class="string">            boxes2 = np.asarray([[0,0,5,5],[0,0,10,10],[0,0,10,10]])</span></span><br><span class="line"><span class="string">            and res is [1. 1. 1.]</span></span><br><span class="line"><span class="string">    :param boxes1:[xmin,ymin,xmax,ymax] or</span></span><br><span class="line"><span class="string">                [[xmin,ymin,xmax,ymax],[xmin,ymin,xmax,ymax],...]</span></span><br><span class="line"><span class="string">    :param boxes2:[xmin,ymin,xmax,ymax]</span></span><br><span class="line"><span class="string">    :return:</span></span><br><span class="line"><span class="string">    &#x27;&#x27;&#x27;</span></span><br><span class="line"></span><br><span class="line">    <span class="comment">#cal the box&#x27;s area of boxes1 and boxess</span></span><br><span class="line">    boxes1Area = (boxes1[...,<span class="number">2</span>]-boxes1[...,<span class="number">0</span>])*(boxes1[...,<span class="number">3</span>]-boxes1[...,<span class="number">1</span>])</span><br><span class="line">    boxes2Area = (boxes2[..., <span class="number">2</span>] - boxes2[..., <span class="number">0</span>]) * (boxes2[..., <span class="number">3</span>] - boxes2[..., <span class="number">1</span>])</span><br><span class="line"></span><br><span class="line">    <span class="comment">#cal Intersection</span></span><br><span class="line">    left_up = np.maximum(boxes1[...,:<span class="number">2</span>],boxes2[...,:<span class="number">2</span>])</span><br><span class="line">    right_down = np.minimum(boxes1[...,<span class="number">2</span>:],boxes2[...,<span class="number">2</span>:])</span><br><span class="line"></span><br><span class="line">    inter_section = np.maximum(right_down-left_up,<span class="number">0.0</span>)</span><br><span class="line">    inter_area = inter_section[...,<span class="number">0</span>] * inter_section[...,<span class="number">1</span>]</span><br><span class="line">    union_area = boxes1Area+boxes2Area-inter_area</span><br><span class="line">    ious = np.maximum(<span class="number">1.0</span>*inter_area/union_area,np.finfo(np.float32).eps)</span><br><span class="line"></span><br><span class="line">    <span class="keyword">return</span> ious</span><br><span class="line"></span><br></pre></td></tr></table></figure><h2 id="GIOU"><a href="#GIOU" class="headerlink" title="GIOU"></a>GIOU</h2><p>GIOU正是针对上面的</p></li></ol>]]>
    </content>
    <id>https://xiaofengshi.com/2020/03/21/Loss-IOUs/</id>
    <link href="https://xiaofengshi.com/2020/03/21/Loss-IOUs/"/>
    <published>2020-03-21T20:18:25.000Z</published>
    <summary>
      <![CDATA[<p>在目标检测领域，为了判断预测框和gt之间的重叠程度 ，一般情况下使用iou来表示，本篇主要分析IoU以及相关改进，主要涉及iou，giou，diou，ciou。</p>]]>
    </summary>
    <title>Loss-IOUs</title>
    <updated>2020-06-03T22:24:33.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Xiaofeng Shi</name>
    </author>
    <category term="深度学习" scheme="https://xiaofengshi.com/categories/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    <category term="Loss" scheme="https://xiaofengshi.com/categories/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/Loss/"/>
    <category term="深度学习" scheme="https://xiaofengshi.com/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    <category term="Loss" scheme="https://xiaofengshi.com/tags/Loss/"/>
    <category term="Softmax" scheme="https://xiaofengshi.com/tags/Softmax/"/>
    <content>
      <![CDATA[<p>本篇主要记录 一下softmax-loss以及相关变体，该loss的发展主要有人脸识别领域推进，本篇中主要借鉴人脸是识别中的相关Loss。</p><span id="more"></span><h2 id="Reference"><a href="#Reference" class="headerlink" title="Reference"></a>Reference</h2><ol><li><a href="https://zhuanlan.zhihu.com/p/60747096">人脸识别损失函数简介与Pytorch实现：ArcFace、SphereFace、CosFace</a></li><li><a href="https://zhuanlan.zhihu.com/p/76391405">人脸识别中Softmax-based Loss的演化史</a></li><li><a href="https://zhuanlan.zhihu.com/p/34404607">人脸识别的LOSS（上）</a></li><li><a href="https://zhuanlan.zhihu.com/p/34436551">人脸识别的LOSS（下）</a></li><li><a href="https://github.com/adambielski/siamese-triplet">Github siamese-triplet</a></li></ol>]]>
    </content>
    <id>https://xiaofengshi.com/2020/03/17/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-Loss-softmax-based/</id>
    <link href="https://xiaofengshi.com/2020/03/17/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-Loss-softmax-based/"/>
    <published>2020-03-17T22:08:21.000Z</published>
    <summary>
      <![CDATA[<p>本篇主要记录 一下softmax-loss以及相关变体，该loss的发展主要有人脸识别领域推进，本篇中主要借鉴人脸是识别中的相关Loss。</p>]]>
    </summary>
    <title>Loss-softmax-based</title>
    <updated>2020-03-17T23:16:08.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Xiaofeng Shi</name>
    </author>
    <category term="Awesomes" scheme="https://xiaofengshi.com/categories/Awesomes/"/>
    <content>
      <![CDATA[<p>本篇主要记录深度学习过程中遇到的各种bug，error以及对应的解决方法。</p><span id="more"></span><h3 id="WARNING-root-NaN-or-Inf-found-in-input-tensor"><a href="#WARNING-root-NaN-or-Inf-found-in-input-tensor" class="headerlink" title="WARNING:root:NaN or Inf found in input tensor."></a>WARNING:root:NaN or Inf found in input tensor.</h3><p>这个报错一版搜索的时候出现的是网络训练的时候Loss变为Nan的解决办法，通用的有四种</p><ol><li>降低学习率</li><li>加入正则化</li><li>进行梯度截断</li><li>检查数据</li></ol><p>我遇到的这个问题的场景是在训练一个模型<code>vlbert</code>,输入是数据包含图像和对应的图像描述，并且我的模型中包含正则化和梯度截断，因此大概率是数据的原因，下面是我进行debug的过程</p><ol><li><p>固定shuffle的种子，检查数据是否出现为nan的情况，在pytorch中，使用如下程序进行对dataset的数据进行检查</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">import</span> numpy <span class="keyword">as</span> np</span><br><span class="line"><span class="keyword">import</span> torch</span><br><span class="line"><span class="keyword">def</span> <span class="title function_">check_tensor</span>(<span class="params">self, vector, name=<span class="literal">None</span></span>):</span><br><span class="line">    <span class="keyword">try</span>:</span><br><span class="line">        <span class="keyword">if</span> <span class="built_in">isinstance</span>(vector, torch.Tensor):</span><br><span class="line">            <span class="keyword">if</span> <span class="keyword">not</span> np.<span class="built_in">any</span>(np.isnan(vector.cpu().detach().numpy())):</span><br><span class="line">                <span class="keyword">return</span> <span class="literal">True</span></span><br><span class="line">            <span class="built_in">print</span>(<span class="string">&quot;[] is false&quot;</span>.<span class="built_in">format</span>(name))</span><br><span class="line">            <span class="keyword">return</span> <span class="literal">False</span></span><br><span class="line">        <span class="keyword">elif</span> <span class="built_in">isinstance</span>(vector, np.ndarray):</span><br><span class="line">            <span class="keyword">if</span> <span class="keyword">not</span> np.<span class="built_in">any</span>(np.isnan(vector)):</span><br><span class="line">                <span class="keyword">return</span> <span class="literal">True</span></span><br><span class="line">            <span class="built_in">print</span>(<span class="string">&quot;[] is false&quot;</span>.<span class="built_in">format</span>(name))</span><br><span class="line">            <span class="keyword">return</span> <span class="literal">False</span></span><br><span class="line">        <span class="keyword">elif</span> <span class="built_in">isinstance</span>(vector, <span class="built_in">list</span>):</span><br><span class="line">            vector = np.asarray(vector, dtype=np.float32)</span><br><span class="line">            <span class="keyword">if</span> <span class="keyword">not</span> np.<span class="built_in">any</span>(np.isnan(vector)):</span><br><span class="line">                <span class="keyword">return</span> <span class="literal">True</span></span><br><span class="line">            <span class="built_in">print</span>(<span class="string">&quot;[] is false&quot;</span>.<span class="built_in">format</span>(name))</span><br><span class="line">            <span class="keyword">return</span> <span class="literal">False</span></span><br><span class="line">    <span class="keyword">except</span> Exception <span class="keyword">as</span> ex:</span><br><span class="line">        logger.error(traceback.format_exc())</span><br><span class="line">        logger.error(<span class="string">&quot;name is [&#123;&#125;] value is &#123;&#125;&quot;</span>.<span class="built_in">format</span>(name, vector))</span><br><span class="line">        <span class="keyword">return</span> <span class="literal">False</span></span><br></pre></td></tr></table></figure><p>加入了数据<code>check</code>部分，使用同样的参数配置进行再次训练，发现在上次同样的迭代次数的时候又出来了<code>nan</code>的错误，但是这一个部分的输入数据并没有触发<code>nan</code>错误</p></li><li><p>检查模型输出数据是否为<code>nan</code></p><p>在模型数据输出部分，该部分数据还没有进行<code>loss</code>计算，只检查这部分数据是否为<code>nan</code>，检查发现，在这个迭代次数出现nan错误的时候，模型的输出为<code>nan</code></p></li><li><p>调低学习率</p><p>降低学习率，实际上这个时候的学习率是很低的<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>1</mn><mi>e</mi><mo>−</mo><mn>7</mn></mrow></semantics></math></span></span>，调低到<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>1</mn><mi>e</mi><mo>−</mo><mn>10</mn></mrow></semantics></math></span></span>，这个错误还是没有解决</p></li><li><p>确信以及肯定是数据的问题，但是就是没找到问题所在</p><ol><li>在dataset的<code>__geiitem__</code>程序中记录当前的<code>index</code>，并将这个数传递到后续的模型计算过程中，这样再出现错误的时候就能根据<code>index</code>取到原始数据，再次同样参数运行程序，找到了出现问题的的这一组batch中的index是谁，因为我是使用的单机多卡训练的，因此为了保险起见，我把出现错误的前面四个batch的数据全部记录下来</li></ol></li><li><p>check数据，这一组记录的数据进行check，设置为batch&#x3D;1，发现里面有一个数据会触发nan的错误，检查这个原始数据，在原始数据中记录的是这个样本的图片的url以及对应的图片描述，为了以防万一，打开了图片链接查看，惊喜出现了 <a href="https://sf1-ttcdn-tos.pstatp.com/obj/image-pair-videos/image_text_cc_dataset_BM5B_10A2Pglobal001jpglargewid1250_157795348409_jrlVRNYLF">https://sf1-ttcdn-tos.pstatp.com/obj/image-pair-videos/image_text_cc_dataset_BM5B_10A2Pglobal001jpglargewid1250_157795348409_jrlVRNYLF</a> 这是这个样本的链接，发现这是一张不正常的图片，查看这个图片记录的其他信息为宽度&#x3D;0，高度&#x3D;0，终于找到问题了，如果图片的宽度或者高度为0，那么后续的处理过程中，因为涉及一个计算相对坐标的过程，在这个过程中，原来的绝对坐标处以这个0，直接就导致了数据为nan的错误，把这个数据删除之后一切正常了，天啦撸，太难了</p></li><li><p>这个问题debug了一天多，因为出发nan的时候在一个epoch的中间位置，一开始没有相应的记录，很难找到出错的样本，实际上针对梯度爆炸或者梯度小时的问题，开始在模型设计的时候就把该加的都加了经过这个事情，应该学会一下几点</p><ol><li>数据要清洗，针对图像数据，就要看图像是否正常，针对文本数据就要看文本是否为空</li><li>dataset中最好记录index，能进行反向追溯</li></ol></li><li></li></ol>]]>
    </content>
    <id>https://xiaofengshi.com/2020/02/25/AwesomesErrors/</id>
    <link href="https://xiaofengshi.com/2020/02/25/AwesomesErrors/"/>
    <published>2020-02-25T17:13:32.000Z</published>
    <summary>
      <![CDATA[<p>本篇主要记录深度学习过程中遇到的各种bug，error以及对应的解决方法。</p>]]>
    </summary>
    <title>AwesomesErrors</title>
    <updated>2020-02-25T19:31:48.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Xiaofeng Shi</name>
    </author>
    <category term="深度学习" scheme="https://xiaofengshi.com/categories/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    <category term="CV" scheme="https://xiaofengshi.com/categories/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/CV/"/>
    <category term="深度学习" scheme="https://xiaofengshi.com/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    <category term="ConvNet" scheme="https://xiaofengshi.com/tags/ConvNet/"/>
    <category term="CV" scheme="https://xiaofengshi.com/tags/CV/"/>
    <content>
      <![CDATA[<img src="/2020/02/17/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-SENet/SE-pipeline.jpg" class=""><p>本篇主要记录一下2017年ILSVR竞赛的冠军-SENet，这是一种网络的block结构，可以有效的结合到InceptionNet，Resnet中。</p><span id="more"></span><h2 id="Block结构"><a href="#Block结构" class="headerlink" title="Block结构"></a>Block结构</h2><p>网络结构如上图所示，图中参数解释：</p><ol><li><span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><msub><mi>F</mi><mrow><mi>t</mi><mi>r</mi></mrow></msub></mrow></semantics></math></span></span>–标准卷积操作</li><li><span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><msub><mi>F</mi><mrow><mi>s</mi><mi>q</mi></mrow></msub><mo stretchy="false">(</mo><mi mathvariant="normal">.</mi><mo stretchy="false">)</mo></mrow></semantics></math></span></span>–sequeeze操作，这一步进对输入的特征图进行GlobalPooling，特征图由<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>H</mi><mo>×</mo><mi>W</mi><mo>×</mo><mi>C</mi></mrow></semantics></math></span></span>变为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>1</mn><mo>×</mo><mn>1</mn><mo>×</mo><mi>C</mi></mrow></semantics></math></span></span></li><li><span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><msub><mi>F</mi><mrow><mi>e</mi><mi>x</mi></mrow></msub><mo stretchy="false">(</mo><mi mathvariant="normal">.</mi><mo stretchy="false">)</mo></mrow></semantics></math></span></span>–excitation操作，这一步包含两个fc全连接操作<ol><li>第一步FC-压缩维度数量，维度数由<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>C</mi></mrow></semantics></math></span></span>变为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>C</mi><mi mathvariant="normal">&#x2F;</mi><mi>r</mi></mrow></semantics></math></span></span>，Relu激活层</li><li>第二步FC-扩展维度数量，维度数由<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>C</mi><mi mathvariant="normal">&#x2F;</mi><mi>r</mi></mrow></semantics></math></span></span>变为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>C</mi></mrow></semantics></math></span></span>，Sigmoid激活层</li></ol></li><li><span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><msub><mi>F</mi><mrow><mi>s</mi><mi>c</mi><mi>a</mi><mi>l</mi><mi>e</mi></mrow></msub><mo stretchy="false">(</mo><mi mathvariant="normal">.</mi><mo stretchy="false">)</mo></mrow></semantics></math></span></span>–类似通道注意力，将得到的C维度的值作为权重乘到输入的特征图的维度上。</li></ol><h2 id="参数和结构是如何确定的"><a href="#参数和结构是如何确定的" class="headerlink" title="参数和结构是如何确定的"></a>参数和结构是如何确定的</h2><h3 id="扩展层压缩比"><a href="#扩展层压缩比" class="headerlink" title="扩展层压缩比"></a>扩展层压缩比</h3><p>在论文中，作者认为压缩比为16可以取得模型的精度和运算复杂度之间的平衡，并且作者在论文中提出，由于模型的不同层在整个模型中的作用不一样，因此，在整个模型中使用同一个固定的压缩比不是一个最好的办法，可以设置不同的压缩比以适应不同的基础网络，<strong>我们在日常使用的过程中可以先使用16，之后在模型优化的时候再通过更改压缩比来进行对比试验。</strong></p><h3 id="压缩层"><a href="#压缩层" class="headerlink" title="压缩层"></a>压缩层</h3><p>在sequeeze层中，对比研究了GlobalMaxPooling和GlobalAvgPooling，从指标身上看GlobalAvgPooling表现会更好一些，但是Maxpooling的计算更加简单，因此在模型中使用的是Maxpooling，<strong>这一步也是可以在个人实践的时候进行优化的。</strong></p><img src="/2020/02/17/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-SENet/gap-gmp.png" class=""><h3 id="扩展层计算方法"><a href="#扩展层计算方法" class="headerlink" title="扩展层计算方法"></a>扩展层计算方法</h3><p>这里主要是讨论选择什么样的激活函数，众所周知常用的激活层是Relu，Sigmoid，Tanh。可以看到Tanh相比Sigmoid表现差一点，并且使用了Relu的Se-Resnet50已经低于了Resnet50的基线表现。这一步使用什么样的激活函数是很重要的，不是想当然的认为这一步要得到0~1之间的数，所以要使用Sigmoid激活函数，任何一个网络模型的设计都是要有依据的。</p><img src="/2020/02/17/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-SENet/opreator.png" class=""><h3 id="Block结构设计"><a href="#Block结构设计" class="headerlink" title="Block结构设计"></a>Block结构设计</h3><p>为什么选择开篇图中那种Block的设计方式，论文中，作者研究了不同的网络结构设计如下</p><img src="/2020/02/17/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-SENet/se-blocks.png" class="" title="Blocks"><p>具体的表现为</p><img src="/2020/02/17/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-SENet/blocks-error.png" class=""><p>可以看出来，SE-POST表现相比是最差的。如果SE单元在分支聚合之前应用，则SE单元所产生的性能改进对其梭子的位置比较鲁棒的，表现差别不大。 </p><p>正常情况下，每个SE块都放置在残差单元的结构外部。 论文中作者还构造了一种设计变体，将SE块移动到剩余单元内，将其直接放置在3×3卷积层之后，虽然论文中作者没给出是哪种block，但是个人感觉应该是瓶颈残差模块。</p><img src="/2020/02/17/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-SENet/bottleneck-resnet-block.png" class=""><p> 由于3×3卷积层具有较少的通道，因此相应的SE块引入的参数数量会想要减少。从下面的图标可以看出来，SE3x3与标准的SE相比，在减少10%左右参数量的情况下，并没有明显降低模型的精度。 <strong>在后续优化中，通过针对特定架构量身定制SE块使用，可以进一步提高效率。</strong></p><img src="/2020/02/17/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-SENet/block-variance.png" class=""><h2 id="SEBlock各模块的作用"><a href="#SEBlock各模块的作用" class="headerlink" title="SEBlock各模块的作用"></a>SEBlock各模块的作用</h2><p>整个SEBlock中主要包含2个模块，sequence，excitation，后面的scale属于常规操作。</p><h3 id="Squeeze的作用"><a href="#Squeeze的作用" class="headerlink" title="Squeeze的作用"></a>Squeeze的作用</h3><p>在SEblock中的sequence是通过GlobalAvgpooling实现的，为了查看这一步的作用，在论文中作者做了这么一个实验。</p><ol><li>参数量固定</li><li>移除GlobalAvgpooling操作</li><li>移除两个fc层使用1x1卷积代替，保持输出的通道数与原来相同</li></ol><p>显然，去除了squeeze这一步，在SE模块中，网络无法再直接访问全局特征。在下面的图中通过对比试验，可以看出，去除掉squeeze这一步之后，为模型带了0.7个点的性能损失，并且带来了更多的计算量，而squeeze使用简单地pooling操作，既降低了计算量有带来了性能的提升。</p><img src="/2020/02/17/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-SENet/squeeze-role.png" class=""><h3 id="Excitation的作用"><a href="#Excitation的作用" class="headerlink" title="Excitation的作用"></a>Excitation的作用</h3><p>这一步很有趣，作者是通过研究分类任务上，网络不同深度上对不同类别的图像和同一类别内的变化。</p><p>这里选择了语义和外观上都有很大差异的四个类：金鱼，狗，飞机，悬崖。使用每个阶段的最后一个在降采样之前的SE模块，均匀采样50个通道，并计算着50个通道的平均值。从下面这个图可以得到两个结论</p><ol><li>在较浅的层，不同的类别之间的激活值是很相似的，这有可能是由于CNN的通道权重共享造成的，比如图中的SE2-3</li><li>随着模型深度的增加，不同类别的激活变得更加特定，这是由于不同类别的输入视觉信号和类别监督信号对特征具有不同的偏好，比如图中的SE4-6,SE5-1</li><li>SE5-2不同的类别的激活表现了趋于饱和的激活状态，在所有激活值取值为1的电商，SE则变成了一个逻辑运算符来判断0&#x2F;1</li><li>在SE5-3，后面加上globalpooling就是最后的分类层了，可以看到在不同的类别上的表现趋势很相似，并且变化不大。这表明SE5-2和SE5-3对模型的贡献已经很小了。这表明，<strong>可以通过删除这一层，也不会太影响模型的性能，但是可以显著的降低模型的参数量，也验证了随着模型深度的增加，获得的收益越来越小</strong>。</li></ol><p>实际上这个表现不是SE独有的，任何一个深度学习网络，经过研究发现，浅层特征表达浅层特征，深层特征表达高层特征。</p><img src="/2020/02/17/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-SENet/extitction-activation.png" class="" title="ActivationCurve"><p>再看一下不同类别激活值的均值和方差的分布，可以明显的看出来，不同类别的均值和方差的分布曲线和激活值的曲线是一致的。</p><img src="/2020/02/17/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-SENet/excitation-activation-standard.png" class=""><h2 id="参考文献"><a href="#参考文献" class="headerlink" title="参考文献"></a>参考文献</h2><ol><li>官方repo <a href="https://github.com/hujie-frank/SENet">https://github.com/hujie-frank/SENet</a></li><li></li></ol>]]>
    </content>
    <id>https://xiaofengshi.com/2020/02/17/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-SENet/</id>
    <link href="https://xiaofengshi.com/2020/02/17/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-SENet/"/>
    <published>2020-02-17T22:05:43.000Z</published>
    <summary>
      <![CDATA[<img src="/2020/02/17/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-SENet/SE-pipeline.jpg" class="">

<p>本篇主要记录一下2017年ILSVR竞赛的冠军-SENet，这是一种网络的block结构，可以有效的结合到InceptionNet，Resnet中。</p>]]>
    </summary>
    <title>深度学习-ConvNet-SENet</title>
    <updated>2020-02-29T15:09:34.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Xiaofeng Shi</name>
    </author>
    <category term="深度学习" scheme="https://xiaofengshi.com/categories/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    <category term="CV" scheme="https://xiaofengshi.com/categories/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/CV/"/>
    <category term="深度学习" scheme="https://xiaofengshi.com/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    <category term="ConvNet" scheme="https://xiaofengshi.com/tags/ConvNet/"/>
    <category term="CV" scheme="https://xiaofengshi.com/tags/CV/"/>
    <category term="轻量化Conv" scheme="https://xiaofengshi.com/tags/%E8%BD%BB%E9%87%8F%E5%8C%96Conv/"/>
    <content>
      <![CDATA[<p>本篇主要分析轻量化Conv-ShuffleNet</p><img src="/2020/02/09/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-ShuffleNet/shufflenetv2-block.png" class=""> <span id="more"></span><h2 id="ShuffleNetV1"><a href="#ShuffleNetV1" class="headerlink" title="ShuffleNetV1"></a>ShuffleNetV1</h2><img src="/2020/02/09/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-ShuffleNet/shufflenet-mobilenet.png" class=""><p><code>ShuffleNet</code>是<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>2017</mn></mrow></semantics></math></span></span>年由<code>Facebook</code>提出的，它的主要竞争对手是<code>Google</code>提出的<code>MobilenetV1</code>，上图作者在论文中与<code>MobileNetV1</code>在<code>ImageNet</code>的的对比。<hr></p><h3 id="Overview"><a href="#Overview" class="headerlink" title="Overview"></a>Overview</h3><p>ShuffleNet网络主要是针对的<code>Xception</code>和<code>ResNet</code>，由于<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>1</mn><mo>×</mo><mn>1</mn></mrow></semantics></math></span></span>卷积部分的计算开销在小型网络中不够理想的问题。受<code>depthwise</code>卷积的启发，每个通道都与一个卷积核进行计算，那么在<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>1</mn><mo>×</mo><mn>1</mn></mrow></semantics></math></span></span>这部分卷积中，一个很自然的方法就是，对当前的<code>featuremap</code>的通道进行分组计算，但是如果直接分组的话，就造成了不同特征的隔离，不同的组之间的特征无法交互，这样做显然会造成数据特征的丢失，效果不好。<code>ShuffleNet</code>就是针对这个问题提出的解决方案，对<code>featuremap</code>的通道进行分组进行<strong>group convolution</strong>，然后每组输出的<code>featuremap</code>进行重排<strong>channel shuffle</strong>，这样不同组的的信息由此得到交换，并没有完全隔离，能在较小计算量的情况下保持较好的精度。</p><hr> 不同featuremap分组方式对比<img src="/2020/02/09/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-ShuffleNet/comparison.png" class=""><p>图<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>a</mi></mrow></semantics></math></span></span>，是将<code>featuremap</code>的通道进行分组，显然这样会造成特征之间的隔离，输出只有一部分输入决定；图b&#x2F;c在第一步卷积后对分组的通道进行重排，这样下层的输入就会接收到上层所有<code>channel</code>的数据，效果相比图<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>a</mi></mrow></semantics></math></span></span>更好。<hr></p><p>在图c中可以看到，channelshuffle层，在进行group convolution之后，对得到的通道进行shuffle，这里的shuffle不是随机的，而是均匀的打乱。在程序上的实现方法很简单：假设将输入层分成g组，每组的数量为n，那么总的通道数为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>g</mi><mo>×</mo><mi>n</mi></mrow></semantics></math></span></span>，将通道拆成两个维度<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mo stretchy="false">(</mo><mi>g</mi><mo separator="true">,</mo><mi>n</mi><mo stretchy="false">)</mo></mrow></semantics></math></span></span>，然后将这两个维度进行转置<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mo stretchy="false">(</mo><mi>n</mi><mo separator="true">,</mo><mi>g</mi><mo stretchy="false">)</mo></mrow></semantics></math></span></span>，最后reshape成一个维度，这样得到的维度就是均匀shuffle之后的channel了，也就是图c中的channel shuffle的样子。</p><p>代码实现如下</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">class</span> <span class="title class_">ShuffleBlock</span>(nn.Module):</span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">__init__</span>(<span class="params">self, groups</span>):</span><br><span class="line">        <span class="built_in">super</span>(ShuffleBlock, self).__init__()</span><br><span class="line">        self.groups = groups</span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">forward</span>(<span class="params">self, x</span>):</span><br><span class="line">        <span class="string">&#x27;&#x27;&#x27;Channel shuffle: [N,C,H,W] -&gt; [N,g,C/g,H,W] -&gt; [N,C/g,g,H,w] -&gt; [N,C,H,W]&#x27;&#x27;&#x27;</span></span><br><span class="line">        N,C,H,W = x.size()</span><br><span class="line">        g = self.groups</span><br><span class="line">        <span class="keyword">return</span> x.view(N,g,C//g,H,W).permute(<span class="number">0</span>,<span class="number">2</span>,<span class="number">1</span>,<span class="number">3</span>,<span class="number">4</span>).reshape(N,C,H,W)</span><br></pre></td></tr></table></figure><h3 id="网络结构"><a href="#网络结构" class="headerlink" title="网络结构"></a>网络结构</h3><p>在<code>ShuffleNet</code>中，也是和<code>ResNet</code>等模型相似，使用的是<code>Block</code>，结构如下所示。</p><img src="/2020/02/09/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-ShuffleNet/shufflenet-unite.png" class=""><p>图<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>a</mi></mrow></semantics></math></span></span>是<code>ResNet</code>中的<code>Block</code>结构，图<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>b</mi></mrow></semantics></math></span></span>是<code>ShuffleNet</code>中使用的<code>Block</code>，先经过<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>1</mn><mo>×</mo><mn>1</mn></mrow></semantics></math></span></span>通道分组卷积，然后通道重排，在<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>3</mn><mo>×</mo><mn>3</mn></mrow></semantics></math></span></span>空间上的depthwise convolution，然后再经过一个<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>1</mn><mo>×</mo><mn>1</mn></mrow></semantics></math></span></span>的通道分组卷积，图<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>c</mi></mrow></semantics></math></span></span>是要进行降维时候的结构<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>s</mi><mi>t</mi><mi>r</mi><mi>i</mi><mi>d</mi><mi>e</mi><mo>&#x3D;</mo><mn>2</mn></mrow></semantics></math></span></span>，旁边的shortcut也变为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>s</mi><mi>t</mi><mi>r</mi><mi>i</mi><mi>d</mi><mi>e</mi><mo>&#x3D;</mo><mn>2</mn></mrow></semantics></math></span></span>的平均池化。</p><p>可以看到shufflenet中的blcok是从残差网络的block中改造得到的。在resnet中block模块的设计是：<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>1</mn><mo>×</mo><mn>1</mn></mrow></semantics></math></span></span>的卷积–&gt;<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>3</mn><mo>×</mo><mn>3</mn></mrow></semantics></math></span></span>的深度卷积，并且在这一步数据通道减少，可以理解成一个bottleneck–&gt;<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>1</mn><mo>×</mo><mn>1</mn></mrow></semantics></math></span></span>卷积，最后是一个短路连接，将输入直接加到输出上。</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">1x1 Conv --&gt; 3x3 DWConv--&gt; 1x1 Conv --------&gt;</span><br><span class="line"> |                                     |</span><br><span class="line"> |-------------------------------------|</span><br></pre></td></tr></table></figure><p>在shufflenet中对resnet的block进行了改进设计，将<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>1</mn><mo>×</mo><mn>1</mn></mrow></semantics></math></span></span>的普通卷积换成了组卷积，并且在后面加入了channel shuffle操作。</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">1x1 Group convolution --&gt; channel shuffle --&gt; 3x3 DWConv--&gt; 1x1 Group convolution --------&gt;</span><br><span class="line"> |                                                                                    |</span><br><span class="line"> |------------------------------------------------------------------------------------|</span><br></pre></td></tr></table></figure><p>ShuffleNet的block设计代码如下所示</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">class</span> <span class="title class_">Bottleneck</span>(nn.Module):</span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">__init__</span>(<span class="params">self, in_planes, out_planes, stride, groups</span>):</span><br><span class="line">        <span class="built_in">super</span>(Bottleneck, self).__init__()</span><br><span class="line">        self.stride = stride</span><br><span class="line"></span><br><span class="line">        mid_planes = out_planes/<span class="number">4</span></span><br><span class="line">        g = <span class="number">1</span> <span class="keyword">if</span> in_planes==<span class="number">24</span> <span class="keyword">else</span> groups</span><br><span class="line">        self.conv1 = nn.Conv2d(in_planes, mid_planes, kernel_size=<span class="number">1</span>, groups=g, bias=<span class="literal">False</span>)</span><br><span class="line">        self.bn1 = nn.BatchNorm2d(mid_planes)</span><br><span class="line">        self.shuffle1 = ShuffleBlock(groups=g)</span><br><span class="line">        self.conv2 = nn.Conv2d(mid_planes, mid_planes, kernel_size=<span class="number">3</span>, stride=stride, padding=<span class="number">1</span>, groups=mid_planes, bias=<span class="literal">False</span>)</span><br><span class="line">        self.bn2 = nn.BatchNorm2d(mid_planes)</span><br><span class="line">        self.conv3 = nn.Conv2d(mid_planes, out_planes, kernel_size=<span class="number">1</span>, groups=groups, bias=<span class="literal">False</span>)</span><br><span class="line">        self.bn3 = nn.BatchNorm2d(out_planes)</span><br><span class="line"></span><br><span class="line">        self.shortcut = nn.Sequential()</span><br><span class="line">        <span class="keyword">if</span> stride == <span class="number">2</span>:</span><br><span class="line">            self.shortcut = nn.Sequential(nn.AvgPool2d(<span class="number">3</span>, stride=<span class="number">2</span>, padding=<span class="number">1</span>))</span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">forward</span>(<span class="params">self, x</span>):</span><br><span class="line">      <span class="comment"># group convolution and bn, relu </span></span><br><span class="line">        out = F.relu(self.bn1(self.conv1(x)))</span><br><span class="line">        <span class="comment"># channel shuffle</span></span><br><span class="line">        out = self.shuffle1(out)</span><br><span class="line">        <span class="comment"># depthwise convolution and output channel num is out/4</span></span><br><span class="line">        out = F.relu(self.bn2(self.conv2(out)))</span><br><span class="line">        <span class="comment"># group convolution and bn, relu</span></span><br><span class="line">        out = self.bn3(self.conv3(out))</span><br><span class="line">        <span class="comment"># shortcut</span></span><br><span class="line">        res = self.shortcut(x)</span><br><span class="line">        <span class="comment"># relu </span></span><br><span class="line">        out = F.relu(torch.cat([out,res], <span class="number">1</span>)) <span class="keyword">if</span> self.stride==<span class="number">2</span> <span class="keyword">else</span> F.relu(out+res)</span><br><span class="line">        <span class="keyword">return</span> out</span><br><span class="line"></span><br></pre></td></tr></table></figure><hr>下图是shufflenet的模型结构示意图<img src="/2020/02/09/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-ShuffleNet/shufflenet-architecture.png" class=""><p>开始是普通的<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>3</mn><mo>×</mo><mn>3</mn></mrow></semantics></math></span></span>的卷积，和maxpool层，然后是3个stage，每个stage都是重复堆叠shufflenet中的block结构，在每个stage中，第一个基本单元采用的是<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>s</mi><mi>t</mi><mi>r</mi><mi>i</mi><mi>d</mi><mi>e</mi><mo>&#x3D;</mo><mn>2</mn></mrow></semantics></math></span></span>，这样特征图width和height各降低一半，而通道数增加1倍。后面的基本单元都是<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>s</mi><mi>t</mi><mi>r</mi><mi>i</mi><mi>d</mi><mi>e</mi><mo>&#x3D;</mo><mn>1</mn></mrow></semantics></math></span></span>，特征图和通道数都保持不变。对于基本单元来说，其中瓶颈层，就是3x3卷积层的通道数为输出通道数的1&#x2F;4，这里和resnet中的残差单元设计是一致的。<hr></p><h3 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h3><p>实际上就像开头说的那样，shufflenet的设计的竞标对象是mobilenetv1，在论文中也可以看到作者的实验中对比对象是MobileNetV1。</p><img src="/2020/02/09/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-ShuffleNet/comparison.png" class=""><p>可以看出来，shufflenet在计算复杂度和模型准确率上都是由于mobilenet的。</p><h2 id="ShuffleNetV2"><a href="#ShuffleNetV2" class="headerlink" title="ShuffleNetV2"></a>ShuffleNetV2</h2><img src="/2020/02/09/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-ShuffleNet/shufflenetv2-conv-time.png" class=""><p>在<code>ShuffleNet</code>中，作者使用<code>FLOPS</code>来作为模型效率的一个评价指标，但是在在<code>ShuffleNetV2</code>的论文中作者指出这个指标是间接的，因为一个模型实际的运行时间除了要把计算操作算进去之外，还有例如内存读写，<code>GPU</code>并行性，文件<code>IO</code>等也应该考虑进去。最直接的方案还应该回归到最原始的策略，即直接在同一个硬件上观察每个模型的运行时间。如上图所示，在整个模型的计算周期中，<code>Conv</code>耗时仅占<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>50</mn><mi mathvariant="normal">%</mi></mrow></semantics></math></span></span>左右，如果我们能优化另外<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>50</mn><mi mathvariant="normal">%</mi></mrow></semantics></math></span></span>，我们就能够在不损失计算量的前提下进一步提高模型的效率。</p><p>在ShuffleNetV2中作者从内存访问代价（Memory Access Cost，MAC）和GPU并行性的方向分析了网络应该怎么设计才能进一步减少运行时间，提高模型的效率。</p><h3 id="高效模型的设计原则"><a href="#高效模型的设计原则" class="headerlink" title="高效模型的设计原则"></a>高效模型的设计原则</h3><h4 id="相同输入输出情况下MAC最小"><a href="#相同输入输出情况下MAC最小" class="headerlink" title="相同输入输出情况下MAC最小"></a>相同输入输出情况下MAC最小</h4><p>对于一个featuremap，假设尺寸为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>h</mi><mo>×</mo><mi>w</mi><mo>×</mo><msub><mi>c</mi><mn>1</mn></msub></mrow></semantics></math></span></span>，经过卷积之后输出的featuremap为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>h</mi><mo>×</mo><mi>w</mi><mo>×</mo><msub><mi>c</mi><mn>2</mn></msub></mrow></semantics></math></span></span>，那么卷积操作需要的算力FLOPs为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>B</mi><mo>&#x3D;</mo><mi>h</mi><mi>w</mi><msub><mi>c</mi><mn>1</mn></msub><msub><mi>c</mi><mn>2</mn></msub></mrow></semantics></math></span></span>，在计算过程中占用的内存，输入featuremap为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>h</mi><mi>w</mi><msub><mi>c</mi><mn>1</mn></msub></mrow></semantics></math></span></span>，输出featuremap为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>h</mi><mi>w</mi><msub><mi>c</mi><mn>2</mn></msub></mrow></semantics></math></span></span>，卷积核为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><msub><mi>c</mi><mn>1</mn></msub><msub><mi>c</mi><mn>2</mn></msub></mrow></semantics></math></span></span>，也就是<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>M</mi><mi>A</mi><mi>C</mi><mo>&#x3D;</mo><mi>h</mi><mi>w</mi><mo stretchy="false">(</mo><msub><mi>c</mi><mn>1</mn></msub><mo>+</mo><msub><mi>c</mi><mn>2</mn></msub><mo stretchy="false">)</mo><mo>+</mo><msub><mi>c</mi><mn>1</mn></msub><msub><mi>c</mi><mn>2</mn></msub></mrow></semantics></math></span></span></p><p>有如下的推导公式<br><span class="katex-display" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML" display="block"><semantics><mtable rowspacing="0.25em" columnalign="right left" columnspacing="0em"><mtr><mtd><mstyle scriptlevel="0" displaystyle="true"><mrow><mi>M</mi><mi>A</mi><mi>C</mi></mrow></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="true"><mrow><mrow></mrow><mo>&#x3D;</mo><mi>h</mi><mi>w</mi><mrow><mo fence="true">(</mo><msub><mi>c</mi><mn>1</mn></msub><mo>+</mo><msub><mi>c</mi><mn>2</mn></msub><mo fence="true">)</mo></mrow><mo>+</mo><msub><mi>c</mi><mn>1</mn></msub><msub><mi>c</mi><mn>2</mn></msub></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="true"><mrow></mrow></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="true"><mrow><mrow></mrow><mo>&#x3D;</mo><msqrt><msup><mrow><mo fence="true">(</mo><mi>h</mi><mi>w</mi><mrow><mo fence="true">(</mo><msub><mi>c</mi><mn>1</mn></msub><mo>+</mo><msub><mi>c</mi><mn>2</mn></msub><mo fence="true">)</mo></mrow><mo fence="true">)</mo></mrow><mn>2</mn></msup></msqrt><mo>+</mo><mfrac><mi>B</mi><mrow><mi>h</mi><mi>w</mi></mrow></mfrac></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="true"><mrow></mrow></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="true"><mrow><mrow></mrow><mo>&#x3D;</mo><msqrt><mrow><mo stretchy="false">(</mo><mi>h</mi><mi>w</mi><msup><mo stretchy="false">)</mo><mn>2</mn></msup><mo>⋅</mo><msup><mrow><mo fence="true">(</mo><msub><mi>c</mi><mn>1</mn></msub><mo>+</mo><msub><mi>c</mi><mn>2</mn></msub><mo fence="true">)</mo></mrow><mn>2</mn></msup></mrow></msqrt><mo>+</mo><mfrac><mi>B</mi><mrow><mi>h</mi><mi>w</mi></mrow></mfrac></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="true"><mrow></mrow></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="true"><mrow><mrow></mrow><mo>≥</mo><msqrt><mrow><mo stretchy="false">(</mo><mi>h</mi><mi>w</mi><msup><mo stretchy="false">)</mo><mn>2</mn></msup><mo>⋅</mo><mn>4</mn><msub><mi>c</mi><mn>1</mn></msub><msub><mi>c</mi><mn>2</mn></msub></mrow></msqrt><mo>+</mo><mfrac><mi>B</mi><mrow><mi>h</mi><mi>w</mi></mrow></mfrac></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="true"><mrow></mrow></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="true"><mrow><mrow></mrow><mo>&#x3D;</mo><mi>s</mi><msqrt><mrow><mi>h</mi><mi>w</mi><mo>⋅</mo><mrow><mo fence="true">(</mo><mi>h</mi><mi>w</mi><msub><mi>c</mi><mn>1</mn></msub><msub><mi>c</mi><mn>2</mn></msub><mo fence="true">)</mo></mrow></mrow></msqrt><mo>+</mo><mfrac><mi>B</mi><mrow><mi>h</mi><mi>w</mi></mrow></mfrac></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="true"><mrow></mrow></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="true"><mrow><mrow></mrow><mo>&#x3D;</mo><mn>2</mn><msqrt><mrow><mi>h</mi><mi>w</mi><mi>B</mi></mrow></msqrt><mo>+</mo><mfrac><mi>B</mi><mrow><mi>h</mi><mi>w</mi></mrow></mfrac></mrow></mstyle></mtd></mtr></mtable></semantics></math></span></span><br>当满足<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><msub><mi>c</mi><mn>1</mn></msub><mo>&#x3D;</mo><msub><mi>c</mi><mn>2</mn></msub></mrow></semantics></math></span></span>的时候，上式可以取到等号，也就是说，当所需算力确定的前提下，<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><msub><mi>c</mi><mn>1</mn></msub><mo>&#x3D;</mo><msub><mi>c</mi><mn>2</mn></msub></mrow></semantics></math></span></span>时所需的<code>MAC</code>最小，此时的模型效率最高。</p><h4 id="MAC与group-convolution的分组数量成正比"><a href="#MAC与group-convolution的分组数量成正比" class="headerlink" title="MAC与group convolution的分组数量成正比"></a>MAC与group convolution的分组数量成正比</h4><p>在group convolution中，FLOPs为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>B</mi><mo>&#x3D;</mo><mi>h</mi><mi>w</mi><msub><mi>c</mi><mn>1</mn></msub><msub><mi>c</mi><mn>2</mn></msub><mi mathvariant="normal">&#x2F;</mi><mi>g</mi></mrow></semantics></math></span></span>，对应的<code>MAC</code>计算公式为<br><span class="katex-display" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML" display="block"><semantics><mtable rowspacing="0.25em" columnalign="right left" columnspacing="0em"><mtr><mtd><mstyle scriptlevel="0" displaystyle="true"><mrow><mi>M</mi><mi>A</mi><mi>C</mi></mrow></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="true"><mrow><mrow></mrow><mo>&#x3D;</mo><mi>h</mi><mi>w</mi><mrow><mo fence="true">(</mo><msub><mi>c</mi><mn>1</mn></msub><mo>+</mo><msub><mi>c</mi><mn>2</mn></msub><mo fence="true">)</mo></mrow><mo>+</mo><mfrac><msub><mi>c</mi><mn>1</mn></msub><mi>g</mi></mfrac><mfrac><msub><mi>c</mi><mn>2</mn></msub><mi>g</mi></mfrac><mi>g</mi></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="true"><mrow></mrow></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="true"><mrow><mrow></mrow><mo>&#x3D;</mo><mi>h</mi><mi>w</mi><mrow><mo fence="true">(</mo><msub><mi>c</mi><mn>1</mn></msub><mo>+</mo><msub><mi>c</mi><mn>2</mn></msub><mo fence="true">)</mo></mrow><mo>+</mo><mfrac><mrow><msub><mi>c</mi><mn>1</mn></msub><msub><mi>c</mi><mn>2</mn></msub></mrow><mi>g</mi></mfrac></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="true"><mrow></mrow></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="true"><mrow><mrow></mrow><mo>&#x3D;</mo><mi>B</mi><mi>g</mi><mrow><mo fence="true">(</mo><mfrac><mn>1</mn><msub><mi>c</mi><mn>1</mn></msub></mfrac><mo>+</mo><mfrac><mn>1</mn><msub><mi>c</mi><mn>2</mn></msub></mfrac><mo fence="true">)</mo></mrow><mo>+</mo><mfrac><mi>B</mi><mrow><mi>h</mi><mi>w</mi></mrow></mfrac></mrow></mstyle></mtd></mtr></mtable></semantics></math></span></span><br>也就是在使用group convolution的时候，group的分组数量不要太大。</p><h4 id="模型的分支会降低网络并行能力"><a href="#模型的分支会降低网络并行能力" class="headerlink" title="模型的分支会降低网络并行能力"></a>模型的分支会降低网络并行能力</h4><p>在比较典型的模型结构中，<a href="https://towardsdatascience.com/a-simple-guide-to-the-versions-of-the-inception-network-7fc52b863202">InceptionNet</a>和<code>NasNet</code>是分支比较多的，在论文里，作者对比了几种不同的网络结构，通过控制卷积的通道数来使5组对照试验的<code>FLOPs</code>相同，通过实验我们发现它们按效率从高到低排列依次是<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>a</mi><mo>&gt;</mo><mi>b</mi><mo>&gt;</mo><mi>d</mi><mo>&gt;</mo><mi>c</mi><mo>&gt;</mo><mi>e</mi></mrow></semantics></math></span></span></p><img src="/2020/02/09/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-ShuffleNet/shuffnetv2-branches.png" class="" title="Branches"><hr><p>可以明显的看到，模型的效率和模型的分支数量是成反比的。</p><h4 id="ElementWise操作是很昂贵的"><a href="#ElementWise操作是很昂贵的" class="headerlink" title="ElementWise操作是很昂贵的"></a>ElementWise操作是很昂贵的</h4><p>所谓的<code>ElementWise</code>是指在模型网络中的激活函数，bias_add等操作，这些操作在计算FLOPs时被忽略掉了，但是根据上面论文中作者提供的<code>shufflenetv1</code>和<code>mobilebnetv2</code>的计算时间分布饼图，可以知道<code>ElementWise</code>实际上所占的比例一点都不小。</p><h4 id="总结-1"><a href="#总结-1" class="headerlink" title="总结"></a>总结</h4><p>既然有了上面四个设计准则，那么要想设计更高效的网络就有了入手点</p><ol><li>使用输入通道和输出通道相同的卷积操作</li><li>谨慎使用分组卷积</li><li>减少网络分支数</li><li>减少<code>ElementWise</code>操作</li></ol><p>在shufflenetv1中设计的block中有两个分组卷积层存在，并且每个分组卷积层group数量一般为3，这显然就不满足第二个准则了，回顾MobileNetV2的结构借鉴了resnet的设计，包含深度可分离卷积，扩展层和映射层以及大量的Relu6操作，显然不太符合条件3，4。</p><h3 id="网络结构-1"><a href="#网络结构-1" class="headerlink" title="网络结构"></a>网络结构</h3><p>上面说了一大堆，主要是作者在阐述shufflenetv2的设计思路，那么网络结构到底啥样子</p><img src="/2020/02/09/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-ShuffleNet/shufflenetv2-block.png" class="" title="Shufflenet Block"><hr><p>左边两个是第一节中所说的V1的结构，右边是需要重点说的V2的结构。</p><p>对比发现</p><ol><li><span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>c</mi></mrow></semantics></math></span></span>中加入了通道分割操作(channel split)，具体的操作方法是：将c个输入的feature分成<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>c</mi><mo>−</mo><msup><mi>c</mi><mn>1</mn></msup></mrow></semantics></math></span></span>和<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><msup><mi>c</mi><mn>1</mn></msup></mrow></semantics></math></span></span>两组，并且一般情况下<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><msup><mi>c</mi><mn>1</mn></msup><mo>&#x3D;</mo><mfrac><mi>c</mi><mn>2</mn></mfrac></mrow></semantics></math></span></span>，这样是为了满足设计准则的第三点，尽量控制模型的分支数量</li><li>进行通道分割之后左侧的分支直接映射，右侧是一个输入通道数和输出通道数相等的深度可分离卷积，这样是为了满足条件1</li><li>右侧的分支中只使用了<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>1</mn><mo>×</mo><mn>1</mn></mrow></semantics></math></span></span>卷积，并没有使用V1的分组卷积，这样是为了满足条件2</li><li>在最后合并的时候都是使用的concat操作，并没有使用Add，是为了满足条件4</li><li>在堆叠<code>ShuffleNetv2</code>的时候，concat，channel-split和channel-shuffle合并成1个element-wise操作，也是为了满足条件4。</li></ol><p>图<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>d</mi></mrow></semantics></math></span></span>是降采样操作，不进行channel-split操作，每个分支直接copy一份输入，每个分支进行stride&#x3D;2的下采样，最后concat在一起，这样featuremap减半，但是通道数量加倍。</p><p>其他的地方就和V1模型相似了，通过多个block堆叠，组成ShuffleNetV2模型，模型结构如下</p><img src="/2020/02/09/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-ShuffleNet/shufflenetv2-architecture.png" class="" title="ShuffleNetV2 Architecture"><p>V2相比V1多了一个conv5层，除了这个外就没什么不一样的了。</p><h2 id="Reference"><a href="#Reference" class="headerlink" title="Reference"></a>Reference</h2><ol><li><p>论文地址：<a href="https://arxiv.org/abs/1707.01083">https://arxiv.org/abs/1707.01083</a></p></li><li><p>V1代码-Pytorch：<a href="https://github.com/kuangliu/pytorch-cifar/blob/master/models/shufflenet.py">https://github.com/kuangliu/pytorch-cifar/blob/master/models/shufflenet.py</a></p></li><li><p>V2代码-Pytorch：<a href="https://pytorch.org/hub/pytorch_vision_shufflenet_v2/">https://pytorch.org/hub/pytorch_vision_shufflenet_v2/</a></p></li><li><p>V2代码-TensorFlow：<a href="https://github.com/tensorpack/tensorpack/blob/master/examples/ImageNetModels/shufflenet.py">https://github.com/tensorpack/tensorpack/blob/master/examples/ImageNetModels/shufflenet.py</a></p></li></ol>]]>
    </content>
    <id>https://xiaofengshi.com/2020/02/09/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-ShuffleNet/</id>
    <link href="https://xiaofengshi.com/2020/02/09/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-ShuffleNet/"/>
    <published>2020-02-09T15:06:18.000Z</published>
    <summary>
      <![CDATA[<p>本篇主要分析轻量化Conv-ShuffleNet</p>
<img src="/2020/02/09/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-ShuffleNet/shufflenetv2-block.png" class="">]]>
    </summary>
    <title>深度学习-ConvNet-Shufflenet</title>
    <updated>2020-02-16T21:49:26.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Xiaofeng Shi</name>
    </author>
    <category term="深度学习" scheme="https://xiaofengshi.com/categories/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    <category term="CV" scheme="https://xiaofengshi.com/categories/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/CV/"/>
    <category term="深度学习" scheme="https://xiaofengshi.com/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    <category term="ConvNet" scheme="https://xiaofengshi.com/tags/ConvNet/"/>
    <category term="CV" scheme="https://xiaofengshi.com/tags/CV/"/>
    <category term="轻量化Conv" scheme="https://xiaofengshi.com/tags/%E8%BD%BB%E9%87%8F%E5%8C%96Conv/"/>
    <content>
      <![CDATA[<img src="/2020/02/09/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-EfficientNet/efficientnet-params-acc.png" class=""><p>上图为不同模型的参数量和模型ACC曲线，可以看到和EfficientNet对比的网络包含ResNet，SENet，GPipe，Inception，NASNet，DenseNet等目前的主流网络，并且处于领先位置。</p><span id="more"></span><h2 id="Overview"><a href="#Overview" class="headerlink" title="Overview"></a>Overview</h2><p>开篇明义，整篇论文一直围绕着下面这张图在进行的</p><hr> Flops-Acc曲线<img src="/2020/02/09/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-EfficientNet/efficient-flops-acc.png" class=""><p>横坐标为模型所需要的算力<code>FLOPS，</code>纵坐标为ACC。在相同的算力需求下，不同的模型策略对应的模型准确率曲线，联合多维度模型优化的策略是优于单个维度优化的策略的。 <hr></p><p>前几年的发展，在模型设计上为了提高模型的准确率，研究学者从模型的宽度，深度和输入分辨率来进行设计研究。在这个论文中，作者提出了一个思考：能否找到一个规范化的神经网络扩展方法可以同时提高网络的准确率和效率。要实现这点，一个很关键的步骤便是如何平衡<strong>宽度、深度和分辨率</strong>这三个维度。从Alexnet到2018年的GPipe，人们不断探寻更高效的模型。</p><table><thead><tr><th align="left">Architecture</th><th align="left">Year</th><th align="left">Accuracy</th><th align="left">Parameters</th></tr></thead><tbody><tr><td align="left">AlexNet</td><td align="left">2012</td><td align="left">56.55%</td><td align="left">62M</td></tr><tr><td align="left">GoogleNet</td><td align="left">2014</td><td align="left">74.8%</td><td align="left">6.8M</td></tr><tr><td align="left">SENet</td><td align="left">2017</td><td align="left">82.7%</td><td align="left">145M</td></tr><tr><td align="left">GPipe</td><td align="left">2018</td><td align="left">84.3%</td><td align="left">557M</td></tr></tbody></table><h2 id="Model-Acc-vs-Model-Size"><a href="#Model-Acc-vs-Model-Size" class="headerlink" title="Model Acc vs Model Size"></a>Model Acc vs Model Size</h2><p>很显然，为了提升模型的准确率，往往会带来更多的模型参数，因此我们在选择模型的时候要考虑模型准确率和模型参数里的trade-off，在图表中可以说GoogleNet是全面碾压AlexNet的，因为不论从准确率还是参数里上，GoogleNet都是更优的，目前我们设计<strong>ConvNet</strong>网络的几个准则</p><h3 id="模型压缩"><a href="#模型压缩" class="headerlink" title="模型压缩"></a>模型压缩</h3><ol><li><p>模型剪枝 </p><p>去掉无法提升模型效率的部分</p></li><li><p>量化 </p><p>从数据类型的角度，比如将<strong>float</strong>转化为<strong>int</strong>，将<strong>float32</strong>转化为<strong>float16</strong>或者<strong>float8</strong>，可以成倍的缩小模型大小</p></li></ol><h3 id="网络搜索"><a href="#网络搜索" class="headerlink" title="网络搜索"></a>网络搜索</h3><p>以<code>MnasNet</code>为例，自动搜索的方法找到最佳的网络深度，卷积内核的宽度，大小等。</p><h3 id="模型缩放"><a href="#模型缩放" class="headerlink" title="模型缩放"></a>模型缩放</h3><p>仍然使用使用标准CNN网络，例如GoogleNet或ResNet，并通过更改网络的宽度和&#x2F;或深度或网络的大小来放大（即使用较大的参数）或缩小（即使用较少的参数）。EfficientNet也是采用的这种方式。</p><h2 id="模型设计"><a href="#模型设计" class="headerlink" title="模型设计"></a>模型设计</h2><p>为了提高模型的效率。扩大网络宽度，深度或分辨率的任何尺寸都可以提高精度，但是对于较大的模型，精度增益会降低。为了追求更好的准确性和效率，在<strong>ConvNet</strong>扩展过程中平衡网络宽度，深度和分辨率的所有维度至关重要。</p><p>关键点就在于：是如何选择应该使网络更深或更宽的范围，或者增加图像分辨率的程度。</p><h3 id="Compound-Scaling复合模型缩放"><a href="#Compound-Scaling复合模型缩放" class="headerlink" title="Compound Scaling复合模型缩放"></a>Compound Scaling复合模型缩放</h3><p>这个是在<code>EfficientNet</code>中提出来的，使用复合系数来原则上均匀地缩放宽度，深度和分辨率。在论文中，为了将三个维度结合起来，作者设计了一个公式<br><span class="katex-display" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML" display="block"><semantics><mtable rowspacing="0.16em" columnalign="left" columnspacing="1em"><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mtext> depth: </mtext><mi>d</mi><mo>&#x3D;</mo><msup><mi>α</mi><mi>ϕ</mi></msup></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mtext> width: </mtext><mi>w</mi><mo>&#x3D;</mo><msup><mi>β</mi><mi>ϕ</mi></msup></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mtext> resolution: </mtext><mi>r</mi><mo>&#x3D;</mo><msup><mi>γ</mi><mi>ϕ</mi></msup></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mi>s</mi><mi mathvariant="normal">.</mi><mi>t</mi><mi mathvariant="normal">.</mi><mo stretchy="false">(</mo><mi>α</mi><mo>⋅</mo><msup><mi>β</mi><mn>2</mn></msup><mo>⋅</mo><msup><mi>γ</mi><mn>2</mn></msup><mo>≈</mo><mn>2</mn><mo stretchy="false">)</mo></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mi>α</mi><mo>≥</mo><mn>1</mn><mo separator="true">,</mo><mi>β</mi><mo>≥</mo><mn>1</mn><mo separator="true">,</mo><mi>γ</mi><mo>≥</mo><mn>1</mn></mrow></mstyle></mtd></mtr></mtable></semantics></math></span></span><br>按照论文所述</p><blockquote><p>使用<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>d</mi></mrow></semantics></math></span></span>表示模型的深度，<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>w</mi></mrow></semantics></math></span></span>表示模型宽度，<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>γ</mi></mrow></semantics></math></span></span>表示模型的输入分辨率对模型准确性和效率的影响。<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>α</mi><mo separator="true">,</mo><mi>β</mi><mo separator="true">,</mo><mi>γ</mi></mrow></semantics></math></span></span>是由网格搜索的方法得到的三个常数，<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>ϕ</mi></mrow></semantics></math></span></span>是用户指定的参数，用于控制有多少资源可用于模型缩放，而<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>α</mi><mo separator="true">,</mo><mi>β</mi><mo separator="true">,</mo><mi>γ</mi></mrow></semantics></math></span></span>指定如何分别将这些额外资源分配给网络宽度，深度和分辨率。常规卷积运算的<strong>FLOPS</strong>与<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>d</mi></mrow></semantics></math></span></span>，<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><msup><mi>w</mi><mn>2</mn></msup></mrow></semantics></math></span></span>，<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><msup><mi>γ</mi><mn>2</mn></msup></mrow></semantics></math></span></span>成正比，即网络深度加倍将使<strong>FLOPS</strong>加倍，但网络宽度或分辨率加倍将使<strong>FLOPS</strong>增加四倍。 由于卷积运算通常在<strong>ConvNet</strong>中占主导地位，因此按照上述公式符合缩放<strong>ConvNet</strong>将使总<strong>FLOPS</strong>大约增加<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><msup><mrow><mo fence="true">(</mo><mi>α</mi><mo>⋅</mo><msup><mi>β</mi><mn>2</mn></msup><mo>⋅</mo><msup><mi>γ</mi><mn>2</mn></msup><mo fence="true">)</mo></mrow><mi>ϕ</mi></msup></mrow></semantics></math></span></span>。在论文中建立约束条件，<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>α</mi><mo>⋅</mo><msup><mi>β</mi><mn>2</mn></msup><mo>⋅</mo><msup><mi>γ</mi><mn>2</mn></msup><mo>≈</mo><mn>2</mn></mrow></semantics></math></span></span>，这样对于任意网格搜索得到的参数<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>α</mi><mo separator="true">,</mo><mi>β</mi><mo separator="true">,</mo><mi>γ</mi></mrow></semantics></math></span></span>对需要的<strong>FLOPS</strong>算力的影响被限制为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><msup><mn>2</mn><mi>ϕ</mi></msup></mrow></semantics></math></span></span>。</p></blockquote><h2 id="模型训练"><a href="#模型训练" class="headerlink" title="模型训练"></a>模型训练</h2><p>在EfficientNet中使用的是MnasNet的训练方法，使用的是和MnasNet相同的搜索空间，优化目标为<br><span class="katex-display" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML" display="block"><semantics><mrow><mi>A</mi><mi>C</mi><mi>C</mi><mo stretchy="false">(</mo><mi>m</mi><mo stretchy="false">)</mo><mo>×</mo><mo stretchy="false">[</mo><mi>F</mi><mi>L</mi><mi>O</mi><mi>P</mi><mi>S</mi><mo stretchy="false">(</mo><mi>m</mi><mo stretchy="false">)</mo><mi mathvariant="normal">&#x2F;</mi><mi>T</mi><msup><mo stretchy="false">]</mo><mi>w</mi></msup></mrow></semantics></math></span></span><br>其中<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>A</mi><mi>C</mi><mi>C</mi><mo stretchy="false">(</mo><mi>m</mi><mo stretchy="false">)</mo></mrow></semantics></math></span></span>对应着模型的准确率，<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mo stretchy="false">[</mo><mi>F</mi><mi>L</mi><mi>O</mi><mi>P</mi><mi>S</mi><mo stretchy="false">(</mo><mi>m</mi><mo stretchy="false">)</mo><mi mathvariant="normal">&#x2F;</mi><mi>T</mi><msup><mo stretchy="false">]</mo><mi>w</mi></msup></mrow></semantics></math></span></span>对应着模型需要的算力，<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>T</mi></mrow></semantics></math></span></span>对应着我们一开始设置的需要的算力值，<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>w</mi><mo>&#x3D;</mo><mo>−</mo><mn>0.07</mn></mrow></semantics></math></span></span>是控制准确率和算力之间平衡的超参数</p><p>区别于MnasNet的是这里优化的是FLOPS而不是延迟，这是因为模型没有针对专门的设备进行设计，因此使用算力这个值更加合理。经过这中方法，搜索得到模型<strong>EfficientNet-B0</strong>。</p><hr> 模型结构如下图所示<img src="/2020/02/09/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-EfficientNet/efficientnet-b0.png" class=""><hr><p>图中的MBConv对应着MobilenetV2中提出的翻转残差模块。可以看到经过MnasNet搜索得到的网络结构跟我们手工设计的网络的确不太一样。</p><p>在固定上面公式的<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>ϕ</mi><mo>&#x3D;</mo><mn>1</mn></mrow></semantics></math></span></span>，在约束条件下，经过网格搜索得到最优参数<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>α</mi><mo>&#x3D;</mo><mn>1.2</mn><mtext>，</mtext><mi>β</mi><mo>&#x3D;</mo><mn>1.1</mn><mo separator="true">,</mo><mi>γ</mi><mo>&#x3D;</mo><mn>1.15</mn></mrow></semantics></math></span></span>，实际上网格搜索是最暴力的搜索方法，这里不得不说要有强大的计算资源才能进行如此计算。</p><p>个人看这个论文的时候被一张图吸引</p><hr>不同的模型缩放方式对应的激活图<img src="/2020/02/09/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-EfficientNet/efficientNet-activation-map.png" class=""><hr><p>这张图展示了在不同的模型策略下，对应的激活图，可以看到</p><ul><li><p>基础模型，区域信息加大，包含很多噪音特征</p></li><li><p>模型加深之后，特征变得稀疏，会集中在相对更明显的物体上</p></li><li><p>模型加宽之后，特征值变得较大，但是区域仍然包含较多噪音</p></li><li><p>增大输入分辨率，特征会集中在单个实体上，但是特征值很少</p></li><li><p>符合缩放模型，特征值具有了三者的优势，特征值变大，并且集中在单个实体上。</p></li></ul><h2 id="Reference"><a href="#Reference" class="headerlink" title="Reference"></a>Reference</h2><ul><li><p>论文链接<a href="https://arxiv.org/abs/1905.11946">“EfficientNet: Rethinking Model Scaling for Convolutional Neural Networks”</a></p></li><li><p>官方代码 <a href="https://github.com/tensorflow/tpu/blob/master/models/official/efficientnet/efficientnet_builder.py">https://github.com/tensorflow/tpu/blob/master/models/official/efficientnet/efficientnet_builder.py</a></p></li></ul>]]>
    </content>
    <id>https://xiaofengshi.com/2020/02/09/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-EfficientNet/</id>
    <link href="https://xiaofengshi.com/2020/02/09/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-EfficientNet/"/>
    <published>2020-02-09T11:48:15.000Z</published>
    <summary>
      <![CDATA[<img src="/2020/02/09/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-EfficientNet/efficientnet-params-acc.png" class="">

<p>上图为不同模型的参数量和模型ACC曲线，可以看到和EfficientNet对比的网络包含ResNet，SENet，GPipe，Inception，NASNet，DenseNet等目前的主流网络，并且处于领先位置。</p>]]>
    </summary>
    <title>深度学习-ConvNet-EfficientNet</title>
    <updated>2020-02-10T13:45:52.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Xiaofeng Shi</name>
    </author>
    <category term="深度学习" scheme="https://xiaofengshi.com/categories/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    <category term="CV" scheme="https://xiaofengshi.com/categories/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/CV/"/>
    <category term="深度学习" scheme="https://xiaofengshi.com/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    <category term="ConvNet" scheme="https://xiaofengshi.com/tags/ConvNet/"/>
    <category term="CV" scheme="https://xiaofengshi.com/tags/CV/"/>
    <category term="轻量化Conv" scheme="https://xiaofengshi.com/tags/%E8%BD%BB%E9%87%8F%E5%8C%96Conv/"/>
    <content>
      <![CDATA[<img src="/2020/02/03/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-MobileNetV1-V3/pose_estimation.gif" class="" title="Pose estimation"><p>本篇主要对目前流行的移动端轻量化网络MobileNet进行分析。</p><p>最近一段时间由于工作需要，想要将服务端的模型迁移到移动端，突然发现一个尴尬的现实，服务端的大模型在移动端是很难跑起来的。随着5G技术的到来，端上设备越来越强悍，将模型做到移动端是一个很显然的大趋势。目前的移动端模型 ( <a href="https://www.tensorflow.org/lite/models/">https://www.tensorflow.org/lite/models/</a> )，主要跑的是CV相关方面的识别，检测模型，姿态预估等相对简单的模型，并且目前的模型很多是基于<code>MobileNet</code>这一网络的，本篇就主要针对<code>Mobilenet</code>进行研究分析。</p><span id="more"></span><h2 id="MobileNetV1"><a href="#MobileNetV1" class="headerlink" title="MobileNetV1"></a>MobileNetV1</h2><p>同样是针对移动端进行优化，使用<code>mobilenet</code>替代常规的卷积方式，由于<code>Mobilenet</code>的深度可分离卷积结构设计，目前，在工业界<code>Mobilenet</code>是移动端部署使用最广泛的，到2019年已经公布了MobilenetV3版本，该网络被广泛用于移动端的图像识别，检测等任务。</p><p><a href="https://arxiv.org/pdf/1704.04861.pdf">论文链接🔥 MobileNets: Efficient Convolutional Neural Networks for Mobile Vision</a></p><h3 id="设计思路"><a href="#设计思路" class="headerlink" title="设计思路"></a>设计思路</h3><p>在进行小型高效的神经网络时，一般两种思路:</p><ul><li><p>压缩模型</p><p>获得小型网络的一个办法是减小、分解或压缩预训练网络，例如量化压缩(product quantization)、哈希(hashing )、剪枝(pruning)、矢量编码( vector quantization)和霍夫曼编码(Huffman coding)等；此外还有各种分解因子(various factorizations )用来加速预训练网络；还有一种训练小型网络的方法叫蒸馏(distillation )，使用大型网络指导小型网络，例如上面的<code>squeezenet</code>。</p></li><li><p>直接训练小模型</p><p>例如<code>Flattened networks</code>利用完全的因式分解的卷积网络构建模型，显示出完全分解网络的潜力；<code>Factorized Networks</code>引入了类似的分解卷积以及拓扑连接的使用；<code>Xception network</code>显示了如何扩展深度可分离卷积到<code>Inception V3 networks</code>；<code>Squeezenet </code>使用一个bottleneck用于构建小型网络。</p></li></ul><h3 id="深度可分离卷积"><a href="#深度可分离卷积" class="headerlink" title="深度可分离卷积"></a>深度可分离卷积</h3><p><code>Mobilenet</code>主要注重于优化延迟的同时考虑小型的模型，从深度可分离卷积的角度构建模型。</p><p><strong><code>mobilenet</code>基于深度可分离卷积，将标准卷积分解成深度卷积(<code>depthwise convolution</code>)和逐点卷积(<code>pointwise convolution</code>)，通过此举大幅度降低参数量和计算量</strong></p><hr><img src="/2020/02/03/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-MobileNetV1-V3/mobilenet_Struct.png" class=""><p>图中的浅色代表的是下一个<code>block</code>的开始，并且注意方块代表的是特征图，而红色映射才是卷积或者<code>ReLU</code>操作。<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>a</mi></mrow></semantics></math></span></span>表示的是普通卷积方式，<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>b</mi></mrow></semantics></math></span></span>表示的就是在<code>MobileNet</code>中广泛使用的深度可分离卷积(<code>Depthwise Separable Convolution</code>)，先进行<code>Depthwise</code>再进行<code>Pointwise</code><hr></p><ul><li><p>普通卷积计算</p><p>假设输入的<code>featuremap</code>为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>12</mn><mo>×</mo><mn>12</mn><mo>×</mo><mn>4</mn></mrow></semantics></math></span></span>，卷积为<code>conv_3-2</code>,则对应的计算量为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>12</mn><mo>×</mo><mn>12</mn><mo>×</mo><mn>2</mn><mo>×</mo><mo stretchy="false">(</mo><mn>3</mn><mo>×</mo><mn>3</mn><mo>×</mo><mn>4</mn><mo stretchy="false">)</mo><mo>&#x3D;</mo><mn>10368</mn></mrow></semantics></math></span></span>，参数量为(卷积核带来的参数) <span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>3</mn><mo>×</mo><mn>3</mn><mo>×</mo><mn>4</mn><mo>×</mo><mn>2</mn><mo>&#x3D;</mo><mn>72</mn></mrow></semantics></math></span></span>，如下图所示</p><hr> image comes from https://blog.csdn.net/huachao1001/article/details/79171447  <img src="/2020/02/03/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-MobileNetV1-V3/mobilenet_conv.png" class="" title="mobilenet convolution"><hr></li><li><p>深度可分离卷积</p><p>在<code>Mobilenet</code>中将卷积操作进行了分解，分解为深度卷积和逐点卷积</p><hr></li></ul><img src="/2020/02/03/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-MobileNetV1-V3/mobilenetV1_block.png" class="">  <hr><p> <strong>深度卷积<code>DepthwiseConvolution</code>与传统的卷积方式不同</strong></p><ul><li><p>对于传统的卷积，卷积核在输入特征图的所有通道上共享参数，输出的通道数由卷积核的数量决定</p></li><li><p>深度卷积对输入的特征图的每个通道上使用不同的卷积核，一个卷积核对应一个输入通道</p></li></ul><p>  所以可以说<code>DepthwiseConvolution</code>是depth级别的操作。</p><p>  对于这一步的深度卷积有一篇回答特别棒 <a href="https://stackoverflow.com/questions/45369920/tensorflow-what-exactly-does-depthwise-convolution-do">https://stackoverflow.com/questions/45369920/tensorflow-what-exactly-does-depthwise-convolution-do</a></p><p>  为防止链接挂掉，引用代码如下</p>  <figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">import</span> tensorflow <span class="keyword">as</span> tf</span><br><span class="line"><span class="keyword">import</span> numpy <span class="keyword">as</span> np</span><br><span class="line"><span class="comment"># batch of 2 inputs of 13x13 pixels with 3 channels each.</span></span><br><span class="line"><span class="comment"># Four 5x5 filters applied to each channel, so 12 total channels output</span></span><br><span class="line">inputs_np = np.ones((<span class="number">2</span>, <span class="number">13</span>, <span class="number">13</span>, <span class="number">3</span>))</span><br><span class="line">inputs = tf.constant(inputs_np)</span><br><span class="line"><span class="comment"># Build the filters so that their behavior is easier to understand.  For these filters</span></span><br><span class="line"><span class="comment"># which are 5x5, I set the middle pixel (location 2,2) to some value and leave</span></span><br><span class="line"><span class="comment"># the rest of the pixels at zero</span></span><br><span class="line"></span><br><span class="line"><span class="comment"># <span class="doctag">NOTE:</span> 5x5 filters for 3 inputs and applying 4 such filters to each one. here &#x27;3&#x27; equal with the input tensor&#x27;s channel num S</span></span><br><span class="line">filters_np = np.zeros((<span class="number">5</span>,<span class="number">5</span>,<span class="number">3</span>,<span class="number">4</span>)) </span><br><span class="line"></span><br><span class="line"><span class="comment"># <span class="doctag">NOTE:</span> for betweer display, fileter is zeros, except bellow positions </span></span><br><span class="line">filters_np[<span class="number">2</span>, <span class="number">2</span>, <span class="number">0</span>, <span class="number">0</span>] = <span class="number">2.0</span></span><br><span class="line">filters_np[<span class="number">2</span>, <span class="number">2</span>, <span class="number">0</span>, <span class="number">1</span>] = <span class="number">2.1</span></span><br><span class="line">filters_np[<span class="number">2</span>, <span class="number">2</span>, <span class="number">0</span>, <span class="number">2</span>] = <span class="number">2.2</span></span><br><span class="line">filters_np[<span class="number">2</span>, <span class="number">2</span>, <span class="number">0</span>, <span class="number">3</span>] = <span class="number">2.3</span></span><br><span class="line">filters_np[<span class="number">2</span>, <span class="number">2</span>, <span class="number">1</span>, <span class="number">0</span>] = <span class="number">3.0</span></span><br><span class="line">filters_np[<span class="number">2</span>, <span class="number">2</span>, <span class="number">1</span>, <span class="number">1</span>] = <span class="number">3.1</span></span><br><span class="line">filters_np[<span class="number">2</span>, <span class="number">2</span>, <span class="number">1</span>, <span class="number">2</span>] = <span class="number">3.2</span></span><br><span class="line">filters_np[<span class="number">2</span>, <span class="number">2</span>, <span class="number">1</span>, <span class="number">3</span>] = <span class="number">3.3</span></span><br><span class="line">filters_np[<span class="number">2</span>, <span class="number">2</span>, <span class="number">2</span>, <span class="number">0</span>] = <span class="number">4.0</span></span><br><span class="line">filters_np[<span class="number">2</span>, <span class="number">2</span>, <span class="number">2</span>, <span class="number">1</span>] = <span class="number">4.1</span></span><br><span class="line">filters_np[<span class="number">2</span>, <span class="number">2</span>, <span class="number">2</span>, <span class="number">2</span>] = <span class="number">4.2</span></span><br><span class="line">filters_np[<span class="number">2</span>, <span class="number">2</span>, <span class="number">2</span>, <span class="number">3</span>] = <span class="number">4.3</span></span><br><span class="line">filters = tf.constant(filters_np)</span><br><span class="line">out = tf.nn.depthwise_conv2d(</span><br><span class="line">      inputs,</span><br><span class="line">      filters,</span><br><span class="line">      strides=[<span class="number">1</span>,<span class="number">1</span>,<span class="number">1</span>,<span class="number">1</span>],</span><br><span class="line">      padding=<span class="string">&#x27;SAME&#x27;</span>)</span><br><span class="line"><span class="keyword">with</span> tf.Session() <span class="keyword">as</span> sess:</span><br><span class="line">    sess.run(tf.global_variables_initializer())</span><br><span class="line">    out_val = out.<span class="built_in">eval</span>()</span><br><span class="line"></span><br><span class="line"><span class="built_in">print</span>(<span class="string">&quot;output dim is &#123;&#125;&quot;</span>.<span class="built_in">format</span>(out_val.shape))</span><br><span class="line"><span class="built_in">print</span>(<span class="string">&quot;output cases 0 and 1 identical? &#123;&#125;&quot;</span>.<span class="built_in">format</span>(np.<span class="built_in">all</span>(out_val[<span class="number">0</span>]==out_val[<span class="number">1</span>])))</span><br><span class="line"><span class="built_in">print</span>(<span class="string">&quot;One of the pixels for each of the 12 output &#123;&#125;&quot;</span>.<span class="built_in">format</span>(out_val[<span class="number">0</span>, <span class="number">0</span>, <span class="number">0</span>]))</span><br><span class="line"><span class="comment"># Output:</span></span><br><span class="line"><span class="comment"># output dim is (2, 13, 13, 12)</span></span><br><span class="line"><span class="comment"># output cases 0 and 1 identical? True</span></span><br><span class="line"><span class="comment"># One of the pixels for each of the 12 output [2.  2.1 2.2 2.3 3.  3.1 3.2 3.3 4.  4.1 4.2 4.3]</span></span><br></pre></td></tr></table></figure><p>  <strong><code>PointwiseConvolution</code>其实就是普通的卷积，只不过采用1x1的卷积核</strong>。假设输入为<code>M*N*C</code>，原来的卷积为<code>conv3-k</code>，对应着<code>k</code>个<code>3x3</code>的卷积核，输出为<code>M*N*k</code>，现在将其进行改变成两步进行</p><ul><li>第一步：depthwise conv—输入为<code>M*N*C</code>，卷积为<code>conv3-1</code>，输出为<code>M*N*C</code></li><li>第二步：pointwise conv —输入为<code>M*N*C</code>，卷积为<code>conv1-k</code>，输出为<code>M*N*k</code></li></ul><p>  最终输出的<code>feature map</code>尺寸相同，但是会很大程度减少参数量。</p><p>  使用和普通卷积同样的参数进行演示，如下所示，输入的<code>feature map</code>的尺寸为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>12</mn><mo>×</mo><mn>12</mn><mo>×</mo><mn>4</mn></mrow></semantics></math></span></span></p><ul><li><p>第一步<code>DepthwiseConv</code>—卷积为<code>conv3-1</code>,</p><ul><li><p>计算量：<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>12</mn><mo>×</mo><mn>12</mn><mo>×</mo><mn>1</mn><mo>×</mo><mn>3</mn><mo>×</mo><mn>3</mn><mo>×</mo><mn>4</mn><mo>&#x3D;</mo><mn>5184</mn></mrow></semantics></math></span></span></p></li><li><p>参数量：<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>1</mn><mo>×</mo><mn>3</mn><mo>×</mo><mn>3</mn><mo>×</mo><mn>4</mn><mo>&#x3D;</mo><mn>36</mn></mrow></semantics></math></span></span></p><p>对<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>4</mn></mrow></semantics></math></span></span>个通道每个通道都与一个<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>3</mn><mo>×</mo><mn>3</mn></mrow></semantics></math></span></span>的卷积核计算</p></li><li><p>输出的特征图大小为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>12</mn><mo>×</mo><mn>12</mn><mo>×</mo><mn>4</mn></mrow></semantics></math></span></span></p></li></ul></li><li><p>第二步<code>PointwiseConv</code>-卷积为<code>conv1-2</code>，输入的尺寸为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>12</mn><mo>×</mo><mn>12</mn><mo>×</mo><mn>4</mn></mrow></semantics></math></span></span></p><ul><li>计算量：<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>12</mn><mo>×</mo><mn>12</mn><mo>×</mo><mn>2</mn><mo>×</mo><mo stretchy="false">(</mo><mn>1</mn><mo>×</mo><mn>1</mn><mo>×</mo><mn>4</mn><mo stretchy="false">)</mo><mo>&#x3D;</mo><mn>1152</mn></mrow></semantics></math></span></span></li><li>参数量： <span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>2</mn><mo>×</mo><mo stretchy="false">(</mo><mn>1</mn><mo>×</mo><mn>1</mn><mo>×</mo><mn>4</mn><mo stretchy="false">)</mo><mo>&#x3D;</mo><mn>8</mn></mrow></semantics></math></span></span></li><li>输出特征图大小为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>12</mn><mo>×</mo><mn>12</mn><mo>×</mo><mn>2</mn></mrow></semantics></math></span></span></li></ul></li></ul>  <img src="/2020/02/03/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-MobileNetV1-V3/mobilenet_cov2.png" class="" title="mobilenet"><p>  比较普通卷积计算方式和<code>mobilenet</code>的计算方式，可以看到参数量由<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>72</mn></mrow></semantics></math></span></span>较少到了<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>44</mn></mrow></semantics></math></span></span>；计算量由<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>10368</mn></mrow></semantics></math></span></span>减少到了<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>6336</mn></mrow></semantics></math></span></span>。</p><p>  深度可分离卷积可以看做是<code>InceptionNet</code>中的结构的极致设计，详细分析在这里<a href="https://zhuanlan.zhihu.com/p/29367273">👉👉👉</a></p><h3 id="网络参数"><a href="#网络参数" class="headerlink" title="网络参数"></a>网络参数</h3><p>对<code>Mobilenet</code>的网络参数如下图所示</p><hr>  <img src="/2020/02/03/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-MobileNetV1-V3/mobile_param.png" class="" title="mobilenet params"><hr><p>  除了在最后的全连接层没有使用非线性激活函数，其他层均使用<code>BN+Relu6</code>策略。</p><h2 id="MobileNetV2"><a href="#MobileNetV2" class="headerlink" title="MobileNetV2"></a>MobileNetV2</h2><p><a href="https://arxiv.org/abs/1801.04381">论文链接🔥 MobileNetV2: Inverted Residuals and Linear Bottlenecks</a></p><p>参考链接 </p><ul><li><a href="https://machinethink.net/blog/mobilenet-v2/">https://machinethink.net/blog/mobilenet-v2/</a> </li><li><a href="https://www.zybuluo.com/Team/note/1350161">https://www.zybuluo.com/Team/note/1350161</a></li></ul><h3 id="V2相比于V1版本的升级"><a href="#V2相比于V1版本的升级" class="headerlink" title="V2相比于V1版本的升级"></a>V2相比于V1版本的升级</h3><p>针对<code>MobileNet</code>进行升级，开发了<code>V2</code>版本，在<code>V1</code>版本中核心点是深度可分离卷积，在<code>MobileNetV2</code>中仍然采用的是深度可分离卷积，不同的是在此基础上又引入了残差结构以及<code>bottleneck</code>瓶颈层，<code>MobileNetV2</code>的可以看成一系列<strong>Bottleneck residual block</strong>的结构的堆叠，如下所示</p><hr><img src="/2020/02/03/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-MobileNetV1-V3/mobilenetv2-block.png" class="" title="MobileNetV2 Block"><hr><p>不同的点这里说明一下：</p><p>自上而下对<code>MobileNetV2</code>中使用的<code>Block</code>进行分析</p><ol><li><p><code>ExpansionLayer</code></p><p><strong>扩展层</strong>，这一部分使用的是<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>1</mn><mo>×</mo><mn>1</mn></mrow></semantics></math></span></span> 的卷积，作用是为了扩充输入当前Block的特征图的通道数量，因此，扩展层始终具有比输入通道更多的输出通道。通道数量的扩展量由扩展因子决定。这是一个超参数。默认扩展因子为6，也就是扩展通道数<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>6</mn></mrow></semantics></math></span></span>倍。</p></li><li><p>DepthwiseLayer</p><p>这里的深度卷积与<code>MobileNetV1</code>中是相同的，不变换通道的数量，这里主要是为了参数量。</p></li><li><p>ProjectionLayer</p><p>投影层。在这一层可以理解成pointwise，使用的是和<code>MobileNetV1</code>中相同的<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>1</mn><mo>×</mo><mn>1</mn></mrow></semantics></math></span></span>卷积，这里区别于MobileNetV1的地方：</p><ol><li>在MobileNetV1中，pointwise的输出通道数量保持不变或者加倍</li><li>在MobileNetV2中，输出通道数量减少</li></ol><p>这也是为什么在<code>MobileNetV2</code>中这一层被称作投影层。在这一层，通道数量减少，可以理解成创建了一个高纬度到低纬度的映射。</p></li></ol><p>每个Block的输出都是将输出的维度进行从高纬度到低纬度的变换，这也是每个block叫做<strong>bottleneck residual block</strong>的原因</p><hr>下图为MobileNetV2中Bottleneck residual block示意图。<img src="/2020/02/03/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-MobileNetV1-V3/MobilenetV2-ExpandProject.png" class="" title="MobileNetV2 Bottleneck"><p>假设输入的通道数为24，经过<code>expansion</code>层之后，扩展<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>6</mn></mrow></semantics></math></span></span>倍，变成<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>144</mn></mrow></semantics></math></span></span>层，经过<code>depthwise</code>层，通道层数不变，经过<code>projection</code>层,通道数变为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>24</mn></mrow></semantics></math></span></span>，使用<code>ResNet</code>相同的方式连接<code>Block</code>的输入和输出，也就是进出模块的的特征图是低纬度的，在<code>Block</code>内部则是高纬度的，这就是<code>MobileNetV2</code>中广泛使用的结构。<hr></p><p>在每个<code>Bllock</code>中，每个层都是<code>BN+Relu6</code>，除了最后一步的<code>ProjectionLayer</code>，在<code>ProjectionLayer</code>中没有使用激活函数，由于这一层的作用是进行从高通道数向低通道数的映射，使用非线性激活会使得有效信息丢失，在这里模型中使用的直接就是线性映射，没有使用激活函数。</p><p>整个<code>MobileNetV2</code>使用了<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>17</mn></mrow></semantics></math></span></span>个<code>Block</code>结构进行串联叠加（第1个Block稍有不同，它使用具有32个通道的常规<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>3</mn><mo>×</mo><mn>3</mn></mrow></semantics></math></span></span>卷积代替扩展层中的<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>1</mn><mo>×</mo><mn>1</mn></mrow></semantics></math></span></span>卷积)，最后就是标准的卷积核全局池化和分类层（这个是为适配图片识别任务，将MobileNetV2当做其他任务的基础网络的时候，这一部分不需要。）</p><h3 id="V2升级的动机"><a href="#V2升级的动机" class="headerlink" title="V2升级的动机"></a>V2升级的动机</h3><p>在V1中，模型设计的出发点是减少卷积的参数量并且减少计算量，即便使用更多的层数也没关系，因此在V1中引入了深度可分离卷积，事实证明这个方法是可行的，在V2中，相比与V1的变化主要在借鉴ResNet的残差连接和Block中的ExpansionLayer和ProjectionLayer。</p><p>分析MobileNetV2的结构可以看到，在整个模型中各个Block之间数据的通道数都是很小的</p><img src="/2020/02/03/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-MobileNetV1-V3/MobileNetV2-LowDimensionality.png" class=""><p>由于ProjectionLayer的存在，使得相邻Block之间传递的数据维度很小，这很大程度减少了模型的计算量。但是只使用低纬度的数据特征，无法有效的提高模型的准确性，这个问题由ExpansionLayer来解决，该层的设计使得在每个Block中扩大输入当前特征图通道的数量，并且由于残差模块的存在，该层能够显著的提高模型的表达能力。</p><p>一个很有意思的解释：ProjectionLayer可以理解成为了减少计算量对数据进行的压缩，ExpansionLayer可以理解成为为了更好的表达特征图，对压缩过的数据进行解压缩，流经Depthwise的数据可以看做是真实的数据维度。</p><img src="/2020/02/03/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-MobileNetV1-V3/MobileNetV2-Compression.png" class=""><p>从图中可以看出，在每个<code>Blcok</code>模块中首尾链接，内部对数据解压缩(<code>expansion</code>)，进行<code>depthwise</code>卷积操作，然后对数据进行压缩(<code>projection</code>)，传递到下一个<code>block</code>中。</p><hr><img src="/2020/02/03/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-MobileNetV1-V3/mobilnetv2-params.png" class=""><p>如上所示便是MobileNetV2的模型结构，t表示的是expansion层的扩展系数，c是输出的通道数，n表示当前block重复了几次，s表示步长<hr></p><h3 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h3><p>先上图，这是MobileNetV2和其他移动端模型的对比。</p><hr><img src="/2020/02/03/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-MobileNetV1-V3/comparison.png" class=""><hr><p>MobileNetV2是在V1的基础上升级而来，当然它的竞品是其他的轻量卷积模型shufflenet，nasnet这些。</p><hr><img src="/2020/02/03/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-MobileNetV1-V3/mobilenetv2-compare.png" class=""><hr><p>在对比指标中可以看出来，MobileNetV2相比于几个网络时更有优势的。</p><h2 id="MobilenetV3"><a href="#MobilenetV3" class="headerlink" title="MobilenetV3"></a>MobilenetV3</h2><h2 id="参考链接"><a href="#参考链接" class="headerlink" title="参考链接"></a>参考链接</h2><ol><li>官方代码 <a href="https://github.com/tensorflow/models/tree/master/research/slim/nets/mobilenet">https://github.com/tensorflow/models/tree/master/research/slim/nets/mobilenet</a></li></ol>]]>
    </content>
    <id>https://xiaofengshi.com/2020/02/03/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-MobileNetV1-V3/</id>
    <link href="https://xiaofengshi.com/2020/02/03/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-MobileNetV1-V3/"/>
    <published>2020-02-03T21:16:01.000Z</published>
    <summary>
      <![CDATA[<img src="/2020/02/03/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-ConvNet-MobileNetV1-V3/pose_estimation.gif" class="" title="Pose estimation">

<p>本篇主要对目前流行的移动端轻量化网络MobileNet进行分析。</p>
<p>最近一段时间由于工作需要，想要将服务端的模型迁移到移动端，突然发现一个尴尬的现实，服务端的大模型在移动端是很难跑起来的。随着5G技术的到来，端上设备越来越强悍，将模型做到移动端是一个很显然的大趋势。目前的移动端模型 ( <a href="https://www.tensorflow.org/lite/models/">https://www.tensorflow.org/lite/models/</a> )，主要跑的是CV相关方面的识别，检测模型，姿态预估等相对简单的模型，并且目前的模型很多是基于<code>MobileNet</code>这一网络的，本篇就主要针对<code>Mobilenet</code>进行研究分析。</p>]]>
    </summary>
    <title>深度学习-ConvNet-MobileNetV1-V3</title>
    <updated>2020-02-16T22:16:57.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Xiaofeng Shi</name>
    </author>
    <category term="Awesomes" scheme="https://xiaofengshi.com/categories/Awesomes/"/>
    <category term="Python" scheme="https://xiaofengshi.com/categories/Awesomes/Python/"/>
    <category term="Python" scheme="https://xiaofengshi.com/tags/Python/"/>
    <content>
      <![CDATA[<p>本篇涉及平时工作中使用的一些<strong>Python</strong>相关轮子，在此记录，不断补充更新……</p><img src="/2020/01/29/Awesomes-Python/python.png" class="" title="Python"><span id="more"></span><h2 id="文件及路径"><a href="#文件及路径" class="headerlink" title="文件及路径"></a>文件及路径</h2><h3 id="遍历读取文件夹下所有目录"><a href="#遍历读取文件夹下所有目录" class="headerlink" title="遍历读取文件夹下所有目录"></a>遍历读取文件夹下所有目录</h3><p>在<code>Python</code>中使用<code>os.path.lisdir()</code>可以实现读取给定路径下的所有文件，并返回文件名列表，在给定的路径下，有可能存在着子目录，这个时候我们想要读取子目录下的文件又该如何处理呢</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># encoding:utf-8</span></span><br><span class="line"></span><br><span class="line"><span class="keyword">import</span> os</span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">readDir</span>(<span class="params">dirPath</span>):</span><br><span class="line">    <span class="keyword">if</span> dirPath[-<span class="number">1</span>] == <span class="string">&#x27;/&#x27;</span>:</span><br><span class="line">        <span class="built_in">print</span>( <span class="string">u&#x27;文件夹路径末尾不能加/&#x27;</span>)</span><br><span class="line">        <span class="keyword">return</span></span><br><span class="line">    allFiles = []</span><br><span class="line">    <span class="comment"># 判断给定的路径是否是一个路径</span></span><br><span class="line">    <span class="keyword">if</span> os.path.isdir(dirPath):</span><br><span class="line">      <span class="comment"># 获取当前路径下所有的所有文件</span></span><br><span class="line">        fileList = os.listdir(dirPath)</span><br><span class="line">        <span class="keyword">for</span> f <span class="keyword">in</span> fileList:</span><br><span class="line">            full_path = os.path.join(dirPath, f)</span><br><span class="line">            <span class="keyword">if</span> os.path.isdir(full_path):</span><br><span class="line">                <span class="comment"># 如果存在子目录，递归调用读取函数</span></span><br><span class="line">                subFiles = readDir(full_path)</span><br><span class="line">                allFiles = subFiles + allFiles <span class="comment">#合并当前目录与子目录的所有文件路径</span></span><br><span class="line">            <span class="keyword">else</span>:</span><br><span class="line">                allFiles.append(full_path)</span><br><span class="line">        <span class="keyword">return</span> allFiles</span><br><span class="line">    <span class="keyword">else</span>:</span><br><span class="line">        <span class="keyword">return</span> <span class="string">&#x27;Error,not a dir&#x27;</span></span><br><span class="line"></span><br></pre></td></tr></table></figure><p>如上是对文件进行读取，当读取文件之后，如果文件是<code>.txt</code>文件，那么读取这个文件的内容并打印</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># encoding:utf-8</span></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">readTxt</span> (filePath):</span><br><span class="line">    <span class="keyword">with</span> <span class="built_in">open</span>(filePath) <span class="keyword">as</span> f:</span><br><span class="line">        lines = f.readlines()</span><br><span class="line">        <span class="keyword">for</span> line <span class="keyword">in</span> lines:</span><br><span class="line">            data = line.strip().split(<span class="string">&#x27;\001&#x27;</span>) <span class="comment">#以列表形式返回分割了的行数据</span></span><br><span class="line">                <span class="keyword">for</span> i <span class="keyword">in</span> data:</span><br><span class="line">                <span class="built_in">print</span> i</span><br><span class="line">             </span><br><span class="line"><span class="keyword">if</span> __name__ == <span class="string">&#x27;__main__&#x27;</span>:</span><br><span class="line">    dirPath = <span class="string">&#x27;xxxx&#x27;</span></span><br><span class="line">    fileList=ReadDirFiles.readDir(dirPath)</span><br><span class="line">    <span class="keyword">for</span> f <span class="keyword">in</span> fileList:</span><br><span class="line">    <span class="keyword">if</span> f.split(<span class="string">&#x27;.&#x27;</span>)[-<span class="number">1</span>] <span class="keyword">in</span> [<span class="string">&#x27;txt&#x27;</span>]:</span><br><span class="line">    readTxt(f)</span><br></pre></td></tr></table></figure><h2 id="PANDAS"><a href="#PANDAS" class="headerlink" title="PANDAS"></a>PANDAS</h2><h3 id="CSV2LIST"><a href="#CSV2LIST" class="headerlink" title="CSV2LIST"></a>CSV2LIST</h3><p><code>csv</code>是很常用的数据存储方式，推荐使用<code>pandas</code>读取，<code>pandas</code>真是一个非常棒的数据分析工具，说回本例，数据存储在<code>csv</code>文件中，读取里面的一列或者某几列存储为列表格式</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">import</span> pandas <span class="keyword">as</span> pd</span><br><span class="line">csv_file=<span class="string">&#x27;Pandas_example_read.csv&#x27;</span></span><br><span class="line"><span class="comment"># 默认使用第一行作为列的名称</span></span><br><span class="line">df_example=pd.read_csv(filepath,header=<span class="number">0</span>)</span><br><span class="line"><span class="comment"># csv存在标题但是想换成自己的标题</span></span><br><span class="line">df_example = pd.read_csv(<span class="string">&#x27;Pandas_example_read.csv&#x27;</span>，names=[<span class="string">&#x27;A&#x27;</span>,<span class="string">&#x27;B&#x27;</span>,<span class="string">&#x27;C&#x27;</span>]) </span><br><span class="line"></span><br><span class="line"><span class="comment"># CSV没有标题，第一行就是数据，这样读取的时候要设置header</span></span><br><span class="line">df_example_noCols = pd.read_csv(<span class="string">&#x27;Pandas_example_read_withoutCols.csv&#x27;</span>, header=<span class="literal">None</span>)</span><br><span class="line"></span><br><span class="line"><span class="comment"># csv没有标题，读的时候加上标题，操作方法和有标题相同</span></span><br><span class="line">df_example_noCols = pd.read_csv(<span class="string">&#x27;Pandas_example_read_withoutCols.csv&#x27;</span>, names=[<span class="string">&#x27;A&#x27;</span>, <span class="string">&#x27;B&#x27;</span>,<span class="string">&#x27;C&#x27;</span>])</span><br><span class="line"></span><br><span class="line"><span class="comment"># key 对应的是要提取的列的header</span></span><br><span class="line">select=df_example[<span class="string">&#x27;key&#x27;</span>].tolist()</span><br></pre></td></tr></table></figure><h2 id="图片处理"><a href="#图片处理" class="headerlink" title="图片处理"></a>图片处理</h2><h3 id="Canny边缘检测"><a href="#Canny边缘检测" class="headerlink" title="Canny边缘检测"></a>Canny边缘检测</h3><p>参考：<strong><a href="https://mp.weixin.qq.com/s/ejwnsPkrpSJieCPssU8Caw">https://mp.weixin.qq.com/s/ejwnsPkrpSJieCPssU8Caw</a></strong></p><p>主要涉及如下几个操作</p><ul><li>降噪</li><li>梯度计算</li><li>非最大抑制</li><li>双重阈值</li><li>滞后边缘跟踪</li></ul><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br><span class="line">51</span><br><span class="line">52</span><br><span class="line">53</span><br><span class="line">54</span><br><span class="line">55</span><br><span class="line">56</span><br><span class="line">57</span><br><span class="line">58</span><br><span class="line">59</span><br><span class="line">60</span><br><span class="line">61</span><br><span class="line">62</span><br><span class="line">63</span><br><span class="line">64</span><br><span class="line">65</span><br><span class="line">66</span><br><span class="line">67</span><br><span class="line">68</span><br><span class="line">69</span><br><span class="line">70</span><br><span class="line">71</span><br><span class="line">72</span><br><span class="line">73</span><br><span class="line">74</span><br><span class="line">75</span><br><span class="line">76</span><br><span class="line">77</span><br><span class="line">78</span><br><span class="line">79</span><br><span class="line">80</span><br><span class="line">81</span><br><span class="line">82</span><br><span class="line">83</span><br><span class="line">84</span><br><span class="line">85</span><br><span class="line">86</span><br><span class="line">87</span><br><span class="line">88</span><br><span class="line">89</span><br><span class="line">90</span><br><span class="line">91</span><br><span class="line">92</span><br><span class="line">93</span><br><span class="line">94</span><br><span class="line">95</span><br><span class="line">96</span><br><span class="line">97</span><br><span class="line">98</span><br><span class="line">99</span><br><span class="line">100</span><br><span class="line">101</span><br><span class="line">102</span><br><span class="line">103</span><br><span class="line">104</span><br><span class="line">105</span><br><span class="line">106</span><br><span class="line">107</span><br><span class="line">108</span><br><span class="line">109</span><br><span class="line">110</span><br><span class="line">111</span><br><span class="line">112</span><br><span class="line">113</span><br><span class="line">114</span><br><span class="line">115</span><br><span class="line">116</span><br><span class="line">117</span><br><span class="line">118</span><br><span class="line">119</span><br><span class="line">120</span><br><span class="line">121</span><br><span class="line">122</span><br><span class="line">123</span><br><span class="line">124</span><br><span class="line">125</span><br><span class="line">126</span><br><span class="line">127</span><br><span class="line">128</span><br><span class="line">129</span><br><span class="line">130</span><br><span class="line">131</span><br><span class="line">132</span><br><span class="line">133</span><br><span class="line">134</span><br><span class="line">135</span><br><span class="line">136</span><br><span class="line">137</span><br><span class="line">138</span><br><span class="line">139</span><br><span class="line">140</span><br><span class="line">141</span><br><span class="line">142</span><br><span class="line">143</span><br><span class="line">144</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">from</span> scipy <span class="keyword">import</span> ndimage</span><br><span class="line"><span class="keyword">from</span> scipy.ndimage.filters <span class="keyword">import</span> convolve</span><br><span class="line"></span><br><span class="line"><span class="keyword">from</span> scipy <span class="keyword">import</span> misc</span><br><span class="line"><span class="keyword">import</span> numpy <span class="keyword">as</span> np</span><br><span class="line"></span><br><span class="line"><span class="keyword">class</span> <span class="title class_">cannyEdgeDetector</span>:</span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">__init__</span>(<span class="params">self, imgs, sigma=<span class="number">1</span>, kernel_size=<span class="number">5</span>, weak_pixel=<span class="number">75</span>, strong_pixel=<span class="number">255</span>, lowthreshold=<span class="number">0.05</span>, highthreshold=<span class="number">0.15</span></span>):</span><br><span class="line">        self.imgs = imgs</span><br><span class="line">        self.imgs_final = []</span><br><span class="line">        self.img_smoothed = <span class="literal">None</span></span><br><span class="line">        self.gradientMat = <span class="literal">None</span></span><br><span class="line">        self.thetaMat = <span class="literal">None</span> </span><br><span class="line">        self.nonMaxImg = <span class="literal">None</span></span><br><span class="line">        self.thresholdImg = <span class="literal">None</span></span><br><span class="line">        self.weak_pixel = weak_pixel</span><br><span class="line">        self.strong_pixel = strong_pixel</span><br><span class="line">        self.sigma = sigma</span><br><span class="line">        self.kernel_size = kernel_size</span><br><span class="line">        self.lowThreshold = lowthreshold</span><br><span class="line">        self.highThreshold = highthreshold</span><br><span class="line">        <span class="keyword">return</span> </span><br><span class="line">    <span class="comment"># 创建高斯核函数</span></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">gaussian_kernel</span>(<span class="params">self, size, sigma=<span class="number">1</span></span>):</span><br><span class="line">        size = <span class="built_in">int</span>(size) // <span class="number">2</span></span><br><span class="line">        x, y = np.mgrid[-size:size+<span class="number">1</span>, -size:size+<span class="number">1</span>]</span><br><span class="line">        normal = <span class="number">1</span> / (<span class="number">2.0</span> * np.pi * sigma**<span class="number">2</span>)</span><br><span class="line">        g =  np.exp(-((x**<span class="number">2</span> + y**<span class="number">2</span>) / (<span class="number">2.0</span>*sigma**<span class="number">2</span>))) * normal</span><br><span class="line">        <span class="keyword">return</span> g</span><br><span class="line">    <span class="comment"># 梯度计算步骤通过使用边缘检测算子计算图像的梯度来检测边缘强度和方向。</span></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">sobel_filters</span>(<span class="params">self, img</span>):</span><br><span class="line">        Kx = np.array([[-<span class="number">1</span>, <span class="number">0</span>, <span class="number">1</span>], [-<span class="number">2</span>, <span class="number">0</span>, <span class="number">2</span>], [-<span class="number">1</span>, <span class="number">0</span>, <span class="number">1</span>]], np.float32)</span><br><span class="line">        Ky = np.array([[<span class="number">1</span>, <span class="number">2</span>, <span class="number">1</span>], [<span class="number">0</span>, <span class="number">0</span>, <span class="number">0</span>], [-<span class="number">1</span>, -<span class="number">2</span>, -<span class="number">1</span>]], np.float32)</span><br><span class="line"></span><br><span class="line">        Ix = ndimage.filters.convolve(img, Kx)</span><br><span class="line">        Iy = ndimage.filters.convolve(img, Ky)</span><br><span class="line"></span><br><span class="line">        G = np.hypot(Ix, Iy)</span><br><span class="line">        G = G / G.<span class="built_in">max</span>() * <span class="number">255</span></span><br><span class="line">        theta = np.arctan2(Iy, Ix)</span><br><span class="line">        <span class="keyword">return</span> (G, theta)</span><br><span class="line">    </span><br><span class="line"><span class="comment"># 非最大抑制步骤是：</span></span><br><span class="line">    <span class="comment"># 创建一个初始化为0的矩阵，该矩阵与原始梯度强度矩阵的大小相同;</span></span><br><span class="line">    <span class="comment"># 根据角度矩阵的角度值识别边缘方向;</span></span><br><span class="line">    <span class="comment"># 检查相同方向的像素是否具有比当前处理的像素更高的强度;</span></span><br><span class="line">    <span class="comment"># 返回使用非最大抑制算法处理的图像。</span></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">non_max_suppression</span>(<span class="params">self, img, D</span>):</span><br><span class="line">        M, N = img.shape</span><br><span class="line">        Z = np.zeros((M,N), dtype=np.int32)</span><br><span class="line">        angle = D * <span class="number">180.</span> / np.pi</span><br><span class="line">        angle[angle &lt; <span class="number">0</span>] += <span class="number">180</span></span><br><span class="line"></span><br><span class="line"></span><br><span class="line">        <span class="keyword">for</span> i <span class="keyword">in</span> <span class="built_in">range</span>(<span class="number">1</span>,M-<span class="number">1</span>):</span><br><span class="line">            <span class="keyword">for</span> j <span class="keyword">in</span> <span class="built_in">range</span>(<span class="number">1</span>,N-<span class="number">1</span>):</span><br><span class="line">                <span class="keyword">try</span>:</span><br><span class="line">                    q = <span class="number">255</span></span><br><span class="line">                    r = <span class="number">255</span></span><br><span class="line"></span><br><span class="line">                   <span class="comment">#angle 0</span></span><br><span class="line">                    <span class="keyword">if</span> (<span class="number">0</span> &lt;= angle[i,j] &lt; <span class="number">22.5</span>) <span class="keyword">or</span> (<span class="number">157.5</span> &lt;= angle[i,j] &lt;= <span class="number">180</span>):</span><br><span class="line">                        q = img[i, j+<span class="number">1</span>]</span><br><span class="line">                        r = img[i, j-<span class="number">1</span>]</span><br><span class="line">                    <span class="comment">#angle 45</span></span><br><span class="line">                    <span class="keyword">elif</span> (<span class="number">22.5</span> &lt;= angle[i,j] &lt; <span class="number">67.5</span>):</span><br><span class="line">                        q = img[i+<span class="number">1</span>, j-<span class="number">1</span>]</span><br><span class="line">                        r = img[i-<span class="number">1</span>, j+<span class="number">1</span>]</span><br><span class="line">                    <span class="comment">#angle 90</span></span><br><span class="line">                    <span class="keyword">elif</span> (<span class="number">67.5</span> &lt;= angle[i,j] &lt; <span class="number">112.5</span>):</span><br><span class="line">                        q = img[i+<span class="number">1</span>, j]</span><br><span class="line">                        r = img[i-<span class="number">1</span>, j]</span><br><span class="line">                    <span class="comment">#angle 135</span></span><br><span class="line">                    <span class="keyword">elif</span> (<span class="number">112.5</span> &lt;= angle[i,j] &lt; <span class="number">157.5</span>):</span><br><span class="line">                        q = img[i-<span class="number">1</span>, j-<span class="number">1</span>]</span><br><span class="line">                        r = img[i+<span class="number">1</span>, j+<span class="number">1</span>]</span><br><span class="line"></span><br><span class="line">                    <span class="keyword">if</span> (img[i,j] &gt;= q) <span class="keyword">and</span> (img[i,j] &gt;= r):</span><br><span class="line">                        Z[i,j] = img[i,j]</span><br><span class="line">                    <span class="keyword">else</span>:</span><br><span class="line">                        Z[i,j] = <span class="number">0</span></span><br><span class="line"></span><br><span class="line"></span><br><span class="line">                <span class="keyword">except</span> IndexError <span class="keyword">as</span> e:</span><br><span class="line">                    <span class="keyword">pass</span></span><br><span class="line"></span><br><span class="line">        <span class="keyword">return</span> Z</span><br><span class="line"></span><br><span class="line">    <span class="comment"># 双阈值步骤旨在识别3种像素：强，弱和不相关：</span></span><br><span class="line">    <span class="comment"># 强像素是强度如此之高的像素，我们确信它们有助于最终边缘。</span></span><br><span class="line">    <span class="comment"># 弱像素是具有不足以被视为强的强度值的像素，但是还不足以被认为与边缘检测不相关。其他像素被认为与边缘无关。</span></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">threshold</span>(<span class="params">self, img</span>):</span><br><span class="line"></span><br><span class="line">        highThreshold = img.<span class="built_in">max</span>() * self.highThreshold;</span><br><span class="line">        lowThreshold = highThreshold * self.lowThreshold;</span><br><span class="line"></span><br><span class="line">        M, N = img.shape</span><br><span class="line">        res = np.zeros((M,N), dtype=np.int32)</span><br><span class="line"></span><br><span class="line">        weak = np.int32(self.weak_pixel)</span><br><span class="line">        strong = np.int32(self.strong_pixel)</span><br><span class="line"></span><br><span class="line">        strong_i, strong_j = np.where(img &gt;= highThreshold)</span><br><span class="line">        zeros_i, zeros_j = np.where(img &lt; lowThreshold)</span><br><span class="line"></span><br><span class="line">        weak_i, weak_j = np.where((img &lt;= highThreshold) &amp; (img &gt;= lowThreshold))</span><br><span class="line"></span><br><span class="line">        res[strong_i, strong_j] = strong</span><br><span class="line">        res[weak_i, weak_j] = weak</span><br><span class="line"></span><br><span class="line">        <span class="keyword">return</span> (res)</span><br><span class="line"><span class="comment"># 滞后边缘跟踪</span></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">hysteresis</span>(<span class="params">self, img</span>):</span><br><span class="line"></span><br><span class="line">        M, N = img.shape</span><br><span class="line">        weak = self.weak_pixel</span><br><span class="line">        strong = self.strong_pixel</span><br><span class="line"></span><br><span class="line">        <span class="keyword">for</span> i <span class="keyword">in</span> <span class="built_in">range</span>(<span class="number">1</span>, M-<span class="number">1</span>):</span><br><span class="line">            <span class="keyword">for</span> j <span class="keyword">in</span> <span class="built_in">range</span>(<span class="number">1</span>, N-<span class="number">1</span>):</span><br><span class="line">                <span class="keyword">if</span> (img[i,j] == weak):</span><br><span class="line">                    <span class="keyword">try</span>:</span><br><span class="line">                        <span class="keyword">if</span> ((img[i+<span class="number">1</span>, j-<span class="number">1</span>] == strong) <span class="keyword">or</span> (img[i+<span class="number">1</span>, j] == strong) <span class="keyword">or</span> (img[i+<span class="number">1</span>, j+<span class="number">1</span>] == strong)</span><br><span class="line">                            <span class="keyword">or</span> (img[i, j-<span class="number">1</span>] == strong) <span class="keyword">or</span> (img[i, j+<span class="number">1</span>] == strong)</span><br><span class="line">                            <span class="keyword">or</span> (img[i-<span class="number">1</span>, j-<span class="number">1</span>] == strong) <span class="keyword">or</span> (img[i-<span class="number">1</span>, j] == strong) <span class="keyword">or</span> (img[i-<span class="number">1</span>, j+<span class="number">1</span>] == strong)):</span><br><span class="line">                            img[i, j] = strong</span><br><span class="line">                        <span class="keyword">else</span>:</span><br><span class="line">                            img[i, j] = <span class="number">0</span></span><br><span class="line">                    <span class="keyword">except</span> IndexError <span class="keyword">as</span> e:</span><br><span class="line">                        <span class="keyword">pass</span></span><br><span class="line"></span><br><span class="line">        <span class="keyword">return</span> img</span><br><span class="line">    </span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">detect</span>(<span class="params">self</span>):</span><br><span class="line">        imgs_final = []</span><br><span class="line">        <span class="keyword">for</span> i, img <span class="keyword">in</span> <span class="built_in">enumerate</span>(self.imgs):    </span><br><span class="line">            self.img_smoothed = convolve(img, self.gaussian_kernel(self.kernel_size, self.sigma))</span><br><span class="line">            self.gradientMat, self.thetaMat = self.sobel_filters(self.img_smoothed)</span><br><span class="line">            self.nonMaxImg = self.non_max_suppression(self.gradientMat, self.thetaMat)</span><br><span class="line">            self.thresholdImg = self.threshold(self.nonMaxImg)</span><br><span class="line">            img_final = self.hysteresis(self.thresholdImg)</span><br><span class="line">            self.imgs_final.append(img_final)</span><br><span class="line"></span><br><span class="line">        <span class="keyword">return</span> self.imgs_final</span><br></pre></td></tr></table></figure><h3 id="降噪"><a href="#降噪" class="headerlink" title="降噪"></a>降噪</h3><p>由于场景背后涉及的数学主要基于导数（参见步骤2：梯度计算），边缘检测结果对图像噪声高度敏感。摆脱图像噪声的一种方法是使用高斯模糊来平滑它。为此图像卷积技术应用高斯核（3x3,5x5,7x7等…）。内核大小取决于预期的模糊效果。基本上内核最小，模糊不太明显。</p><h3 id="判断图像是否模糊"><a href="#判断图像是否模糊" class="headerlink" title="判断图像是否模糊"></a>判断图像是否模糊</h3><p>Reference:<a href="https://juejin.im/post/5b76df76f265da43330c3f50">https://juejin.im/post/5b76df76f265da43330c3f50</a></p><p>将图像转换成灰度图，之后使用拉普拉斯算子进行滤波，得到的是图像的高频图像，会将低频图像去掉，计算滤波之后的图像的方差，如果方差较大，认为滤波之后的图像具有更广阔的频率范围，认为是一个清晰的图像； 如果滤波之后方差较小，可以认为，经过滤波得到的图像，频率范围很窄，可以在一定程度上认为这是一个模糊的图像。总而言之，是通过拉普拉斯滤波之后的图像的方差的值进行判断。</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">import</span> cv2</span><br><span class="line"><span class="keyword">def</span> <span class="title function_">getImageVar</span>(<span class="params">imgPath</span>):</span><br><span class="line">image = cv2.imread(imgPath);</span><br><span class="line">img2gray = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)</span><br><span class="line">imageVar = cv2.Laplacian(img2gray, cv2.CV_64F).var()</span><br><span class="line"></span><br><span class="line"><span class="keyword">return</span> imageVar</span><br></pre></td></tr></table></figure><p><strong>但是会存在一个问题，那就是对于远景虚化或者远景模糊的图像，经过滤波之后，得到的图像会将虚化部分过滤掉，这样相比于正常的清晰照片，得到的图像的方差较低，有可能会被误杀。</strong></p><h2 id="IOU的计算"><a href="#IOU的计算" class="headerlink" title="IOU的计算"></a>IOU的计算</h2><p>在<code>ObjectDetection</code>任务中，在后处理阶段一般要进行<code>NMS</code>处理，也就是需要计算两个<code>box</code>之间的<code>IOU</code>，顾明思议，<code>IOU</code>就是两个矩形交集面积与并集面积的比值，比值的范围为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mo stretchy="false">[</mo><mn>0</mn><mo separator="true">,</mo><mn>1</mn><mo stretchy="false">]</mo></mrow></semantics></math></span></span>，比值越大，表示两个矩形越相同。</p><p>代码实现</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">#coding=utf-8</span></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">_cal_iou</span>(<span class="params">query_box, store_box</span>):</span><br><span class="line">  <span class="comment"># @query_box is a list, contains the cordinates for the leftup and rightdown corner</span></span><br><span class="line">    <span class="comment"># left_x,left_y,right_x,right_y=query_box</span></span><br><span class="line">    <span class="comment"># @store_box is a list, each element is a box</span></span><br><span class="line">    <span class="comment"># return，ratios between query and store boxes</span></span><br><span class="line">    x1, y1, x2, y2 = query_box</span><br><span class="line">    w1 = x2 - x1</span><br><span class="line">    h1 = y2 - y1</span><br><span class="line">    query_area = w1 * h1</span><br><span class="line">    ratios = []</span><br><span class="line">    <span class="keyword">for</span> box <span class="keyword">in</span> store_box:</span><br><span class="line">        x_11, y_11, x_22, y_22 = box</span><br><span class="line">        w_11 = x_22 - x_11</span><br><span class="line">        h_11 = y_22 - y_11</span><br><span class="line">        store_area = w_11*h_11</span><br><span class="line">        </span><br><span class="line">        endx = <span class="built_in">max</span>(x2, x_22)</span><br><span class="line">        startx = <span class="built_in">min</span>(x1, x_11)</span><br><span class="line">        width = w1 + w_11 - (endx - startx)</span><br><span class="line">        </span><br><span class="line">        endy = <span class="built_in">max</span>(y2, y_22)</span><br><span class="line">        starty = <span class="built_in">min</span>(y1, y_11)</span><br><span class="line">        height = h1 + h_11 - (endy - starty)</span><br><span class="line"></span><br><span class="line">        <span class="keyword">if</span> width &lt;= <span class="number">0</span> <span class="keyword">or</span> height &lt;= <span class="number">0</span>:</span><br><span class="line">            ratio = <span class="number">0</span></span><br><span class="line">        <span class="keyword">else</span>:</span><br><span class="line">            inter_area = width * height</span><br><span class="line">            ratio = inter_area / (query_area + store_area - inter_area)</span><br><span class="line">        ratios.append(ratio)</span><br><span class="line">    <span class="keyword">return</span> ratios</span><br></pre></td></tr></table></figure><h2 id="数据转换Convertation"><a href="#数据转换Convertation" class="headerlink" title="数据转换Convertation"></a>数据转换Convertation</h2><h3 id="String-List"><a href="#String-List" class="headerlink" title="String&amp;List"></a>String&amp;List</h3><p>该程序涉及将字符串转换为<code>list</code>，这里的字符串不是简单地字符串，是具有数据格式的字符串，如下所示</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">demo=<span class="string">&#x27;[&#123;&quot;label&quot;:0,&quot;dots&quot;:[&#123;&quot;x&quot;:109.60000000000001,&quot;y&quot;:7.466666666666667&#125;,&#123;&quot;x&quot;:311.2,&quot;y&quot;:7.466666666666667&#125;,&#123;&quot;x&quot;:311.2,&quot;y&quot;:197.33333333333334&#125;,&#123;&quot;x&quot;:109.60000000000001,&quot;y&quot;:197.33333333333334&#125;]&#125;]&#x27;</span></span><br></pre></td></tr></table></figure><p>可以看出来，虽然整体是一个<code>string</code>的格式，但是内部实际上是列表，并且列表内是一个字典，那么如何将这个字符串转换成列表，并且能够读取列表中的字典呢？</p><p>很简单，使用依赖包<code>ast</code></p><p>处理代码如下所示</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">## import package</span></span><br><span class="line"><span class="keyword">from</span> ast <span class="keyword">import</span> literal_eval</span><br><span class="line"><span class="comment">##<span class="doctag">NOTE:</span> turn string to list</span></span><br><span class="line">mlist = literal_eval(demo)</span><br><span class="line"><span class="keyword">assert</span> <span class="built_in">isinstance</span>(mlist,<span class="built_in">list</span>)， <span class="string">&quot;After literal_eval, must return a list&quot;</span></span><br><span class="line">out=[]</span><br><span class="line"><span class="keyword">for</span> dic <span class="keyword">in</span> mlist:</span><br><span class="line">    want=dic[<span class="string">&#x27;dots&#x27;</span>]</span><br><span class="line">    keys=[<span class="string">&#x27;x&#x27;</span>,<span class="string">&#x27;y&#x27;</span>]</span><br><span class="line">    <span class="keyword">for</span> each_points <span class="keyword">in</span> want:</span><br><span class="line">        <span class="keyword">for</span> key <span class="keyword">in</span> keys:</span><br><span class="line">            out.append(each_points[key])</span><br><span class="line"><span class="built_in">print</span> out</span><br></pre></td></tr></table></figure><p>经过如上程序，就可以得到列表</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">[109.60000000000001, 7.466666666666667, 311.2, 7.466666666666667, 311.2, 197.33333333333334, 109.60000000000001, 197.33333333333334]</span><br></pre></td></tr></table></figure><p>对应的<code>jupyter</code>程序截图如下</p><img src="/2020/01/29/Awesomes-Python/string_to_list.png" class="" title="string to image"><h3 id="Dict-Object"><a href="#Dict-Object" class="headerlink" title="Dict&amp;Object"></a>Dict&amp;Object</h3><p>在<code>Object</code>中直接调用<code>object.__dict__</code>就可以得到当前object的dictionary形式</p><img src="/2020/01/29/Awesomes-Python/object_dict.png" class="" title="Get dictionary from object"><p>当然了，还要有反向操作，就是将<code>dictionary</code>转换成<code>struct</code>形式，通过一个转换方程</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">class</span> <span class="title class_">Struct</span>(<span class="title class_ inherited__">object</span>):</span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">__init__</span>(<span class="params">self, d</span>):</span><br><span class="line">        <span class="keyword">for</span> a, b <span class="keyword">in</span> d.items():</span><br><span class="line">            <span class="keyword">if</span> <span class="built_in">isinstance</span>(b, (<span class="built_in">list</span>, <span class="built_in">tuple</span>)):</span><br><span class="line">               <span class="built_in">setattr</span>(self, a, [Struct(x) <span class="keyword">if</span> <span class="built_in">isinstance</span>(x, <span class="built_in">dict</span>) <span class="keyword">else</span> x <span class="keyword">for</span> x <span class="keyword">in</span> b])</span><br><span class="line">            <span class="keyword">else</span>:</span><br><span class="line">               <span class="built_in">setattr</span>(self, a, Struct(b) <span class="keyword">if</span> <span class="built_in">isinstance</span>(b, <span class="built_in">dict</span>) <span class="keyword">else</span> b)</span><br></pre></td></tr></table></figure><p>对应的<code>jupyter</code>测试程序如下所示↓↓↓↓</p><img src="/2020/01/29/Awesomes-Python/dict_obj.png" class="" title="Convet dictionary to struct"><h3 id="数据序列化"><a href="#数据序列化" class="headerlink" title="数据序列化"></a>数据序列化</h3><p>在进行传输的过程中，一般对数据进行序列化，比如在图片转化成base64格式，tcp传输使用pb或protobuf格式等，根据自己工作的经验，对这方面进行一下总结记录。</p><h4 id="pickle-cPickle"><a href="#pickle-cPickle" class="headerlink" title="pickle&amp;cPickle"></a>pickle&amp;cPickle</h4><p>使用<code>pickle.dumps</code>和<code>pickle.loads</code>的方式进行序列化和反序列化</p><p><code>Python</code>中提供了<code>pickle</code>和<code>cPickle</code>两个模块，<code>cPickle</code>顾名思义使用C编译的，运行速度更快，但是cPickle模块中定义的类型不能被继承（其实大多数时候，我们不需要从这些类型中继承，推荐使用cPickle）。<code>cPickle</code>和<code>pickle</code>的序列化&#x2F;反序列化规则是一样的，使用<code>pickle</code>序列化一个对象，可以使用<code>cPickle</code>来反序列化。同时，这两个模块在处理自引用类型时会变得更加“聪明”，它不会无限制的递归序列化自引用对象，对于同一对象的多次引用，它只会序列化一次。</p><p>在操作的时候有一个参数需要注意<code>protocol</code>这个表示代表了序列化模式(pickle协议)，<u><strong>在python2.X版本默认值为0，在python3.X本默认值为3</strong></u>。简而言之，不同的python版本对应着不同的最高协议，同时protocol值越大，代表了所用的协议版本越高，<strong>protocol值越大，dump的速度越快，并且支持的数据类型更多，保存下来的文件占用空间更小</strong></p><h4 id="Json"><a href="#Json" class="headerlink" title="Json"></a>Json</h4><p>使用<code>json.dumps</code>和<code>json.loads</code>对字典数据进行序列化和反序列化</p><p>在<code>Python</code>中包含多个<code>json</code>处理方式</p><table><thead><tr><th>依赖库</th><th>序列化耗时</th><th>反序列化耗时</th></tr></thead><tbody><tr><td>yajl</td><td>1.910</td><td>1.970</td></tr><tr><td>cjson</td><td>3.305</td><td>1.328</td></tr><tr><td>simplejson</td><td>10.279</td><td>4.658</td></tr><tr><td>stdlib json</td><td>7.013</td><td>8.579</td></tr><tr><td>ujson</td><td>2.084</td><td>1.157</td></tr></tbody></table><p>一般情况下使用<code>ujson</code>来也就是<code>import ujson as json</code>使用方法还是<code>json.dumps</code>和<code>json.loads</code></p><p>显而易见，<code>json</code>类型的数据保存了数据中元素的数据类型和数据结构等信息，比如<code>json</code>中保存多维数组数据，只需要在使用<code>vector.to_list()</code>将其赋值给字典中的元素即可使用<code>json.dumps</code>的方式保存，但是<code>json</code>方式带来的问题就是序列化的时间很慢，尤其是带序列化的数据越大，所需时间大量增加。</p><h4 id="msgpack"><a href="#msgpack" class="headerlink" title="msgpack"></a>msgpack</h4><p>和<code>json</code>类似，<a href="https://msgpack.org/"><code>msgpack</code></a>的口号就是<code>It&#39;s like JSON. but fast and small.</code>目前我已经不再使用<code>json</code>而使用<code>msgpack</code>了，序列化和反序列化时间相比<code>usjon</code>更快，也是使用<code>msgpack.loads</code>和<code>msgpack.dumps</code>的方式。</p><h4 id="struct"><a href="#struct" class="headerlink" title="struct"></a>struct</h4><p>将字符串转化为二进制字节流，这样缺点是最造成数据的结构丢失，但是好处是会最大程度减小数据的大小。在<code>pack</code>的时候，只能处理<code>float</code>的数据，也就是如果数据是多维的，那么要对数据进行铺平才能进行二进制自己留转化。</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">import</span> struct</span><br><span class="line"><span class="keyword">import</span> numpy <span class="keyword">as</span> np</span><br><span class="line"></span><br><span class="line">data = np.random.uniform(size=(<span class="number">10</span>, <span class="number">4</span>, <span class="number">2</span>))</span><br><span class="line">data_size = data.size</span><br><span class="line">data_shape = data.shape</span><br><span class="line"><span class="comment"># pack data</span></span><br><span class="line">packed_data = struct.pack(<span class="string">&#x27;=%sf&#x27;</span> % data.size, *data.flatten(<span class="string">&#x27;F&#x27;</span>))</span><br><span class="line"><span class="comment"># unpack data</span></span><br><span class="line">unpacked_data = struct.unpack(<span class="string">&#x27;=%sf&#x27;</span> % data_size, packed_data)</span><br><span class="line"><span class="comment"># reshape data to original shape</span></span><br><span class="line">original_data = np.reshape(np.asarray(unpacked_data), data_shape,order=<span class="string">&#x27;F&#x27;</span>)</span><br><span class="line"><span class="built_in">print</span>(<span class="string">&quot;original_data shape is &#123;&#125;&quot;</span>.<span class="built_in">format</span>(original_data.shape))</span><br></pre></td></tr></table></figure><h4 id="thrift"><a href="#thrift" class="headerlink" title="thrift"></a>thrift</h4><p>thrift一般用于定义数据格式，用来进行服务之间的tcp传递。一般是两种处理方式，一个是将字典转化成<code>struct</code>的形式，也就是先使用<a href="https://en.wikipedia.org/wiki/Apache_Thrift"><strong>thrift</strong></a>定义结构体，然后再将字典数据赋值到对应的结构体上</p><ol><li><p>安装<code>thrift</code>  <a href="https://thrift.apache.org/docs/install/debian">https://thrift.apache.org/docs/install/debian</a></p></li><li><p>编写<code>thrift</code>文件定义<code>struct</code>和<code>tcp</code>函数的接口</p><p>假设如下文件名为<code>service.thrift</code></p><figure class="highlight shell"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br></pre></td><td class="code"><pre><span class="line"><span class="meta prompt_">#</span><span class="language-bash">!/usr/local/bin/thrift --gen cpp --gen py:new_style -o . -r</span></span><br><span class="line">include &quot;base.thrift&quot; // thrift dependicy</span><br><span class="line">namespace py Service // namespace, the folder name you want generate by thrift</span><br><span class="line"><span class="meta prompt_"></span></span><br><span class="line"><span class="meta prompt_"># </span><span class="language-bash">define request</span></span><br><span class="line">struct ServiceRequest&#123;</span><br><span class="line">  1: binary image_binary, // image binary </span><br><span class="line">  2: i32 req_id, // request id</span><br><span class="line">  255: optional base.Base Base // base caller</span><br><span class="line">&#125;</span><br><span class="line"><span class="meta prompt_"></span></span><br><span class="line"><span class="meta prompt_"># </span><span class="language-bash">define response</span></span><br><span class="line">struct ServiceResponse &#123;</span><br><span class="line">  1: binary output, </span><br><span class="line">  255: optional base.BaseResp BaseResp // base response</span><br><span class="line">&#125;</span><br><span class="line"><span class="meta prompt_"></span></span><br><span class="line"><span class="meta prompt_"># </span><span class="language-bash">define service</span></span><br><span class="line">service Service &#123;</span><br><span class="line">    ServiceResponse forward(1: ServiceRequest request),</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>实际上按照上面的步骤，导入需要的依赖，一般是通用项，用来保存常用的请求和返回的status，msg等信息，对于上面的<code>base.thrift</code>我这里是这么定义的 ↓↓↓↓↓</p><figure class="highlight shell"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br></pre></td><td class="code"><pre><span class="line"><span class="meta prompt_">   # </span><span class="language-bash">defination</span></span><br><span class="line">   namespace py base</span><br><span class="line">   namespace go base</span><br><span class="line">   namespace java com.bytedance.thrift.base</span><br><span class="line">   </span><br><span class="line">   struct TrafficEnv &#123;</span><br><span class="line">       1: bool Open = false,</span><br><span class="line">       2: string Env = &quot;&quot;,</span><br><span class="line">   &#125;</span><br><span class="line">   </span><br><span class="line"><span class="meta prompt_">   # </span><span class="language-bash">define the base request</span></span><br><span class="line">   struct Base &#123;</span><br><span class="line">       1: string LogID = &quot;&quot;,</span><br><span class="line">       2: string Caller = &quot;&quot;,</span><br><span class="line">       3: string Addr = &quot;&quot;,</span><br><span class="line">       4: string Client = &quot;&quot;,</span><br><span class="line">       5: optional TrafficEnv TrafficEnv,</span><br><span class="line">       6: optional map&lt;string, string&gt; Extra,</span><br><span class="line">   &#125;</span><br><span class="line">   </span><br><span class="line"><span class="meta prompt_">   # </span><span class="language-bash">define the base response</span></span><br><span class="line">   struct BaseResp &#123;</span><br><span class="line">       1: string StatusMessage = &quot;&quot;,</span><br><span class="line">       2: i32 StatusCode = 0,</span><br><span class="line">       3: optional map&lt;string, string&gt; Extra,</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>定义好这两个<code>thrift</code>文件之后那么使用安装的<code>thrift</code>命令生成对应的可读取文件， 如果想要生成<code>python</code>文件，那么可以直接执行命令行命令</p><figure class="highlight shell"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line"><span class="meta prompt_"># </span><span class="language-bash">!/usr/bin/env bash</span></span><br><span class="line"></span><br><span class="line">echo &quot;Step1: thrift deploy&quot;</span><br><span class="line">thrift -r --gen py:new_style -o . service.thrift</span><br><span class="line"></span><br><span class="line">echo &quot;Step2: remove gen-py detail output to root&quot;</span><br><span class="line">mv gen-py gen_py</span><br><span class="line"></span><br></pre></td></tr></table></figure><p>如此就会生成文件夹<code>gen_py</code>在该文件夹下包含了两个目录<code>service</code> 和<code>base</code>，在这个目录下包含着对应的接口。</p></li></ol><h2 id="数据处理"><a href="#数据处理" class="headerlink" title="数据处理"></a>数据处理</h2><h3 id="去重并保持原有顺序"><a href="#去重并保持原有顺序" class="headerlink" title="去重并保持原有顺序"></a>去重并保持原有顺序</h3><p>以前一直使用set来进行去重，但是set这种方式第一是只能够去除hash类型的数据的重复，并且去重之后无法保证原来的排序，如下所示</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">x=[<span class="number">1</span>, <span class="number">5</span>, <span class="number">2</span>, <span class="number">1</span>, <span class="number">9</span>, <span class="number">1</span>, <span class="number">5</span>, <span class="number">10</span>]</span><br><span class="line">y=<span class="built_in">list</span>(<span class="built_in">set</span>(x))</span><br><span class="line"><span class="comment"># y=[1, 2, 10, 5, 9]</span></span><br></pre></td></tr></table></figure><p>在python-cookbook一书中介绍了一种方法，可以在去重的时候保持原数据的顺序</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># define function</span></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">dedupe</span>(<span class="params">items</span>): </span><br><span class="line">    seen = <span class="built_in">set</span>()</span><br><span class="line">    <span class="keyword">for</span> item <span class="keyword">in</span> items: </span><br><span class="line">        <span class="keyword">if</span> item <span class="keyword">not</span> <span class="keyword">in</span> seen: </span><br><span class="line">            <span class="keyword">yield</span> item </span><br><span class="line">            seen.add(item)</span><br><span class="line">x=[<span class="number">1</span>, <span class="number">5</span>, <span class="number">2</span>, <span class="number">1</span>, <span class="number">9</span>, <span class="number">1</span>, <span class="number">5</span>, <span class="number">10</span>]</span><br><span class="line">y=<span class="built_in">list</span>(dedupe(x))</span><br><span class="line"><span class="comment"># y=[1, 5, 2, 9, 10]</span></span><br></pre></td></tr></table></figure><h3 id="命名切片"><a href="#命名切片" class="headerlink" title="命名切片"></a>命名切片</h3><p>在<code>Python</code>中切片非常好用，但是有的时候数据边长，或者刚接触的代码很难搞清楚切片的含义，建议使用命名切片</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line">record = <span class="string">&#x27;....................100 .......513.25 ..........&#x27;</span> </span><br><span class="line">SHARES = <span class="built_in">slice</span>(<span class="number">20</span>, <span class="number">23</span>) </span><br><span class="line">PRICE = <span class="built_in">slice</span>(<span class="number">31</span>, <span class="number">37</span>) </span><br><span class="line">cost_ori = <span class="built_in">int</span>(record[<span class="number">20</span>:<span class="number">23</span>]) * <span class="built_in">float</span>(record[<span class="number">31</span>:<span class="number">37</span>])</span><br><span class="line">cost_imp = <span class="built_in">int</span>(record[SHARES]) * <span class="built_in">float</span>(record[PRICE])</span><br><span class="line"><span class="comment"># cost=51325.0</span></span><br></pre></td></tr></table></figure><p>代码中<code>cost_ori</code>和<code>cost_imp</code>是等价的，很显然使用命名切片的方式更容易理解代码含义。</p><h3 id="排列组合"><a href="#排列组合" class="headerlink" title="排列组合"></a>排列组合</h3><p>使用标准包itertools实现排列组合</p><p>排列-不考虑顺序：<code>list(itertools.combinations(src_queue,num))</code></p><p>组合-考虑顺序：<code>list(itertools.permutations(src_queue,num))</code></p><p>参数：src_queue 要处理的列表，num组合的元素数量</p><h2 id="随机数"><a href="#随机数" class="headerlink" title="随机数"></a>随机数</h2><h3 id="random"><a href="#random" class="headerlink" title="random"></a>random</h3><p>一般常用的功能如下</p><ol><li>random.choice() 随机选择一个元素</li><li>random.sample() 随机选择N个元素组成列表</li><li>random.shuffle() 打乱数据</li><li>random.seed() 随机种子，在shuffle之前使用，直生效一次</li><li>random.randint() 生成随机整数</li><li>random.random() 生成0-1之间随机浮点数，用来控制概率</li><li>random.uniform() 计算均匀分布随机数</li><li>random.gauss() 计算正态分布随机数</li></ol><p>使用的时候可以使用**random.Random(random_seed)**来创建全局变量，这样<code>seed</code>可以全局生效</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">import</span> random</span><br><span class="line"></span><br><span class="line">random_seed=<span class="number">123456</span></span><br><span class="line">rng=random.Random(random_seed)</span><br><span class="line">samples=[<span class="number">1</span>,<span class="number">2</span>,<span class="number">3</span>,<span class="number">5</span>,<span class="number">6</span>,<span class="number">7</span>]</span><br><span class="line">rng.shuffle(all_samples)</span><br><span class="line"><span class="keyword">if</span> rng.random()&lt;<span class="number">0.5</span>:</span><br><span class="line"><span class="built_in">print</span> (<span class="string">&quot;rate is little than 0.5&quot;</span>)</span><br></pre></td></tr></table></figure><h3 id="按照指定概率产生随机数"><a href="#按照指定概率产生随机数" class="headerlink" title="按照指定概率产生随机数"></a>按照指定概率产生随机数</h3><p>这个的使用场景是，已经给了一个数组，并且给了一个抽样的概率或者权重，根据给定的概率来对这个数组进行抽样，两个设计思路</p><ol><li>按照给定的概率进行抽样，这里面有两个要求<ol><li>数组的长度和概率数组的长度一致</li><li>概率数组求和为1</li></ol></li></ol><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">import</span> random</span><br><span class="line"><span class="keyword">def</span> <span class="title function_">random_pick</span>(<span class="params">some_list,probabilities</span>):</span><br><span class="line">    x = random.uniform(<span class="number">0</span>,<span class="number">1</span>)</span><br><span class="line">    cumulative_probability=<span class="number">0.0</span></span><br><span class="line">    <span class="keyword">for</span> item,item_probability <span class="keyword">in</span> <span class="built_in">zip</span>(some_list,probabilities):</span><br><span class="line">        cumulative_probability+=item_probability</span><br><span class="line">        <span class="keyword">if</span> x &lt; cumulative_probability:</span><br><span class="line">            <span class="keyword">break</span></span><br><span class="line">    <span class="keyword">return</span> item</span><br><span class="line"> </span><br></pre></td></tr></table></figure><p>思路很直白，如果第一个没有抽到，那么下一个抽到的概率按道理就应该更大一些，最差的情况会抽到数组中最后一个元素。另外，这种方法要保证概率之和&#x3D;&#x3D;0。</p><ol start="2"><li><p>按照给定的权重进行抽样，实际上这个就是把概率进行了一下改造，比如按照概率[0.1,0.3,0.6]与按权重[1,3,6]抽样是等价的。这个时候没有了概率为 1的要求</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">import</span> random</span><br><span class="line">sequence=[<span class="number">1</span>,<span class="number">2</span>,<span class="number">3</span>,<span class="number">4</span>,<span class="number">5</span>]</span><br><span class="line">relative_odds=[<span class="number">1</span>,<span class="number">1</span>,<span class="number">2</span>,<span class="number">4</span>,<span class="number">7</span>]</span><br><span class="line">table=[z <span class="keyword">for</span> x,y <span class="keyword">in</span> <span class="built_in">zip</span>(sequence,relative_odds) <span class="keyword">for</span> z <span class="keyword">in</span> [x]*y]</span><br><span class="line"><span class="keyword">for</span> i <span class="keyword">in</span> <span class="built_in">range</span>(<span class="number">10</span>):</span><br><span class="line">    <span class="built_in">print</span>(random.choice(table))</span><br></pre></td></tr></table></figure><p>这种方法有一个不太好的地方，就是table会额外占据一定空间。</p></li></ol><h2 id="数据运算加速"><a href="#数据运算加速" class="headerlink" title="数据运算加速"></a>数据运算加速</h2><h3 id="Numba加速"><a href="#Numba加速" class="headerlink" title="Numba加速"></a>Numba加速</h3><p><code>numpy</code>底层使用的<code>c++</code>实现的，实际上已经很快了，但是由于<code>Python</code>是一种动态编译的方法，拖累<code>numpy</code>速度的不是<code>numpy</code>的运算，而是<code>Python</code>的动态编译造成的，为了解决这一问题，显而易见就是把动态编译改成静态编译，<a href="http://numba.pydata.org/">numba</a>就是用来做这个的，正如官方所说<strong>Numba makes Python code fast</strong>.</p><p><strong>按照官网所述：当程序中包含大量运算，用到了大量的numpy运算或者包含大量的循环结构，这个时候可以考虑使用numba</strong></p><p>使用的时候是按照修饰器的方法</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">from</span> numba <span class="keyword">import</span> jit</span><br><span class="line"><span class="keyword">import</span> random</span><br><span class="line"></span><br><span class="line"><span class="meta">@jit(<span class="params">nopython=<span class="literal">True</span></span>)</span></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">monte_carlo_pi</span>(<span class="params">nsamples</span>):</span><br><span class="line">    acc = <span class="number">0</span></span><br><span class="line">    <span class="keyword">for</span> i <span class="keyword">in</span> <span class="built_in">range</span>(nsamples):</span><br><span class="line">        x = random.random()</span><br><span class="line">        y = random.random()</span><br><span class="line">        <span class="keyword">if</span> (x ** <span class="number">2</span> + y ** <span class="number">2</span>) &lt; <span class="number">1.0</span>:</span><br><span class="line">            acc += <span class="number">1</span></span><br><span class="line">    <span class="keyword">return</span> <span class="number">4.0</span> * acc / nsamples</span><br></pre></td></tr></table></figure><p>进行测试的结果如图所示</p><img src="/2020/01/29/Awesomes-Python/numba.png" class="" title="Numba&amp;Numpy"><p>可以看到经过<code>numba</code>加速之后，速度提升了大约30倍。</p><p>按照官方文档，最好使用<code>nopython=True</code>。<code>nopython</code>编译模式的行为是实质上编译装饰后的函数，以便其完全运行而无需<code>Python</code>解释器的参与，这样可以提升代码的运行速度。</p><h2 id="获取设备信息"><a href="#获取设备信息" class="headerlink" title="获取设备信息"></a>获取设备信息</h2><p>一般使用的是<a href="https://psutil.readthedocs.io/en/latest/">psutil</a>模块，获取当前设备的cpu，memory，disk等使用情况</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">#psutil:获取系统信息模块，可以获取CPU，内存，磁盘等的使用情况</span></span><br><span class="line"><span class="keyword">import</span> psutil</span><br><span class="line"><span class="keyword">import</span> time</span><br><span class="line"><span class="keyword">from</span> datetime <span class="keyword">import</span> datetime</span><br><span class="line"></span><br><span class="line"><span class="comment">#logfile：监测信息写入文件</span></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">MonitorSystem</span>():</span><br><span class="line">    <span class="comment">#获取cpu使用情况</span></span><br><span class="line">    cpuper = psutil.cpu_percent()</span><br><span class="line">    <span class="comment">#获取内存使用情况：系统内存大小，使用内存，有效内存，内存使用率</span></span><br><span class="line">    mem = psutil.virtual_memory()</span><br><span class="line">    <span class="comment">#内存使用率</span></span><br><span class="line">    memper = mem.percent</span><br><span class="line">    <span class="comment">#获取当前时间</span></span><br><span class="line">    now = datetime.now()</span><br><span class="line">    ts = now.strftime(<span class="string">&#x27;%Y-%m-%d %H:%M:%S&#x27;</span>)</span><br><span class="line">    line = <span class="string">f&#x27;<span class="subst">&#123;ts&#125;</span> cpu:<span class="subst">&#123;cpuper&#125;</span>%, mem:<span class="subst">&#123;memper&#125;</span>%&#x27;</span></span><br><span class="line">    <span class="built_in">print</span>(line)</span><br><span class="line"></span><br></pre></td></tr></table></figure><h2 id="时间-日期-定时任务"><a href="#时间-日期-定时任务" class="headerlink" title="时间&#x2F;日期&#x2F;定时任务"></a>时间&#x2F;日期&#x2F;定时任务</h2><h3 id="获取当前时间"><a href="#获取当前时间" class="headerlink" title="获取当前时间"></a>获取当前时间</h3><p>下面的程序获取当前时刻并打印输出为<code>string</code>格式</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">import</span> time</span><br><span class="line"><span class="keyword">def</span> <span class="title function_">GetTime</span>():</span><br><span class="line">    time_now=time.strftime(<span class="string">&#x27;%Y-%m-%d-%H-%M-%S&#x27;</span>,time.localtime(time.time()))</span><br><span class="line">    <span class="keyword">return</span> time_now</span><br></pre></td></tr></table></figure><h3 id="获取当前时间戳"><a href="#获取当前时间戳" class="headerlink" title="获取当前时间戳"></a>获取当前时间戳</h3><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">time.time()</span><br></pre></td></tr></table></figure><h3 id="定时任务"><a href="#定时任务" class="headerlink" title="定时任务"></a>定时任务</h3><h4 id="sleep方式"><a href="#sleep方式" class="headerlink" title="sleep方式"></a>sleep方式</h4><p>最简单的方法time.sleep()但是只能控制任务的间隔无法控制任务具体启动的时刻</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">#psutil:获取系统信息模块，可以获取CPU，内存，磁盘等的使用情况</span></span><br><span class="line"><span class="keyword">import</span> psutil</span><br><span class="line"><span class="keyword">import</span> time</span><br><span class="line"><span class="keyword">import</span> datetime</span><br><span class="line"><span class="comment">#logfile：监测信息写入文件</span></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">MonitorSystem</span>(<span class="params">logfile = <span class="literal">None</span></span>):</span><br><span class="line">    <span class="comment">#获取cpu使用情况</span></span><br><span class="line">    cpuper = psutil.cpu_percent()</span><br><span class="line">    <span class="comment">#获取内存使用情况：系统内存大小，使用内存，有效内存，内存使用率</span></span><br><span class="line">    mem = psutil.virtual_memory()</span><br><span class="line">    <span class="comment">#内存使用率</span></span><br><span class="line">    memper = mem.percent</span><br><span class="line">    <span class="comment">#获取当前时间</span></span><br><span class="line">    now = datetime.datetime.now()</span><br><span class="line">    ts = now.strftime(<span class="string">&#x27;%Y-%m-%d %H:%M:%S&#x27;</span>)</span><br><span class="line">    line = <span class="string">f&#x27;<span class="subst">&#123;ts&#125;</span> cpu:<span class="subst">&#123;cpuper&#125;</span>%, mem:<span class="subst">&#123;memper&#125;</span>%&#x27;</span></span><br><span class="line">    <span class="built_in">print</span>(line)</span><br><span class="line">    <span class="keyword">if</span> logfile:</span><br><span class="line">        logfile.write(line)</span><br><span class="line">        </span><br><span class="line"><span class="keyword">def</span> <span class="title function_">loopMonitor</span>():</span><br><span class="line">    <span class="keyword">while</span> <span class="literal">True</span>:</span><br><span class="line">        MonitorSystem()</span><br><span class="line">        <span class="comment">#2s检查一次</span></span><br><span class="line">        time.sleep(<span class="number">2</span>)</span><br><span class="line">loopMonitor()</span><br></pre></td></tr></table></figure><h4 id="Timer模块"><a href="#Timer模块" class="headerlink" title="Timer模块"></a>Timer模块</h4><p>在使用多线程编程，为了线程安全，优先使用该方法。</p><p>定时器只能执行一次，如果需要重复执行，需要重新添加任务；在执行的时候携程递归的方式可以保证函数是重复执行的。</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">from</span> threading <span class="keyword">import</span> Timer</span><br><span class="line"><span class="keyword">import</span> psutil</span><br><span class="line"><span class="keyword">import</span> time</span><br><span class="line"><span class="keyword">from</span> datetime <span class="keyword">import</span> datetime</span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">MonitorSystem</span>(<span class="params">logfile = <span class="literal">None</span></span>):</span><br><span class="line">    cpuper = psutil.cpu_percent()</span><br><span class="line">    mem = psutil.virtual_memory()</span><br><span class="line">    memper = mem.percent</span><br><span class="line">    now = datetime.now()</span><br><span class="line">    ts = now.strftime(<span class="string">&#x27;%Y-%m-%d %H:%M:%S&#x27;</span>)</span><br><span class="line">    line = <span class="string">f&#x27;<span class="subst">&#123;ts&#125;</span> cpu:<span class="subst">&#123;cpuper&#125;</span>%, mem:<span class="subst">&#123;memper&#125;</span>%&#x27;</span></span><br><span class="line">    <span class="built_in">print</span>(line)</span><br><span class="line">    <span class="keyword">if</span> logfile:</span><br><span class="line">        logfile.write(line)</span><br><span class="line">    <span class="comment">#启动定时器任务，每三秒执行一次</span></span><br><span class="line">    Timer(<span class="number">3</span>, MonitorSystem).start()</span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">MonitorNetWork</span>(<span class="params">logfile = <span class="literal">None</span></span>):</span><br><span class="line">    netinfo = psutil.net_io_counters()</span><br><span class="line">    now = datetime.datetime.now()</span><br><span class="line">    ts = now.strftime(<span class="string">&#x27;%Y-%m-%d %H:%M:%S&#x27;</span>)</span><br><span class="line">    line = <span class="string">f&#x27;<span class="subst">&#123;ts&#125;</span> bytessent=<span class="subst">&#123;netinfo.bytes_sent&#125;</span>, bytesrecv=<span class="subst">&#123;netinfo.bytes_recv&#125;</span>&#x27;</span></span><br><span class="line">    <span class="built_in">print</span>(line)</span><br><span class="line">    <span class="keyword">if</span> logfile:</span><br><span class="line">        logfile.write(line)</span><br><span class="line">    <span class="comment">#启动定时器任务，每秒执行一次</span></span><br><span class="line">    Timer(<span class="number">1</span>, MonitorNetWork).start()</span><br><span class="line">    </span><br><span class="line">MonitorSystem()</span><br><span class="line">MonitorNetWork()</span><br></pre></td></tr></table></figure><ol start="3"><li>任务框架APScheduler</li></ol><h2 id="多进程"><a href="#多进程" class="headerlink" title="多进程"></a>多进程</h2><p>所谓多进程可以理解成，独立运行多个程序，可以看做是一种并发环境；与之对应的是多线程，多线程是在一个进程中的，每个进程处理一部分的数据或操作。</p><p>在机器学习和深度学习中，当模型训练好之后，一般使用多进程进行<strong>Inference</strong>操作，但是有一点需要注意，要在每个进程中单独Load模型。</p><p>一般的操作方法是</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># !/usr/bin/env python</span></span><br><span class="line"><span class="comment"># -*- coding:utf-8 -*-</span></span><br><span class="line"></span><br><span class="line"><span class="keyword">from</span> __future__ <span class="keyword">import</span> division, print_function</span><br><span class="line"></span><br><span class="line"><span class="keyword">import</span> os</span><br><span class="line"><span class="keyword">from</span> multiprocessing <span class="keyword">import</span> Process</span><br><span class="line"></span><br><span class="line"><span class="comment"># handler function to exit the process</span></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">exit_signal_handler</span>(<span class="params">sig=<span class="literal">None</span>, frame=<span class="literal">None</span></span>):</span><br><span class="line">    t1 = time.time()</span><br><span class="line">    <span class="keyword">while</span>(multiprocessing.active_children()):</span><br><span class="line">        <span class="keyword">for</span> p <span class="keyword">in</span> multiprocessing.active_children():</span><br><span class="line">            t2 = time.time()</span><br><span class="line">            <span class="keyword">if</span> (t2 - t1 &gt; <span class="number">5</span>):</span><br><span class="line">                os.kill(p.pid, signal.SIGKILL)</span><br><span class="line">            <span class="keyword">else</span>:</span><br><span class="line">                p.terminate()</span><br><span class="line">        time.sleep(<span class="number">1</span>)</span><br><span class="line">    os._exit(<span class="number">0</span>)</span><br><span class="line"></span><br><span class="line"><span class="comment"># receive keyboard information</span></span><br><span class="line">signal.signal(signal.SIGINT, exit_signal_handler)</span><br><span class="line">signal.signal(signal.SIGTERM, exit_signal_handler)</span><br><span class="line">signal.signal(signal.SIGHUP, exit_signal_handler)</span><br><span class="line"></span><br><span class="line">processes=[]</span><br><span class="line">process_num=<span class="number">10</span></span><br><span class="line"><span class="keyword">for</span> process_idx <span class="keyword">in</span> <span class="built_in">range</span>(process_num):</span><br><span class="line">  <span class="comment"># if there only one parmeter, the args should add &quot;,&quot; </span></span><br><span class="line">  consumer = Process(target=consumer, args=(process_idx,))</span><br><span class="line">    processes.append(consumer)</span><br><span class="line"><span class="keyword">try</span>:</span><br><span class="line">  <span class="comment"># start the process and protect the process</span></span><br><span class="line">    <span class="keyword">for</span> p <span class="keyword">in</span> processes:</span><br><span class="line">        p.daemon = <span class="literal">True</span></span><br><span class="line">        p.start()</span><br><span class="line">    <span class="keyword">for</span> p <span class="keyword">in</span> processes:</span><br><span class="line">        p.join()</span><br><span class="line"><span class="comment"># recevie the keyboard input to terminate the process</span></span><br><span class="line"><span class="keyword">except</span> KeyboardInterrupt:</span><br><span class="line">    self.logger.info(<span class="string">&#x27;Parent received ctrl-c&#x27;</span>)</span><br><span class="line">    <span class="keyword">for</span> p <span class="keyword">in</span> processes:</span><br><span class="line">        p.terminate()</span><br><span class="line">        p.join()</span><br></pre></td></tr></table></figure><p>需要注意，在process的<code>args</code>参数，要是一个可迭代的对象，可以是列表，元组等</p><h3 id="多进程数据同步"><a href="#多进程数据同步" class="headerlink" title="多进程数据同步"></a>多进程数据同步</h3><p>在多进程中，如果需要进行数据同步，一般使用队列来进行进程数据管理，比如一个进程写入数据，其余进程读取数据，<strong>那么这里的进程要使用multiprocessing下面的Queue，不能使用默认的Queue。</strong></p><h2 id="Server-Client"><a href="#Server-Client" class="headerlink" title="Server&amp;Client"></a>Server&amp;Client</h2><p><a href="https://zeromq.org/languages/python/">https://zeromq.org/languages/python/</a></p><h2 id="logging"><a href="#logging" class="headerlink" title="logging"></a>logging</h2><h3 id="简单版"><a href="#简单版" class="headerlink" title="简单版"></a>简单版</h3><p>只使用log代替print显示，并不写入文件</p><ol><li>全局设置一个logger，不写入文件</li></ol><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">import</span> logging</span><br><span class="line">logger_stdout = logging.getLogger(<span class="string">&quot;CHECKPOINT&quot;</span>)</span><br><span class="line">logger_stdout.propagate = <span class="literal">False</span></span><br><span class="line"><span class="keyword">if</span> <span class="keyword">not</span> logger_stdout.handlers:</span><br><span class="line">    formatter = logging.Formatter(</span><br><span class="line">        <span class="string">&#x27;%(asctime)s - %(name)s - [%(process)d - %(levelname)s] :: [%(module)s|%(lineno)s] ==&gt;&gt; %(message)s&#x27;</span>)</span><br><span class="line">    streamhandler = logging.StreamHandler(stream=sys.stdout)</span><br><span class="line">    streamhandler.setFormatter(formatter)</span><br><span class="line">    streamhandler.setLevel(LEVEL)</span><br><span class="line">    logger_stdout.addHandler(streamhandler)</span><br></pre></td></tr></table></figure><ol start="2"><li>脚本中临时使用，在文件的头部进行如下设置</li></ol><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">import</span> logging</span><br><span class="line"></span><br><span class="line">logging.basicConfig(<span class="built_in">format</span>=<span class="string">&#x27;%(asctime)s - %(name)s - [%(levelname)s] - %(message)s&#x27;</span>, stream=sys.stderr)</span><br><span class="line">logger = logging.getLogger()</span><br><span class="line">logger.setLevel(logging.INFO)</span><br></pre></td></tr></table></figure><h3 id="进阶版"><a href="#进阶版" class="headerlink" title="进阶版"></a>进阶版</h3><p>日志打印模块写入文件，把一个轮子记录在此，直接使用</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">import</span> logging</span><br><span class="line"><span class="keyword">import</span> os</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">get_logger</span>(<span class="params">_loggerDir, log_filename, logger_name</span>):</span><br><span class="line">    <span class="string">&quot;&quot;&quot;[summary]</span></span><br><span class="line"><span class="string">    </span></span><br><span class="line"><span class="string">    Arguments:</span></span><br><span class="line"><span class="string">        _loggerDir &#123;[type]&#125; -- [directory of the Logger]</span></span><br><span class="line"><span class="string">        log_filename &#123;[type]&#125; -- [Logger name ]</span></span><br><span class="line"><span class="string">        logger_name &#123;[type]&#125; -- [Logger file name]</span></span><br><span class="line"><span class="string">    </span></span><br><span class="line"><span class="string">    Returns:</span></span><br><span class="line"><span class="string">        [type] -- [description]</span></span><br><span class="line"><span class="string">    &quot;&quot;&quot;</span></span><br><span class="line">    _LogFile = os.path.join(_loggerDir, log_filename)</span><br><span class="line"></span><br><span class="line">    logger = logging.getLogger(logger_name)</span><br><span class="line">    logger.setLevel(logging.INFO)</span><br><span class="line">    <span class="comment"># default_value is True, it will send mesaage to the root, which will print twice for one mesaage</span></span><br><span class="line">    logger.propagate=<span class="literal">False</span></span><br><span class="line">    <span class="comment"># ccreate file handler which logs even debug messages</span></span><br><span class="line">    fh = logging.FileHandler(_LogFile)</span><br><span class="line">    fh.setLevel(logging.INFO)</span><br><span class="line">    <span class="comment"># create console handler with a higher log level</span></span><br><span class="line">    console = logging.StreamHandler()</span><br><span class="line">    console.setLevel(logging.INFO)</span><br><span class="line">    <span class="comment"># create formatter and add it to the handlers</span></span><br><span class="line">    _LogFormat = logging.Formatter(<span class="string">&quot;%(asctime)2s -%(name)-12s:  %(levelname)-10s - %(message)s&quot;</span>)</span><br><span class="line"></span><br><span class="line">    fh.setFormatter(_LogFormat)</span><br><span class="line">    console.setFormatter(_LogFormat)</span><br><span class="line">    <span class="comment"># add the handlers to logger</span></span><br><span class="line">    logger.addHandler(fh)</span><br><span class="line">    logger.addHandler(console)</span><br><span class="line">    <span class="keyword">return</span> logger</span><br></pre></td></tr></table></figure><h2 id="Opencv-PIL"><a href="#Opencv-PIL" class="headerlink" title="Opencv&amp;PIL"></a>Opencv&amp;PIL</h2><p><code>Opencv</code>默认读取的图片格式为<strong>BGR</strong>通道顺序，写入的时候默认也是<strong>BGR</strong>的格式，，如果使用OpenCV读写，那么不需要进行通道转换，但是如果使用OpenCV读用PIL 写，那么在读取的时候要进行图片通道转换。</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">import</span> cv2</span><br><span class="line"><span class="keyword">from</span> PIL <span class="keyword">import</span> Image</span><br><span class="line"></span><br><span class="line"><span class="comment"># opencv read and write</span></span><br><span class="line">image_file=<span class="string">&#x27;&#x27;</span></span><br><span class="line">img_data=cv2.imread(image_file)</span><br><span class="line">img_crop=img_data[y1:y2,x1:x2]</span><br><span class="line">cv2.imwrite(crop_file_dir,img_crop)</span><br><span class="line"></span><br><span class="line"><span class="comment"># oepncv read, PIL write</span></span><br><span class="line">img_data=cv2.imread(image_file)</span><br><span class="line">img_data=img_data[:,:,::-<span class="number">1</span>]</span><br><span class="line">img=Image.fromarray(img_data)</span><br><span class="line">img.save(<span class="string">&#x27;xxxx&#x27;</span>)</span><br></pre></td></tr></table></figure><h2 id="文本过滤"><a href="#文本过滤" class="headerlink" title="文本过滤"></a>文本过滤</h2><h3 id="DFA过滤敏感词算法"><a href="#DFA过滤敏感词算法" class="headerlink" title="DFA过滤敏感词算法"></a>DFA过滤敏感词算法</h3><p>核心思想：创建敏感词树</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br><span class="line">51</span><br><span class="line">52</span><br><span class="line">53</span><br><span class="line">54</span><br><span class="line">55</span><br><span class="line">56</span><br><span class="line">57</span><br><span class="line">58</span><br><span class="line">59</span><br><span class="line">60</span><br><span class="line">61</span><br><span class="line">62</span><br><span class="line">63</span><br><span class="line">64</span><br><span class="line">65</span><br><span class="line">66</span><br><span class="line">67</span><br><span class="line">68</span><br><span class="line">69</span><br><span class="line">70</span><br><span class="line">71</span><br><span class="line">72</span><br><span class="line">73</span><br><span class="line">74</span><br><span class="line">75</span><br><span class="line">76</span><br><span class="line">77</span><br><span class="line">78</span><br><span class="line">79</span><br><span class="line">80</span><br><span class="line">81</span><br><span class="line">82</span><br><span class="line">83</span><br><span class="line">84</span><br><span class="line">85</span><br><span class="line">86</span><br><span class="line">87</span><br><span class="line">88</span><br><span class="line">89</span><br><span class="line">90</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">from</span> __future__ <span class="keyword">import</span> print_function</span><br><span class="line"><span class="keyword">import</span> sys</span><br><span class="line"></span><br><span class="line">reload(sys)</span><br><span class="line">sys.setdefaultencoding(<span class="string">&#x27;utf-8&#x27;</span>)</span><br><span class="line"></span><br><span class="line"><span class="comment"># DFA算法</span></span><br><span class="line"><span class="keyword">class</span> <span class="title class_">DFAFilter</span>(<span class="title class_ inherited__">object</span>):</span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">__init__</span>(<span class="params">self</span>):</span><br><span class="line">        self.keyword_chains = &#123;&#125;</span><br><span class="line">        self.delimit = <span class="string">&#x27;\x00&#x27;</span></span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">add</span>(<span class="params">self, keyword</span>):</span><br><span class="line">        keyword = keyword.lower()</span><br><span class="line">        chars = keyword.strip()</span><br><span class="line">        <span class="keyword">if</span> <span class="keyword">not</span> chars:</span><br><span class="line">            <span class="keyword">return</span></span><br><span class="line">        level = self.keyword_chains</span><br><span class="line">        <span class="keyword">for</span> i <span class="keyword">in</span> <span class="built_in">range</span>(<span class="built_in">len</span>(chars)):</span><br><span class="line">            <span class="keyword">if</span> chars[i] <span class="keyword">in</span> level:</span><br><span class="line">                level = level[chars[i]]</span><br><span class="line">            <span class="keyword">else</span>:</span><br><span class="line">                <span class="keyword">if</span> <span class="keyword">not</span> <span class="built_in">isinstance</span>(level, <span class="built_in">dict</span>):</span><br><span class="line">                    <span class="keyword">break</span></span><br><span class="line">                <span class="keyword">for</span> j <span class="keyword">in</span> <span class="built_in">range</span>(i, <span class="built_in">len</span>(chars)):</span><br><span class="line">                    level[chars[j]] = &#123;&#125;</span><br><span class="line">                    last_level, last_char = level, chars[j]</span><br><span class="line">                    level = level[chars[j]]</span><br><span class="line">                last_level[last_char] = &#123;self.delimit: <span class="number">0</span>&#125;</span><br><span class="line">                <span class="keyword">break</span></span><br><span class="line">        <span class="keyword">if</span> i == <span class="built_in">len</span>(chars) - <span class="number">1</span>:</span><br><span class="line">            level[self.delimit] = <span class="number">0</span></span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">parse</span>(<span class="params">self, path</span>):</span><br><span class="line">        contens = <span class="built_in">open</span>(path, <span class="string">&quot;r&quot;</span>).readlines()</span><br><span class="line">        <span class="keyword">for</span> line <span class="keyword">in</span> contens:</span><br><span class="line">            char = line.strip()</span><br><span class="line">            <span class="keyword">if</span> line != <span class="string">&quot;&quot;</span>:</span><br><span class="line">                self.add(char)</span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">search</span>(<span class="params">self, message, repl=<span class="string">&quot;*&quot;</span></span>):</span><br><span class="line">        message = message.lower()</span><br><span class="line">        ret = []</span><br><span class="line">        start = <span class="number">0</span></span><br><span class="line">        <span class="keyword">while</span> start &lt; <span class="built_in">len</span>(message):</span><br><span class="line">            level = self.keyword_chains</span><br><span class="line">            step_ins = <span class="number">0</span></span><br><span class="line">            <span class="keyword">for</span> char <span class="keyword">in</span> message[start:]:</span><br><span class="line">                <span class="keyword">if</span> char <span class="keyword">in</span> level:</span><br><span class="line">                    step_ins += <span class="number">1</span></span><br><span class="line">                    <span class="keyword">if</span> self.delimit <span class="keyword">not</span> <span class="keyword">in</span> level[char]:</span><br><span class="line">                        level = level[char]</span><br><span class="line">                    <span class="keyword">else</span>:</span><br><span class="line">                        ret.append(repl * step_ins)</span><br><span class="line">                        start += step_ins - <span class="number">1</span></span><br><span class="line">                        <span class="keyword">break</span></span><br><span class="line">                <span class="keyword">else</span>:</span><br><span class="line">                    ret.append(message[start])</span><br><span class="line">                    <span class="keyword">break</span></span><br><span class="line">            <span class="keyword">else</span>:</span><br><span class="line">                ret.append(message[start])</span><br><span class="line">            start += <span class="number">1</span></span><br><span class="line"></span><br><span class="line">        <span class="keyword">return</span> <span class="string">&#x27;&#x27;</span>.join(ret)</span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">findall</span>(<span class="params">self, message, repl=<span class="string">&quot;*&quot;</span></span>):</span><br><span class="line">        message = message.lower()</span><br><span class="line">        start = <span class="number">0</span></span><br><span class="line">        <span class="keyword">while</span> start &lt; <span class="built_in">len</span>(message):</span><br><span class="line">            level = self.keyword_chains</span><br><span class="line">            step_ins = <span class="number">0</span></span><br><span class="line">            <span class="keyword">for</span> char <span class="keyword">in</span> message[start:]:</span><br><span class="line">                <span class="keyword">if</span> char <span class="keyword">in</span> level:</span><br><span class="line">                    step_ins += <span class="number">1</span></span><br><span class="line">                    <span class="keyword">if</span> self.delimit <span class="keyword">not</span> <span class="keyword">in</span> level[char]:</span><br><span class="line">                        level = level[char]</span><br><span class="line">                    <span class="keyword">else</span>:</span><br><span class="line">                        <span class="keyword">return</span> <span class="literal">True</span></span><br><span class="line">            start += <span class="number">1</span></span><br><span class="line">        <span class="keyword">return</span> <span class="literal">False</span></span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="comment"># 敏感词词表</span></span><br><span class="line">blacklist = <span class="string">&quot;./blacklist.txt&quot;</span></span><br><span class="line">dfa = DFAFilter()</span><br><span class="line">dfa.parse(blacklist)</span><br><span class="line"></span><br><span class="line">text=<span class="string">&quot;新疆骚乱 苹果 新品发布会 AV女优&quot;</span></span><br><span class="line"><span class="built_in">print</span>(dfa.findall(text),file=sys.stderr)</span><br><span class="line"></span><br></pre></td></tr></table></figure><h2 id="AC自动机过滤敏感"><a href="#AC自动机过滤敏感" class="headerlink" title="AC自动机过滤敏感"></a>AC自动机过滤敏感</h2><p>给出n个单词，再给出一段包含m个字符的文章，让你找出有多少个单词在文章里出现过。</p><p>AC自动机就是字典树+kmp算法+失配指针</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br><span class="line">51</span><br><span class="line">52</span><br><span class="line">53</span><br><span class="line">54</span><br><span class="line">55</span><br><span class="line">56</span><br><span class="line">57</span><br><span class="line">58</span><br><span class="line">59</span><br><span class="line">60</span><br><span class="line">61</span><br><span class="line">62</span><br><span class="line">63</span><br><span class="line">64</span><br><span class="line">65</span><br><span class="line">66</span><br><span class="line">67</span><br><span class="line">68</span><br><span class="line">69</span><br><span class="line">70</span><br><span class="line">71</span><br><span class="line">72</span><br><span class="line">73</span><br><span class="line">74</span><br><span class="line">75</span><br><span class="line">76</span><br><span class="line">77</span><br><span class="line">78</span><br><span class="line">79</span><br><span class="line">80</span><br><span class="line">81</span><br><span class="line">82</span><br><span class="line">83</span><br><span class="line">84</span><br><span class="line">85</span><br><span class="line">86</span><br><span class="line">87</span><br><span class="line">88</span><br><span class="line">89</span><br><span class="line">90</span><br><span class="line">91</span><br><span class="line">92</span><br><span class="line">93</span><br><span class="line">94</span><br><span class="line">95</span><br><span class="line">96</span><br><span class="line">97</span><br><span class="line">98</span><br><span class="line">99</span><br><span class="line">100</span><br><span class="line">101</span><br><span class="line">102</span><br><span class="line">103</span><br><span class="line">104</span><br><span class="line">105</span><br><span class="line">106</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># -*- coding:utf-8 -*-</span></span><br><span class="line"></span><br><span class="line"><span class="keyword">import</span> time</span><br><span class="line">time1=time.time()</span><br><span class="line"></span><br><span class="line"><span class="comment"># AC自动机算法</span></span><br><span class="line"><span class="keyword">class</span> <span class="title class_">node</span>(<span class="title class_ inherited__">object</span>):</span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">__init__</span>(<span class="params">self</span>):</span><br><span class="line">        self.<span class="built_in">next</span> = &#123;&#125;</span><br><span class="line">        self.fail = <span class="literal">None</span></span><br><span class="line">        self.isWord = <span class="literal">False</span></span><br><span class="line">        self.word = <span class="string">&quot;&quot;</span></span><br><span class="line"></span><br><span class="line"><span class="keyword">class</span> <span class="title class_">ac_automation</span>(<span class="title class_ inherited__">object</span>):</span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">__init__</span>(<span class="params">self</span>):</span><br><span class="line">        self.root = node()</span><br><span class="line"></span><br><span class="line">    <span class="comment"># 添加敏感词函数</span></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">addword</span>(<span class="params">self, word</span>):</span><br><span class="line">        temp_root = self.root</span><br><span class="line">        <span class="keyword">for</span> char <span class="keyword">in</span> word:</span><br><span class="line">            <span class="keyword">if</span> char <span class="keyword">not</span> <span class="keyword">in</span> temp_root.<span class="built_in">next</span>:</span><br><span class="line">                temp_root.<span class="built_in">next</span>[char] = node()</span><br><span class="line">            temp_root = temp_root.<span class="built_in">next</span>[char]</span><br><span class="line">        temp_root.isWord = <span class="literal">True</span></span><br><span class="line">        temp_root.word = word</span><br><span class="line"></span><br><span class="line">    <span class="comment"># 失败指针函数</span></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">make_fail</span>(<span class="params">self</span>):</span><br><span class="line">        temp_que = []</span><br><span class="line">        temp_que.append(self.root)</span><br><span class="line">        <span class="keyword">while</span> <span class="built_in">len</span>(temp_que) != <span class="number">0</span>:</span><br><span class="line">            temp = temp_que.pop(<span class="number">0</span>)</span><br><span class="line">            p = <span class="literal">None</span></span><br><span class="line">            <span class="keyword">for</span> key,value <span class="keyword">in</span> temp.<span class="built_in">next</span>.item():</span><br><span class="line">                <span class="keyword">if</span> temp == self.root:</span><br><span class="line">                    temp.<span class="built_in">next</span>[key].fail = self.root</span><br><span class="line">                <span class="keyword">else</span>:</span><br><span class="line">                    p = temp.fail</span><br><span class="line">                    <span class="keyword">while</span> p <span class="keyword">is</span> <span class="keyword">not</span> <span class="literal">None</span>:</span><br><span class="line">                        <span class="keyword">if</span> key <span class="keyword">in</span> p.<span class="built_in">next</span>:</span><br><span class="line">                            temp.<span class="built_in">next</span>[key].fail = p.fail</span><br><span class="line">                            <span class="keyword">break</span></span><br><span class="line">                        p = p.fail</span><br><span class="line">                    <span class="keyword">if</span> p <span class="keyword">is</span> <span class="literal">None</span>:</span><br><span class="line">                        temp.<span class="built_in">next</span>[key].fail = self.root</span><br><span class="line">                temp_que.append(temp.<span class="built_in">next</span>[key])</span><br><span class="line"></span><br><span class="line">    <span class="comment"># 查找敏感词函数</span></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">search</span>(<span class="params">self, content</span>):</span><br><span class="line">        p = self.root</span><br><span class="line">        result = []</span><br><span class="line">        currentposition = <span class="number">0</span></span><br><span class="line"></span><br><span class="line">        <span class="keyword">while</span> currentposition &lt; <span class="built_in">len</span>(content):</span><br><span class="line">            word = content[currentposition]</span><br><span class="line">            <span class="keyword">while</span> word <span class="keyword">in</span> p.<span class="built_in">next</span> == <span class="literal">False</span> <span class="keyword">and</span> p != self.root:</span><br><span class="line">                p = p.fail</span><br><span class="line"></span><br><span class="line">            <span class="keyword">if</span> word <span class="keyword">in</span> p.<span class="built_in">next</span>:</span><br><span class="line">                p = p.<span class="built_in">next</span>[word]</span><br><span class="line">            <span class="keyword">else</span>:</span><br><span class="line">                p = self.root</span><br><span class="line"></span><br><span class="line">            <span class="keyword">if</span> p.isWord:</span><br><span class="line">                result.append(p.word)</span><br><span class="line">                p = self.root</span><br><span class="line">            currentposition += <span class="number">1</span></span><br><span class="line">        <span class="keyword">return</span> result</span><br><span class="line"></span><br><span class="line">    <span class="comment"># 加载敏感词库函数</span></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">parse</span>(<span class="params">self, path</span>):</span><br><span class="line">      contenst=<span class="built_in">open</span>(path,<span class="string">&quot;r&quot;</span>).realines()</span><br><span class="line">      </span><br><span class="line">        <span class="keyword">with</span> <span class="built_in">open</span>(path,encoding=<span class="string">&#x27;utf-8&#x27;</span>) <span class="keyword">as</span> f:</span><br><span class="line">          </span><br><span class="line">            <span class="keyword">for</span> keyword <span class="keyword">in</span> f:</span><br><span class="line">                self.addword(<span class="built_in">str</span>(keyword).strip())</span><br><span class="line"></span><br><span class="line">    <span class="comment"># 敏感词替换函数</span></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">words_replace</span>(<span class="params">self, text</span>):</span><br><span class="line">        <span class="string">&quot;&quot;&quot;</span></span><br><span class="line"><span class="string">        :param ah: AC自动机</span></span><br><span class="line"><span class="string">        :param text: 文本</span></span><br><span class="line"><span class="string">        :return: 过滤敏感词之后的文本</span></span><br><span class="line"><span class="string">        &quot;&quot;&quot;</span></span><br><span class="line">        result = <span class="built_in">list</span>(<span class="built_in">set</span>(self.search(text)))</span><br><span class="line">        <span class="keyword">for</span> x <span class="keyword">in</span> result:</span><br><span class="line">            m = text.replace(x, <span class="string">&#x27;*&#x27;</span> * <span class="built_in">len</span>(x))</span><br><span class="line">            text = m</span><br><span class="line">        <span class="keyword">return</span> text</span><br><span class="line"></span><br><span class="line"><span class="keyword">if</span> __name__ == <span class="string">&#x27;__main__&#x27;</span>:</span><br><span class="line"></span><br><span class="line">    ah = ac_automation()</span><br><span class="line">    path=<span class="string">&#x27;blacklist.txt&#x27;</span></span><br><span class="line">    ah.parse(path)</span><br><span class="line">    text1=<span class="string">&quot;新疆骚乱苹果新品发布会雞八&quot;</span></span><br><span class="line">    text2=ah.words_replace(text1)</span><br><span class="line"></span><br><span class="line">    <span class="built_in">print</span>(text1)</span><br><span class="line">    <span class="built_in">print</span>(text2)</span><br><span class="line"></span><br><span class="line">    time2 = time.time()</span><br><span class="line">    <span class="built_in">print</span>(<span class="string">&#x27;总共耗时：&#x27;</span> + <span class="built_in">str</span>(time2 - time1) + <span class="string">&#x27;s&#x27;</span>)</span><br></pre></td></tr></table></figure><h2 id="出错重试"><a href="#出错重试" class="headerlink" title="出错重试"></a>出错重试</h2><h3 id="Tenacity"><a href="#Tenacity" class="headerlink" title="Tenacity"></a>Tenacity</h3><p>在爬虫或者下载的时候很容易出现错误，报错的时候进行自动重试</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">from</span> tenacity <span class="keyword">import</span> retry,stop_after_delay,stop_after_attempt,wait_fixed</span><br><span class="line"></span><br><span class="line"><span class="comment"># 重试5次，每次间隔10秒，重试前等待2秒</span></span><br><span class="line"><span class="meta">@retry(<span class="params">stop=(<span class="params">stop_after_delay(<span class="params"><span class="number">10</span></span>) | stop_after_attempt(<span class="params"><span class="number">5</span></span>)</span>), wait=wait_fixed(<span class="params"><span class="number">2</span></span>)</span>)</span></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">stop_after_10_s_or_5_retries</span>():</span><br><span class="line">    <span class="built_in">print</span>(<span class="string">&quot;Stopping after 10 seconds or 5 retries&quot;</span>)</span><br><span class="line">    <span class="string">&quot;&quot;&quot;other progress&quot;&quot;&quot;</span></span><br><span class="line">    <span class="keyword">raise</span> Exception</span><br></pre></td></tr></table></figure><h2 id="pytorch"><a href="#pytorch" class="headerlink" title="pytorch"></a>pytorch</h2><h3 id="Install"><a href="#Install" class="headerlink" title="Install"></a>Install</h3><p>随着新版本的退出，安装方式的指令存在变化，比如下图这样，在最新版式1.5.0的时候，使用<code>pip install torch torchvision</code>会安装pytorch1.5.0+cuda10.2，但是当最新版是1.4.0的时候这个命令就会安装pytorch1.4.0+cuda10.1，</p><img src="/2020/01/29/Awesomes-Python/pytorch_150.png" class=""><p>推荐使用的安装方式是从<a href="https://download.pytorch.org/whl/torch_stable.html">https://download.pytorch.org/whl/torch_stable.html</a> 或者 <a href="https://mirrors.tuna.tsinghua.edu.cn/anaconda/cloud/pytorch/linux-64%E8%BF%99%E9%87%8C%E6%89%BE%E4%BD%A0%E6%83%B3%E8%A6%81%E7%9A%84%E7%89%88%E6%9C%AC%EF%BC%8C%E7%84%B6%E5%90%8E%E4%BD%BF%E7%94%A8">https://mirrors.tuna.tsinghua.edu.cn/anaconda/cloud/pytorch/linux-64这里找你想要的版本，然后使用</a></p><p><code>pip install https://download.pytorch.org/whl/cu101/torch-1.4.0-cp38-cp38-linux_x86_64.whl</code>的方式安装你想要的历史版本。<code>cu101/torch-1.4.0-cp38-cp38-linux_x86_64.whl</code>这个的意思是cuda10.1+pytorch1.4.0+python3.8+linux的意思</p><h2 id="训练加速"><a href="#训练加速" class="headerlink" title="训练加速"></a>训练加速</h2><p><a href="https://zhuanlan.zhihu.com/p/80695364">https://zhuanlan.zhihu.com/p/80695364</a></p><h2 id="HDFS"><a href="#HDFS" class="headerlink" title="HDFS"></a>HDFS</h2><h3 id="hdfs-io"><a href="#hdfs-io" class="headerlink" title="hdfs_io"></a>hdfs_io</h3><p>主要实现对hdfs文件的读写等操作，使用管道的方式实现，HADOOP_BIN指向安装的hadoop路径，</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br><span class="line">51</span><br><span class="line">52</span><br><span class="line">53</span><br><span class="line">54</span><br><span class="line">55</span><br><span class="line">56</span><br><span class="line">57</span><br><span class="line">58</span><br><span class="line">59</span><br><span class="line">60</span><br><span class="line">61</span><br><span class="line">62</span><br><span class="line">63</span><br><span class="line">64</span><br><span class="line">65</span><br><span class="line">66</span><br><span class="line">67</span><br><span class="line">68</span><br><span class="line">69</span><br><span class="line">70</span><br><span class="line">71</span><br><span class="line">72</span><br><span class="line">73</span><br><span class="line">74</span><br><span class="line">75</span><br><span class="line">76</span><br><span class="line">77</span><br><span class="line">78</span><br><span class="line">79</span><br><span class="line">80</span><br><span class="line">81</span><br><span class="line">82</span><br><span class="line">83</span><br><span class="line">84</span><br><span class="line">85</span><br><span class="line">86</span><br><span class="line">87</span><br><span class="line">88</span><br><span class="line">89</span><br><span class="line">90</span><br><span class="line">91</span><br><span class="line">92</span><br><span class="line">93</span><br><span class="line">94</span><br><span class="line">95</span><br><span class="line">96</span><br><span class="line">97</span><br><span class="line">98</span><br><span class="line">99</span><br><span class="line">100</span><br><span class="line">101</span><br><span class="line">102</span><br><span class="line">103</span><br><span class="line">104</span><br><span class="line">105</span><br><span class="line">106</span><br><span class="line">107</span><br><span class="line">108</span><br><span class="line">109</span><br><span class="line">110</span><br><span class="line">111</span><br><span class="line">112</span><br><span class="line">113</span><br><span class="line">114</span><br><span class="line">115</span><br><span class="line">116</span><br><span class="line">117</span><br><span class="line">118</span><br><span class="line">119</span><br><span class="line">120</span><br><span class="line">121</span><br><span class="line">122</span><br><span class="line">123</span><br><span class="line">124</span><br><span class="line">125</span><br><span class="line">126</span><br><span class="line">127</span><br><span class="line">128</span><br><span class="line">129</span><br><span class="line">130</span><br><span class="line">131</span><br><span class="line">132</span><br><span class="line">133</span><br><span class="line">134</span><br><span class="line">135</span><br><span class="line">136</span><br><span class="line">137</span><br><span class="line">138</span><br><span class="line">139</span><br><span class="line">140</span><br><span class="line">141</span><br><span class="line">142</span><br><span class="line">143</span><br><span class="line">144</span><br><span class="line">145</span><br><span class="line">146</span><br><span class="line">147</span><br><span class="line">148</span><br><span class="line">149</span><br><span class="line">150</span><br><span class="line">151</span><br><span class="line">152</span><br><span class="line">153</span><br><span class="line">154</span><br><span class="line">155</span><br><span class="line">156</span><br><span class="line">157</span><br><span class="line">158</span><br><span class="line">159</span><br><span class="line">160</span><br><span class="line">161</span><br><span class="line">162</span><br><span class="line">163</span><br><span class="line">164</span><br><span class="line">165</span><br><span class="line">166</span><br><span class="line">167</span><br><span class="line">168</span><br><span class="line">169</span><br><span class="line">170</span><br><span class="line">171</span><br><span class="line">172</span><br><span class="line">173</span><br><span class="line">174</span><br><span class="line">175</span><br><span class="line">176</span><br><span class="line">177</span><br><span class="line">178</span><br><span class="line">179</span><br><span class="line">180</span><br><span class="line">181</span><br><span class="line">182</span><br><span class="line">183</span><br><span class="line">184</span><br><span class="line">185</span><br><span class="line">186</span><br><span class="line">187</span><br><span class="line">188</span><br><span class="line">189</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># !/usr/bin/env python</span></span><br><span class="line"><span class="comment"># -*- coding:utf-8 -*-</span></span><br><span class="line"></span><br><span class="line">from __future__ import print_function</span><br><span class="line"></span><br><span class="line">import glob</span><br><span class="line">import logging</span><br><span class="line">import os</span><br><span class="line">import shutil</span><br><span class="line">import subprocess</span><br><span class="line">import traceback</span><br><span class="line">from contextlib import contextmanager</span><br><span class="line">from typing import IO, Any</span><br><span class="line"></span><br><span class="line"><span class="built_in">head</span> = <span class="string">&#x27;%(asctime)s - %(name)s - [%(process)d - %(levelname)s] :: [%(module)s|%(lineno)s] ==&gt;&gt; %(message)s&#x27;</span></span><br><span class="line">logging.basicConfig(format=<span class="built_in">head</span>)</span><br><span class="line">logger = logging.getLogger()</span><br><span class="line">logger.setLevel(logging.INFO)</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">HADOOP_BIN = <span class="string">&#x27;/opt/tiger/yarn_deploy/hadoop/bin/hadoop&#x27;</span></span><br><span class="line"><span class="comment"># HADOOP_BIN = &#x27;PATH=/usr/bin/:$PATH hdfs&#x27;</span></span><br><span class="line"></span><br><span class="line"></span><br><span class="line">@contextmanager</span><br><span class="line">def hopen(hdfs_path, mode=<span class="string">&quot;r&quot;</span>):</span><br><span class="line">    pipe = None</span><br><span class="line">    assert hdfs_path.startswith(<span class="string">&quot;hdfs&quot;</span>), <span class="string">&quot;HDFS is [&#123;&#125;], the prefix shuld be &#x27;hdfs://&#x27; &quot;</span>.format(hdfs_path)</span><br><span class="line">    <span class="keyword">if</span> mode.startswith(<span class="string">&quot;r&quot;</span>):</span><br><span class="line">        pipe = subprocess.Popen(</span><br><span class="line">            <span class="string">&quot;&#123;&#125; fs -text &#123;&#125;&quot;</span>.format(HADOOP_BIN, hdfs_path), shell=True, stdout=subprocess.PIPE)</span><br><span class="line">        yield pipe.stdout</span><br><span class="line">        pipe.stdout.close()</span><br><span class="line">        pipe.wait()</span><br><span class="line">        <span class="built_in">return</span></span><br><span class="line">    <span class="keyword">if</span> mode == <span class="string">&quot;wa&quot;</span>:</span><br><span class="line">        pipe = subprocess.Popen(</span><br><span class="line">            <span class="string">&quot;&#123;&#125; fs -appendToFile - &#123;&#125;&quot;</span>.format(HADOOP_BIN, hdfs_path), shell=True, stdin=subprocess.PIPE)</span><br><span class="line">        yield pipe.stdin</span><br><span class="line">        pipe.stdin.close()</span><br><span class="line">        pipe.wait()</span><br><span class="line">        <span class="built_in">return</span></span><br><span class="line">    <span class="keyword">if</span> mode.startswith(<span class="string">&quot;w&quot;</span>):</span><br><span class="line">        pipe = subprocess.Popen(</span><br><span class="line">            <span class="string">&quot;&#123;&#125; fs -put -f - &#123;&#125;&quot;</span>.format(HADOOP_BIN, hdfs_path), shell=True, stdin=subprocess.PIPE)</span><br><span class="line">        yield pipe.stdin</span><br><span class="line">        pipe.stdin.close()</span><br><span class="line">        pipe.wait()</span><br><span class="line">        <span class="built_in">return</span></span><br><span class="line">    raise RuntimeError(<span class="string">&quot;unsupported io mode: &#123;&#125;&quot;</span>.format(mode))</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">def hmerge(folders, dst, prefix=<span class="string">&quot;&quot;</span>, dedupe=False, **kwargs):</span><br><span class="line">    nums = 0</span><br><span class="line">    all_files = hdfs_files(folders, prefix)</span><br><span class="line">    logger.info(<span class="string">&quot;All files: &#123;&#125;&quot;</span>.format(all_files))</span><br><span class="line">    unique = &#123;&#125;</span><br><span class="line">    with hopen(dst, mode=<span class="string">&quot;wa&quot;</span>) as writer:</span><br><span class="line">        try:</span><br><span class="line">            <span class="keyword">for</span> one <span class="keyword">in</span> all_files:</span><br><span class="line">                with hopen(one, mode=<span class="string">&quot;r&quot;</span>) as reader:</span><br><span class="line">                    <span class="keyword">for</span> line <span class="keyword">in</span> reader:</span><br><span class="line">                        line = line.strip()</span><br><span class="line">                        <span class="keyword">if</span> isinstance(line, bytes):</span><br><span class="line">                            line = line.decode(<span class="string">&#x27;utf-8&#x27;</span>)</span><br><span class="line">                        <span class="keyword">if</span> line:</span><br><span class="line">                            <span class="keyword">if</span> dedupe:</span><br><span class="line">                                key = line.split(<span class="string">&quot;\t&quot;</span>)[0]</span><br><span class="line">                                <span class="keyword">if</span> key not <span class="keyword">in</span> unique:</span><br><span class="line">                                    unique[key] = 1</span><br><span class="line">                                    msg = line + <span class="string">&quot;\n&quot;</span></span><br><span class="line">                                    writer.write(msg.encode(<span class="string">&#x27;utf-8&#x27;</span>))</span><br><span class="line">                                    nums += 1</span><br><span class="line">                            <span class="keyword">else</span>:</span><br><span class="line">                                msg = line + <span class="string">&quot;\n&quot;</span></span><br><span class="line">                                writer.write(msg.encode(<span class="string">&#x27;utf-8&#x27;</span>))</span><br><span class="line">                                nums += 1</span><br><span class="line">                            <span class="keyword">if</span> nums % 100 == 0:</span><br><span class="line">                                logger.info(<span class="string">&quot;Already write [&#123;&#125;] lines&quot;</span>.format(nums))</span><br><span class="line">        except:</span><br><span class="line">            logger.error(traceback.format_exc())</span><br><span class="line">            pass</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">def hlinenums(filepath, **kwargs):</span><br><span class="line">    <span class="keyword">if</span> not filepath.startswith(<span class="string">&quot;hdfs://&quot;</span>):</span><br><span class="line">        status, contents = subprocess.getstatusoutput(<span class="string">&quot;cat &#123;&#125; | wc -l&quot;</span>.format(filepath))</span><br><span class="line">        num = contents.replace(<span class="string">&quot; &quot;</span>, <span class="string">&quot;&quot;</span>)</span><br><span class="line">        <span class="built_in">return</span> int(num)</span><br><span class="line">    <span class="keyword">else</span>:</span><br><span class="line">        <span class="keyword">while</span> 1:</span><br><span class="line">            try:</span><br><span class="line">                status, contents = subprocess.getstatusoutput(<span class="string">&quot;&#123;&#125; fs -text &#123;&#125; | wc -l&quot;</span>.format(HADOOP_BIN, filepath))</span><br><span class="line">                num = contents.replace(<span class="string">&quot; &quot;</span>, <span class="string">&quot;&quot;</span>)</span><br><span class="line">                <span class="keyword">if</span> int(num) &gt;= 0:</span><br><span class="line">                    <span class="built_in">return</span> int(num)</span><br><span class="line">            except:</span><br><span class="line">                traceback.print_exc()</span><br><span class="line">                pass</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">def hexist(filepath, **kwargs):</span><br><span class="line">    <span class="keyword">if</span> not filepath.startswith(<span class="string">&quot;hdfs://&quot;</span>):</span><br><span class="line">        <span class="built_in">return</span> os.path.exists(filepath)</span><br><span class="line">    <span class="keyword">else</span>:</span><br><span class="line">        flage = subprocess.call(<span class="string">&quot;&#123;&#125; fs -test -e &#123;&#125;&quot;</span>.format(HADOOP_BIN, filepath), shell=True, stdin=subprocess.PIPE)</span><br><span class="line">        <span class="built_in">return</span> flage == 0</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">def hmkdir(filepath, **kwargs):</span><br><span class="line">    <span class="keyword">if</span> not filepath.startswith(<span class="string">&quot;hdfs://&quot;</span>):</span><br><span class="line">        os.makedirs(filepath, exist_ok=True)</span><br><span class="line">    <span class="keyword">else</span>:</span><br><span class="line">        subprocess.call(<span class="string">&quot;&#123;&#125; fs -mkdir &#123;&#125;&quot;</span>.format(HADOOP_BIN, filepath), shell=True, stdin=subprocess.PIPE)</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">def hcopy(src, dst, **kwargs):</span><br><span class="line">    <span class="keyword">if</span> not dst.startswith(<span class="string">&quot;hdfs://&quot;</span>):</span><br><span class="line">        shutil.copy(src, dst)</span><br><span class="line">    <span class="keyword">else</span>:</span><br><span class="line">        subprocess.call(<span class="string">&quot;&#123;&#125; fs -copyFromLocal -f &#123;&#125; &#123;&#125;/&quot;</span>.format(HADOOP_BIN, src, dst), shell=True)</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">def hisfile(filepath, **kwargs):</span><br><span class="line">    <span class="keyword">if</span> not filepath.startswith(<span class="string">&quot;hdfs://&quot;</span>):</span><br><span class="line">        <span class="built_in">return</span> os.path.isfile(filepath)</span><br><span class="line">    <span class="keyword">else</span>:</span><br><span class="line">        flage = subprocess.call(<span class="string">&quot;&#123;&#125; fs -test -d &#123;&#125;&quot;</span>.format(HADOOP_BIN, filepath), shell=True, stdin=subprocess.PIPE)</span><br><span class="line">        <span class="keyword">if</span> flage == 1:</span><br><span class="line">            <span class="built_in">return</span> hexist(filepath)</span><br><span class="line">        <span class="built_in">return</span> False</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">def hisdir(filepath, **kwargs):</span><br><span class="line">    <span class="keyword">if</span> not filepath.startswith(<span class="string">&quot;hdfs://&quot;</span>):</span><br><span class="line">        <span class="built_in">return</span> os.path.isdir(filepath)</span><br><span class="line">    <span class="keyword">else</span>:</span><br><span class="line">        flage = subprocess.call(<span class="string">&quot;&#123;&#125; fs -test -d &#123;&#125;&quot;</span>.format(HADOOP_BIN, filepath), shell=True, stdin=subprocess.PIPE)</span><br><span class="line">        <span class="built_in">return</span> flage == 0</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">def hdelete(filepath, **kwargs):</span><br><span class="line">    <span class="keyword">if</span> not filepath.startswith(<span class="string">&quot;hdfs://&quot;</span>):</span><br><span class="line">        shutil.rmtree(filepath)</span><br><span class="line">    <span class="keyword">else</span>:</span><br><span class="line">        subprocess.call(<span class="string">&quot;&#123;&#125; fs -rm -r &#123;&#125;&quot;</span>.format(HADOOP_BIN, filepath), shell=True, stdin=subprocess.PIPE)</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">def hglob(search_path, sort_by_time=False):</span><br><span class="line">    <span class="keyword">if</span> search_path.startswith(<span class="string">&quot;hdfs&quot;</span>):</span><br><span class="line">        <span class="keyword">if</span> sort_by_time:</span><br><span class="line">            hdfs_command = HADOOP_BIN + <span class="string">&#x27; fs -ls %s | sort -k6,7&#x27;</span> % search_path</span><br><span class="line">        <span class="keyword">else</span>:</span><br><span class="line">            hdfs_command = HADOOP_BIN + <span class="string">&#x27; fs -ls %s&#x27;</span> % search_path</span><br><span class="line">        path_list = []</span><br><span class="line">        files = os.popen(hdfs_command).<span class="built_in">read</span>()</span><br><span class="line">        files = files.split(<span class="string">&quot;\n&quot;</span>)</span><br><span class="line">        <span class="keyword">for</span> _file <span class="keyword">in</span> files:</span><br><span class="line">            <span class="keyword">if</span> <span class="string">&#x27;hdfs&#x27;</span> <span class="keyword">in</span> _file:</span><br><span class="line">                startindex = _file.index(<span class="string">&#x27;hdfs&#x27;</span>)</span><br><span class="line">                path_list.append(_file[startindex:])</span><br><span class="line">        <span class="built_in">return</span> path_list</span><br><span class="line">    <span class="keyword">else</span>:</span><br><span class="line">        <span class="built_in">return</span> glob.glob(search_path)</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">def hdfs_files(folders, prefix=<span class="string">&quot;&quot;</span>):</span><br><span class="line">    files = []</span><br><span class="line">    <span class="keyword">for</span> folder <span class="keyword">in</span> folders:</span><br><span class="line">        pipe = subprocess.Popen(<span class="string">&quot;&#123;&#125; fs -ls &#123;&#125;&quot;</span>.format(HADOOP_BIN, folder), shell=True, stdout=subprocess.PIPE)</span><br><span class="line">        <span class="keyword">for</span> line <span class="keyword">in</span> pipe.stdout:</span><br><span class="line">            line = line.strip()</span><br><span class="line">            <span class="comment"># drwxr-xr-x   - user group  4 file</span></span><br><span class="line">            <span class="keyword">if</span> len(line.split()) &lt; 5:</span><br><span class="line">                <span class="built_in">continue</span></span><br><span class="line">            file_path = line.split()[-1].decode(<span class="string">&quot;utf8&quot;</span>)</span><br><span class="line">            <span class="keyword">if</span> prefix:</span><br><span class="line">                <span class="keyword">if</span> prefix == os.path.splitext(file_path)[-1] or os.path.basename(file_path).startswith(prefix):</span><br><span class="line">                    files.append(file_path)</span><br><span class="line">            <span class="keyword">else</span>:</span><br><span class="line">                files.append(file_path)</span><br><span class="line">        pipe.stdout.close()</span><br><span class="line">        pipe.wait()</span><br><span class="line">    <span class="built_in">return</span> files</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">__all__ = [<span class="string">&quot;hopen&quot;</span>, <span class="string">&quot;hexist&quot;</span>, <span class="string">&quot;hmerge&quot;</span>, <span class="string">&quot;hdfs_files&quot;</span>, <span class="string">&quot;hglob&quot;</span>,</span><br><span class="line">           <span class="string">&quot;hdelete&quot;</span>, <span class="string">&quot;hisdir&quot;</span>, <span class="string">&quot;hisfile&quot;</span>, <span class="string">&quot;hcopy&quot;</span>, <span class="string">&quot;hmkdir&quot;</span>, <span class="string">&quot;hlinenums&quot;</span>]</span><br><span class="line"></span><br></pre></td></tr></table></figure><h2 id="报错解决汇总"><a href="#报错解决汇总" class="headerlink" title="报错解决汇总"></a>报错解决汇总</h2><h3 id="locale-Error-unsupported-locale-setting"><a href="#locale-Error-unsupported-locale-setting" class="headerlink" title="locale.Error: unsupported locale setting"></a>locale.Error: unsupported locale setting</h3><p>解决方案</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line"><span class="built_in">export</span> LC_ALL=C</span><br></pre></td></tr></table></figure><p>链接： <a href="https://stackoverflow.com/questions/36394101/pip-install-locale-error-unsupported-locale-setting">https://stackoverflow.com/questions/36394101/pip-install-locale-error-unsupported-locale-setting</a></p><h3 id="UnicodeDecodeError"><a href="#UnicodeDecodeError" class="headerlink" title="UnicodeDecodeError"></a>UnicodeDecodeError</h3><p>这个是一大类的错误，顾名思义就是编码错误了，一版情况下是读取数据的时候读取错误造成的，比如说使用py2生成的文件，使用py3读取，因为py2的默认编码方式是unicode，而py3的默认编码方式是utf8，就很可能造成这个错误，解决方案</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">with</span> <span class="built_in">open</span>(filepath,<span class="string">&quot;rb&quot;</span>) <span class="keyword">as</span> fi:</span><br><span class="line">   xxx</span><br></pre></td></tr></table></figure><p>关键就是使用<code>rb</code>方式打开文件，如果不添加打开方式或者使用&#96;r的方式打开，会产生**’utf-8’ codec can’t decode byte 0x87 in position 0: invalid start byte**类似的错误。</p>]]>
    </content>
    <id>https://xiaofengshi.com/2020/01/29/Awesomes-Python/</id>
    <link href="https://xiaofengshi.com/2020/01/29/Awesomes-Python/"/>
    <published>2020-01-29T13:22:42.000Z</published>
    <summary>
      <![CDATA[<p>本篇涉及平时工作中使用的一些<strong>Python</strong>相关轮子，在此记录，不断补充更新……</p>
<img src="/2020/01/29/Awesomes-Python/python.png" class="" title="Python">]]>
    </summary>
    <title>Awesomes-Python</title>
    <updated>2020-10-21T12:46:36.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Xiaofeng Shi</name>
    </author>
    <category term="深度学习" scheme="https://xiaofengshi.com/categories/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    <category term="NLP" scheme="https://xiaofengshi.com/categories/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/NLP/"/>
    <category term="深度学习" scheme="https://xiaofengshi.com/tags/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    <category term="NLP" scheme="https://xiaofengshi.com/tags/NLP/"/>
    <content>
      <![CDATA[<img src="/2019/12/10/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-NLP-BERT/bert.png" class="" title="BERT"><p><strong>BERT</strong>全名为(<strong>Bidirectional Encoder Representations from Transformers</strong>), 在<strong>NLP</strong>领域作为<strong>Word2vec</strong>的替代者，将NLP中的<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>11</mn></mrow></semantics></math></span></span>项任务精度向前大大推进，作为一名算法工程师，非常有必要好好研究一下。</p><span id="more"></span><h2 id="BERT的背景和特点"><a href="#BERT的背景和特点" class="headerlink" title="BERT的背景和特点"></a>BERT的背景和特点</h2><h3 id="背景"><a href="#背景" class="headerlink" title="背景"></a>背景</h3><p>​在<code>CV</code>领域，我们一般会使用基于<strong>Imagenet</strong>预训练的模型权重作为其他任务的basenet，这样不仅能够提高模型的泛化能力并且可以减少训练时间，使训练过程更加平稳，这是预训练带来的好处。在<code>NLP</code>领域，BERT就是要做这样的事情，在通用数据上学习词向量，并能够迁移到其他下游子任务。</p><h3 id="特点"><a href="#特点" class="headerlink" title="特点"></a>特点</h3><ol><li>对<strong>Transformer</strong>结构的极致使用</li><li>在预训练时，使用<code>MLM(Mask Language Model)</code>和<code>NSP(Next Sentence Prediction)</code>作为训练目标捕获词和句的关系，句和句的关系<ol><li><code>MLM</code>：随机mask一些词进行预测，类似于完形填空，该任务主要捕获序列不同词之间的关系</li><li><code>NSP</code>：预测两个句子是否是连续前后句关系，给定两个句子，预测后面的句子是否是前面的句子的下一句，该任务主要捕获不同序列之间的关系</li></ol></li><li>使用海量的数据进行训练，可以进行分布式训练</li><li>可以方便用于其他任务的迁移和微调，例如句子相关性，机器翻译，语音识别，关键词提取等NLP相关任务</li></ol><p>BERT有可能存在的问题</p><ol><li>由于<code>transformer</code>的利用，使用<code>position embding </code>来捕获序列中元素的位置关系，但是在巨量数据中，<code>transformer</code>对元素位置的信息表征不强</li></ol><h2 id="BERT如何工作"><a href="#BERT如何工作" class="headerlink" title="BERT如何工作"></a>BERT如何工作</h2><p>Bert使用了transformer结构，一种google提出的注意力学习机制，用以学习文本中不同token之间的上下文关系。在transformer中包含encoder和decoder部分，由于BERT的目的是生成语言模型，因此只需要transformer中的encoder部分。关于transformer，相关详细讲解以前有写过<a href="http://xiaofengshi.com/2019/02/15/NLP-Attention_is_all_you_need/">👉👉👉</a>。</p><p> transformer改变了原来使用RNN的方式，在RNN中为了捕获当前词语和其左右两侧词语的关系一般使用BiRNN设计，并且RNN不能进行并行设计，无法利用GPU加速运算。在Transformer中输入不再入RNN相同的是单个token而是整个sequence，并且加入输入的sequence中每个token的位置信息，这样每个token自然可以接收到它的上下文信息，并且这种设计可以使用GPU进行加速运算。</p><img src="/2019/12/10/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-NLP-BERT/transformer.png" class="" title="[TransformerBlock]"><h3 id="MLM"><a href="#MLM" class="headerlink" title="MLM"></a>MLM</h3><p>如开始所述，<code>MLM</code>任务类似于我们做过的完形填空，是为了学习<code>token</code>的上下文关系。在输入的序列中选择所有<code>token</code>的<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>15</mn><mi mathvariant="normal">%</mi></mrow></semantics></math></span></span>的比例进行<code>mask</code>处理，在这<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>15</mn><mi mathvariant="normal">%</mi></mrow></semantics></math></span></span>中选择<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>80</mn><mi mathvariant="normal">%</mi></mrow></semantics></math></span></span>使用<code>MASK</code>进行替换，<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>15</mn><mi mathvariant="normal">%</mi></mrow></semantics></math></span></span>从此表中随机选择其它<code>token</code>替换，<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>10</mn><mi mathvariant="normal">%</mi></mrow></semantics></math></span></span>保持原来的<code>token</code>不变，这样设计的<code>MLM</code>任务，既保证了当前的模型见过真正的词是什么，又见过随机替换的次和空白词，有助于模型能够学习到根据其余词推断当前词的能力。</p><p>在网络设计上，在模型输出的最后一层接一个全连接层将输出特征的维度转化为词表大小，然后在使用softmax和交叉熵损失来进行设计，和通用的分类网络最后部分相同，在计算损失的时候，只计算数据中被MASK的部分的损失。</p><h3 id="NSP"><a href="#NSP" class="headerlink" title="NSP"></a>NSP</h3><p><strong>NSP</strong>是为了学习句子之间上下文关系，通俗的将就是，给你两个句子，你来判断这两个句子是不是挨着的，如果是挨着的那么就是1，否则就是0。在<code>BERT</code>中模型接收的是成对的句子，并学习预测成对的第二个句子是否是第一个句子在原始文档中的后续句子。 在数据制作时，第二个句子有<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>50</mn><mi mathvariant="normal">%</mi></mrow></semantics></math></span></span>的概率是真是的第一个句子的后续句子，<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>50</mn><mi mathvariant="normal">%</mi></mrow></semantics></math></span></span>的概率是从其余的文档中随机抽选的句子，并且有一个先验就是，随机选择的句子和第一个句子是没啥关系的。为了让模型能够顺利学习两个句子之间的上下文关系，在数据原始数据中要进行一些处理，</p><ol><li>在输入的序列的头部插入入<code>CLS</code>这个<code>token</code>，在第一个句子结束后插入<code>SEP</code>，如果两个句子满足上下文关系那么<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>C</mi><mi>L</mi><mi>S</mi><mo>&#x3D;</mo><mn>1</mn></mrow></semantics></math></span></span>，否则为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>0</mn></mrow></semantics></math></span></span>；</li><li>在输入的向量中加入<code>token type</code>的<code>embeding</code>，标识当前的<code>token</code>归属于第一个句子还是第二个句子。</li><li>加入位置向量，用来表征输入的<code>token</code>的位置信息。</li></ol><img src="/2019/12/10/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-NLP-BERT/bert_preprocess.png" class="" title="Bert feature input"><p>在网络设计上，在模型输出的最后一层，取第一个位置进行全连接转化维度为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>2</mn></mrow></semantics></math></span></span>，进行一个0&#x2F;1分类的损失计算。</p><h2 id="BERT代码研究"><a href="#BERT代码研究" class="headerlink" title="BERT代码研究"></a>BERT代码研究</h2><p>下面结合官方代码进行分析 <a href="https://github.com/google-research/bert">https://github.com/google-research/bert</a></p><img src="/2019/12/10/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-NLP-BERT/bert_structure.png" class="" title="[BertStructure]"><p>图中<code>Trm</code>对应一个Transformer Block模块。在Tansformer中，position embeding将序列中任意两个点之间的距离都转化成了1，因此在BERT中，得益于transformer的应用，可以捕获所有层中的左右两侧的语义信息。</p><h3 id="数据处理"><a href="#数据处理" class="headerlink" title="数据处理"></a>数据处理</h3><p>在<code>BERT</code>中，输入的编码向量由三部分组成</p><h4 id="Tokens"><a href="#Tokens" class="headerlink" title="Tokens"></a>Tokens</h4><p>将输入的单词划分成一组有限的公共子词单元，也就是“拆词”，这个在英文在试有必要的，这样能够能在单词的有效性和字符的灵活性之间取得一个折中的平衡；但是在中文中，最小的单位就是一个字，不需要再进行拆分。官方代码位置 <a href="https://github.com/google-research/bert/blob/master/tokenization.py#L161%EF%BC%8C%E6%88%91%E5%AF%B9%E5%85%B6%E4%B8%AD%E8%BF%9B%E8%A1%8C%E4%BA%86%E9%83%A8%E5%88%86%E4%BF%AE%E6%94%B9%EF%BC%8C">https://github.com/google-research/bert/blob/master/tokenization.py#L161，我对其中进行了部分修改，</a></p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br><span class="line">51</span><br><span class="line">52</span><br><span class="line">53</span><br><span class="line">54</span><br><span class="line">55</span><br><span class="line">56</span><br><span class="line">57</span><br><span class="line">58</span><br><span class="line">59</span><br><span class="line">60</span><br><span class="line">61</span><br><span class="line">62</span><br><span class="line">63</span><br><span class="line">64</span><br><span class="line">65</span><br><span class="line">66</span><br><span class="line">67</span><br><span class="line">68</span><br><span class="line">69</span><br><span class="line">70</span><br><span class="line">71</span><br><span class="line">72</span><br><span class="line">73</span><br><span class="line">74</span><br><span class="line">75</span><br><span class="line">76</span><br><span class="line">77</span><br><span class="line">78</span><br><span class="line">79</span><br><span class="line">80</span><br><span class="line">81</span><br><span class="line">82</span><br><span class="line">83</span><br><span class="line">84</span><br><span class="line">85</span><br><span class="line">86</span><br><span class="line">87</span><br><span class="line">88</span><br><span class="line">89</span><br><span class="line">90</span><br><span class="line">91</span><br><span class="line">92</span><br><span class="line">93</span><br><span class="line">94</span><br><span class="line">95</span><br><span class="line">96</span><br><span class="line">97</span><br><span class="line">98</span><br><span class="line">99</span><br><span class="line">100</span><br><span class="line">101</span><br><span class="line">102</span><br><span class="line">103</span><br><span class="line">104</span><br><span class="line">105</span><br><span class="line">106</span><br><span class="line">107</span><br><span class="line">108</span><br><span class="line">109</span><br><span class="line">110</span><br><span class="line">111</span><br><span class="line">112</span><br><span class="line">113</span><br><span class="line">114</span><br><span class="line">115</span><br><span class="line">116</span><br><span class="line">117</span><br><span class="line">118</span><br><span class="line">119</span><br><span class="line">120</span><br><span class="line">121</span><br><span class="line">122</span><br><span class="line">123</span><br><span class="line">124</span><br><span class="line">125</span><br><span class="line">126</span><br><span class="line">127</span><br><span class="line">128</span><br><span class="line">129</span><br><span class="line">130</span><br><span class="line">131</span><br><span class="line">132</span><br><span class="line">133</span><br><span class="line">134</span><br><span class="line">135</span><br><span class="line">136</span><br><span class="line">137</span><br><span class="line">138</span><br><span class="line">139</span><br><span class="line">140</span><br><span class="line">141</span><br><span class="line">142</span><br><span class="line">143</span><br><span class="line">144</span><br><span class="line">145</span><br><span class="line">146</span><br><span class="line">147</span><br><span class="line">148</span><br><span class="line">149</span><br><span class="line">150</span><br><span class="line">151</span><br><span class="line">152</span><br><span class="line">153</span><br><span class="line">154</span><br><span class="line">155</span><br><span class="line">156</span><br><span class="line">157</span><br><span class="line">158</span><br><span class="line">159</span><br><span class="line">160</span><br><span class="line">161</span><br><span class="line">162</span><br><span class="line">163</span><br><span class="line">164</span><br><span class="line">165</span><br><span class="line">166</span><br><span class="line">167</span><br><span class="line">168</span><br><span class="line">169</span><br><span class="line">170</span><br><span class="line">171</span><br><span class="line">172</span><br><span class="line">173</span><br><span class="line">174</span><br><span class="line">175</span><br><span class="line">176</span><br><span class="line">177</span><br><span class="line">178</span><br><span class="line">179</span><br><span class="line">180</span><br><span class="line">181</span><br><span class="line">182</span><br><span class="line">183</span><br><span class="line">184</span><br><span class="line">185</span><br><span class="line">186</span><br><span class="line">187</span><br><span class="line">188</span><br><span class="line">189</span><br><span class="line">190</span><br><span class="line">191</span><br><span class="line">192</span><br><span class="line">193</span><br><span class="line">194</span><br><span class="line">195</span><br><span class="line">196</span><br><span class="line">197</span><br><span class="line">198</span><br><span class="line">199</span><br><span class="line">200</span><br><span class="line">201</span><br><span class="line">202</span><br><span class="line">203</span><br><span class="line">204</span><br><span class="line">205</span><br><span class="line">206</span><br><span class="line">207</span><br><span class="line">208</span><br><span class="line">209</span><br><span class="line">210</span><br><span class="line">211</span><br><span class="line">212</span><br><span class="line">213</span><br><span class="line">214</span><br><span class="line">215</span><br><span class="line">216</span><br><span class="line">217</span><br><span class="line">218</span><br><span class="line">219</span><br><span class="line">220</span><br><span class="line">221</span><br><span class="line">222</span><br><span class="line">223</span><br><span class="line">224</span><br><span class="line">225</span><br><span class="line">226</span><br><span class="line">227</span><br><span class="line">228</span><br><span class="line">229</span><br><span class="line">230</span><br><span class="line">231</span><br><span class="line">232</span><br><span class="line">233</span><br><span class="line">234</span><br><span class="line">235</span><br><span class="line">236</span><br><span class="line">237</span><br><span class="line">238</span><br><span class="line">239</span><br><span class="line">240</span><br><span class="line">241</span><br><span class="line">242</span><br><span class="line">243</span><br><span class="line">244</span><br><span class="line">245</span><br><span class="line">246</span><br><span class="line">247</span><br><span class="line">248</span><br><span class="line">249</span><br><span class="line">250</span><br><span class="line">251</span><br><span class="line">252</span><br><span class="line">253</span><br><span class="line">254</span><br><span class="line">255</span><br><span class="line">256</span><br><span class="line">257</span><br><span class="line">258</span><br><span class="line">259</span><br><span class="line">260</span><br><span class="line">261</span><br><span class="line">262</span><br><span class="line">263</span><br><span class="line">264</span><br><span class="line">265</span><br><span class="line">266</span><br><span class="line">267</span><br><span class="line">268</span><br><span class="line">269</span><br><span class="line">270</span><br><span class="line">271</span><br><span class="line">272</span><br><span class="line">273</span><br><span class="line">274</span><br><span class="line">275</span><br><span class="line">276</span><br><span class="line">277</span><br><span class="line">278</span><br><span class="line">279</span><br><span class="line">280</span><br><span class="line">281</span><br><span class="line">282</span><br><span class="line">283</span><br><span class="line">284</span><br><span class="line">285</span><br><span class="line">286</span><br><span class="line">287</span><br><span class="line">288</span><br><span class="line">289</span><br><span class="line">290</span><br><span class="line">291</span><br><span class="line">292</span><br><span class="line">293</span><br><span class="line">294</span><br><span class="line">295</span><br><span class="line">296</span><br><span class="line">297</span><br><span class="line">298</span><br><span class="line">299</span><br><span class="line">300</span><br><span class="line">301</span><br><span class="line">302</span><br><span class="line">303</span><br><span class="line">304</span><br><span class="line">305</span><br><span class="line">306</span><br><span class="line">307</span><br><span class="line">308</span><br><span class="line">309</span><br><span class="line">310</span><br><span class="line">311</span><br><span class="line">312</span><br><span class="line">313</span><br><span class="line">314</span><br><span class="line">315</span><br><span class="line">316</span><br><span class="line">317</span><br><span class="line">318</span><br><span class="line">319</span><br><span class="line">320</span><br><span class="line">321</span><br><span class="line">322</span><br><span class="line">323</span><br><span class="line">324</span><br><span class="line">325</span><br><span class="line">326</span><br><span class="line">327</span><br><span class="line">328</span><br><span class="line">329</span><br><span class="line">330</span><br><span class="line">331</span><br><span class="line">332</span><br><span class="line">333</span><br><span class="line">334</span><br><span class="line">335</span><br><span class="line">336</span><br><span class="line">337</span><br><span class="line">338</span><br><span class="line">339</span><br><span class="line">340</span><br><span class="line">341</span><br><span class="line">342</span><br><span class="line">343</span><br><span class="line">344</span><br><span class="line">345</span><br><span class="line">346</span><br><span class="line">347</span><br><span class="line">348</span><br><span class="line">349</span><br><span class="line">350</span><br><span class="line">351</span><br><span class="line">352</span><br><span class="line">353</span><br><span class="line">354</span><br><span class="line">355</span><br><span class="line">356</span><br><span class="line">357</span><br><span class="line">358</span><br><span class="line">359</span><br><span class="line">360</span><br><span class="line">361</span><br><span class="line">362</span><br><span class="line">363</span><br><span class="line">364</span><br><span class="line">365</span><br><span class="line">366</span><br><span class="line">367</span><br><span class="line">368</span><br><span class="line">369</span><br><span class="line">370</span><br><span class="line">371</span><br><span class="line">372</span><br><span class="line">373</span><br><span class="line">374</span><br><span class="line">375</span><br><span class="line">376</span><br><span class="line">377</span><br><span class="line">378</span><br><span class="line">379</span><br><span class="line">380</span><br><span class="line">381</span><br><span class="line">382</span><br><span class="line">383</span><br><span class="line">384</span><br><span class="line">385</span><br><span class="line">386</span><br><span class="line">387</span><br><span class="line">388</span><br><span class="line">389</span><br><span class="line">390</span><br><span class="line">391</span><br><span class="line">392</span><br><span class="line">393</span><br><span class="line">394</span><br><span class="line">395</span><br><span class="line">396</span><br><span class="line">397</span><br><span class="line">398</span><br><span class="line">399</span><br><span class="line">400</span><br><span class="line">401</span><br><span class="line">402</span><br><span class="line">403</span><br><span class="line">404</span><br><span class="line">405</span><br><span class="line">406</span><br><span class="line">407</span><br><span class="line">408</span><br><span class="line">409</span><br><span class="line">410</span><br><span class="line">411</span><br><span class="line">412</span><br><span class="line">413</span><br><span class="line">414</span><br><span class="line">415</span><br><span class="line">416</span><br><span class="line">417</span><br><span class="line">418</span><br><span class="line">419</span><br><span class="line">420</span><br><span class="line">421</span><br><span class="line">422</span><br><span class="line">423</span><br><span class="line">424</span><br><span class="line">425</span><br><span class="line">426</span><br><span class="line">427</span><br><span class="line">428</span><br><span class="line">429</span><br><span class="line">430</span><br><span class="line">431</span><br><span class="line">432</span><br><span class="line">433</span><br><span class="line">434</span><br><span class="line">435</span><br><span class="line">436</span><br></pre></td><td class="code"><pre><span class="line"></span><br><span class="line"><span class="keyword">from</span> __future__ <span class="keyword">import</span> absolute_import</span><br><span class="line"><span class="keyword">from</span> __future__ <span class="keyword">import</span> division</span><br><span class="line"><span class="keyword">from</span> __future__ <span class="keyword">import</span> print_function</span><br><span class="line"></span><br><span class="line"><span class="keyword">import</span> collections</span><br><span class="line"><span class="keyword">import</span> re</span><br><span class="line"><span class="keyword">import</span> unicodedata</span><br><span class="line"><span class="keyword">import</span> six</span><br><span class="line"><span class="keyword">import</span> tensorflow <span class="keyword">as</span> tf</span><br><span class="line"><span class="keyword">import</span> sys</span><br><span class="line"><span class="keyword">import</span> traceback</span><br><span class="line"><span class="keyword">import</span> logging</span><br><span class="line"></span><br><span class="line">reload(sys)</span><br><span class="line">sys.setdefaultencoding(<span class="string">&#x27;utf8&#x27;</span>)</span><br><span class="line"></span><br><span class="line">logger=logging</span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">validate_case_matches_checkpoint</span>(<span class="params">do_lower_case, init_checkpoint</span>):</span><br><span class="line">    <span class="string">&quot;&quot;&quot;Checks whether the casing config is consistent with the checkpoint name.&quot;&quot;&quot;</span></span><br><span class="line"></span><br><span class="line">    <span class="comment"># The casing has to be passed in by the user and there is no explicit check</span></span><br><span class="line">    <span class="comment"># as to whether it matches the checkpoint. The casing information probably</span></span><br><span class="line">    <span class="comment"># should have been stored in the bert_config.json file, but it&#x27;s not, so</span></span><br><span class="line">    <span class="comment"># we have to heuristically detect it to validate.</span></span><br><span class="line"></span><br><span class="line">    <span class="keyword">if</span> <span class="keyword">not</span> init_checkpoint:</span><br><span class="line">        <span class="keyword">return</span></span><br><span class="line"></span><br><span class="line">    m = re.<span class="keyword">match</span>(<span class="string">&quot;^.*?([A-Za-z0-9_-]+)/bert_model.ckpt&quot;</span>, init_checkpoint)</span><br><span class="line">    <span class="keyword">if</span> m <span class="keyword">is</span> <span class="literal">None</span>:</span><br><span class="line">        <span class="keyword">return</span></span><br><span class="line"></span><br><span class="line">    model_name = m.group(<span class="number">1</span>)</span><br><span class="line"></span><br><span class="line">    lower_models = [</span><br><span class="line">        <span class="string">&quot;uncased_L-24_H-1024_A-16&quot;</span>, <span class="string">&quot;uncased_L-12_H-768_A-12&quot;</span>,</span><br><span class="line">        <span class="string">&quot;multilingual_L-12_H-768_A-12&quot;</span>, <span class="string">&quot;chinese_L-12_H-768_A-12&quot;</span></span><br><span class="line">    ]</span><br><span class="line"></span><br><span class="line">    cased_models = [</span><br><span class="line">        <span class="string">&quot;cased_L-12_H-768_A-12&quot;</span>, <span class="string">&quot;cased_L-24_H-1024_A-16&quot;</span>,</span><br><span class="line">        <span class="string">&quot;multi_cased_L-12_H-768_A-12&quot;</span></span><br><span class="line">    ]</span><br><span class="line"></span><br><span class="line">    is_bad_config = <span class="literal">False</span></span><br><span class="line">    <span class="keyword">if</span> model_name <span class="keyword">in</span> lower_models <span class="keyword">and</span> <span class="keyword">not</span> do_lower_case:</span><br><span class="line">        is_bad_config = <span class="literal">True</span></span><br><span class="line">        actual_flag = <span class="string">&quot;False&quot;</span></span><br><span class="line">        case_name = <span class="string">&quot;lowercased&quot;</span></span><br><span class="line">        opposite_flag = <span class="string">&quot;True&quot;</span></span><br><span class="line"></span><br><span class="line">    <span class="keyword">if</span> model_name <span class="keyword">in</span> cased_models <span class="keyword">and</span> do_lower_case:</span><br><span class="line">        is_bad_config = <span class="literal">True</span></span><br><span class="line">        actual_flag = <span class="string">&quot;True&quot;</span></span><br><span class="line">        case_name = <span class="string">&quot;cased&quot;</span></span><br><span class="line">        opposite_flag = <span class="string">&quot;False&quot;</span></span><br><span class="line"></span><br><span class="line">    <span class="keyword">if</span> is_bad_config:</span><br><span class="line">        <span class="keyword">raise</span> ValueError(</span><br><span class="line">            <span class="string">&quot;You passed in `--do_lower_case=%s` with `--init_checkpoint=%s`. &quot;</span></span><br><span class="line">            <span class="string">&quot;However, `%s` seems to be a %s model, so you &quot;</span></span><br><span class="line">            <span class="string">&quot;should pass in `--do_lower_case=%s` so that the fine-tuning matches &quot;</span></span><br><span class="line">            <span class="string">&quot;how the model was pre-training. If this error is wrong, please &quot;</span></span><br><span class="line">            <span class="string">&quot;just comment out this check.&quot;</span> %</span><br><span class="line">            (actual_flag, init_checkpoint, model_name, case_name,</span><br><span class="line">             opposite_flag))</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">convert_to_unicode</span>(<span class="params">text</span>):</span><br><span class="line">    <span class="string">&quot;&quot;&quot;Converts `text` to Unicode (if it&#x27;s not already), assuming utf-8 input.&quot;&quot;&quot;</span></span><br><span class="line">    <span class="keyword">if</span> six.PY3:</span><br><span class="line">        <span class="keyword">if</span> <span class="built_in">isinstance</span>(text, <span class="built_in">str</span>):</span><br><span class="line">            <span class="keyword">return</span> text</span><br><span class="line">        <span class="keyword">elif</span> <span class="built_in">isinstance</span>(text, <span class="built_in">bytes</span>):</span><br><span class="line">            <span class="keyword">return</span> text.decode(<span class="string">&quot;utf-8&quot;</span>, <span class="string">&quot;ignore&quot;</span>)</span><br><span class="line">        <span class="keyword">else</span>:</span><br><span class="line">            <span class="keyword">raise</span> ValueError(<span class="string">&quot;Unsupported string type: %s&quot;</span> % (<span class="built_in">type</span>(text)))</span><br><span class="line">    <span class="keyword">elif</span> six.PY2:</span><br><span class="line">        <span class="keyword">if</span> <span class="built_in">isinstance</span>(text, <span class="built_in">str</span>):</span><br><span class="line">            <span class="keyword">return</span> text.decode(<span class="string">&quot;utf-8&quot;</span>, <span class="string">&quot;ignore&quot;</span>)</span><br><span class="line">        <span class="keyword">elif</span> <span class="built_in">isinstance</span>(text, unicode):</span><br><span class="line">            <span class="keyword">return</span> text</span><br><span class="line">        <span class="keyword">else</span>:</span><br><span class="line">            <span class="keyword">raise</span> ValueError(<span class="string">&quot;Unsupported string type: %s&quot;</span> % (<span class="built_in">type</span>(text)))</span><br><span class="line">    <span class="keyword">else</span>:</span><br><span class="line">        <span class="keyword">raise</span> ValueError(<span class="string">&quot;Not running on Python2 or Python 3?&quot;</span>)</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">printable_text</span>(<span class="params">text</span>):</span><br><span class="line">    <span class="string">&quot;&quot;&quot;Returns text encoded in a way suitable for print or `tf.logging`.&quot;&quot;&quot;</span></span><br><span class="line"></span><br><span class="line">    <span class="comment"># These functions want `str` for both Python2 and Python3, but in one case</span></span><br><span class="line">    <span class="comment"># it&#x27;s a Unicode string and in the other it&#x27;s a byte string.</span></span><br><span class="line">    <span class="keyword">if</span> six.PY3:</span><br><span class="line">        <span class="keyword">if</span> <span class="built_in">isinstance</span>(text, <span class="built_in">str</span>):</span><br><span class="line">            <span class="keyword">return</span> text</span><br><span class="line">        <span class="keyword">elif</span> <span class="built_in">isinstance</span>(text, <span class="built_in">bytes</span>):</span><br><span class="line">            <span class="keyword">return</span> text.decode(<span class="string">&quot;utf-8&quot;</span>, <span class="string">&quot;ignore&quot;</span>)</span><br><span class="line">        <span class="keyword">else</span>:</span><br><span class="line">            <span class="keyword">raise</span> ValueError(<span class="string">&quot;Unsupported string type: %s&quot;</span> % (<span class="built_in">type</span>(text)))</span><br><span class="line">    <span class="keyword">elif</span> six.PY2:</span><br><span class="line">        <span class="keyword">if</span> <span class="built_in">isinstance</span>(text, <span class="built_in">str</span>):</span><br><span class="line">            <span class="keyword">return</span> text</span><br><span class="line">        <span class="keyword">elif</span> <span class="built_in">isinstance</span>(text, unicode):</span><br><span class="line">            <span class="keyword">return</span> text.encode(<span class="string">&quot;utf-8&quot;</span>)</span><br><span class="line">        <span class="keyword">else</span>:</span><br><span class="line">            <span class="keyword">raise</span> ValueError(<span class="string">&quot;Unsupported string type: %s&quot;</span> % (<span class="built_in">type</span>(text)))</span><br><span class="line">    <span class="keyword">else</span>:</span><br><span class="line">        <span class="keyword">raise</span> ValueError(<span class="string">&quot;Not running on Python2 or Python 3?&quot;</span>)</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">load_vocab</span>(<span class="params">vocab_file</span>):</span><br><span class="line">    <span class="string">&quot;&quot;&quot;Loads a vocabulary file into a dictionary.&quot;&quot;&quot;</span></span><br><span class="line">    vocab = collections.OrderedDict()</span><br><span class="line">    index = <span class="number">0</span></span><br><span class="line">    <span class="keyword">with</span> tf.gfile.GFile(vocab_file, <span class="string">&quot;r&quot;</span>) <span class="keyword">as</span> reader:</span><br><span class="line">        <span class="keyword">while</span> <span class="literal">True</span>:</span><br><span class="line">            token = convert_to_unicode(reader.readline())</span><br><span class="line">            <span class="keyword">if</span> <span class="keyword">not</span> token:</span><br><span class="line">                <span class="keyword">break</span></span><br><span class="line">            token = token.strip()</span><br><span class="line">            vocab[token] = index</span><br><span class="line">            index += <span class="number">1</span></span><br><span class="line">    <span class="keyword">return</span> vocab</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">convert_by_vocab</span>(<span class="params">vocab, items</span>):</span><br><span class="line">    <span class="string">&quot;&quot;&quot;Converts a sequence of [tokens|ids] using the vocab.&quot;&quot;&quot;</span></span><br><span class="line">    output = []</span><br><span class="line">    <span class="keyword">for</span> item <span class="keyword">in</span> items:</span><br><span class="line">        output.append(vocab[item])</span><br><span class="line">    <span class="keyword">return</span> output</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">convert_tokens_to_ids</span>(<span class="params">vocab, tokens</span>):</span><br><span class="line">    <span class="keyword">return</span> convert_by_vocab(vocab, tokens)</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">convert_ids_to_tokens</span>(<span class="params">inv_vocab, ids</span>):</span><br><span class="line">    <span class="keyword">return</span> convert_by_vocab(inv_vocab, ids)</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">whitespace_tokenize</span>(<span class="params">text</span>):</span><br><span class="line">    <span class="string">&quot;&quot;&quot;Runs basic whitespace cleaning and splitting on a piece of text.&quot;&quot;&quot;</span></span><br><span class="line">    text = text.strip()</span><br><span class="line">    <span class="keyword">if</span> <span class="keyword">not</span> text:</span><br><span class="line">        <span class="keyword">return</span> []</span><br><span class="line">    tokens = text.split()</span><br><span class="line">    <span class="keyword">return</span> tokens</span><br><span class="line"></span><br><span class="line"><span class="keyword">class</span> <span class="title class_">FullTokenizer</span>(<span class="title class_ inherited__">object</span>):</span><br><span class="line">    <span class="string">&quot;&quot;&quot;Runs end-to-end tokenziation.&quot;&quot;&quot;</span></span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">__init__</span>(<span class="params">self, vocab_file, do_lower_case=<span class="literal">True</span></span>):</span><br><span class="line">        self.vocab = load_vocab(vocab_file)</span><br><span class="line">        self.inv_vocab = &#123;v: k <span class="keyword">for</span> k, v <span class="keyword">in</span> self.vocab.items()&#125;</span><br><span class="line">        self.basic_tokenizer = BasicTokenizer(do_lower_case=do_lower_case)</span><br><span class="line">        self.wordpiece_tokenizer = WordpieceTokenizer(vocab=self.vocab)</span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">tokenize</span>(<span class="params">self, text</span>):</span><br><span class="line">        split_tokens = []</span><br><span class="line">        logger.debug(<span class="string">&quot;text is: &#123;:s&#125;&quot;</span>.<span class="built_in">format</span>(text))</span><br><span class="line">        basic_tokenizers = self.basic_tokenizer.tokenize(text)</span><br><span class="line">        logger.debug(<span class="string">&quot;basic_tokenizers is &#123;&#125;&quot;</span>.<span class="built_in">format</span>(basic_tokenizers))</span><br><span class="line">        <span class="keyword">for</span> token <span class="keyword">in</span> basic_tokenizers:</span><br><span class="line">            logger.debug(<span class="string">&quot;BasicTokenizer output: &#123;:s&#125;&quot;</span>.<span class="built_in">format</span>(token))</span><br><span class="line">            <span class="keyword">for</span> sub_token <span class="keyword">in</span> self.wordpiece_tokenizer.tokenize(token):</span><br><span class="line">                split_tokens.append(sub_token)</span><br><span class="line">        logger.debug(<span class="string">&quot;Splits token is &#123;&#125;&quot;</span>.<span class="built_in">format</span>(split_tokens))</span><br><span class="line">        <span class="keyword">return</span> split_tokens</span><br><span class="line">    </span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">tokenize_unicoder</span>(<span class="params">self, text</span>):</span><br><span class="line">        <span class="string">&quot;&quot;&quot;</span></span><br><span class="line"><span class="string">        [summary]</span></span><br><span class="line"><span class="string">            just token the textual part, do not change the rest</span></span><br><span class="line"><span class="string">        Arguments:</span></span><br><span class="line"><span class="string">            text &#123;[string]&#125; -- [&quot;id\tdet1\tdet2\ttext&quot;]</span></span><br><span class="line"><span class="string"></span></span><br><span class="line"><span class="string">        Returns:</span></span><br><span class="line"><span class="string">            details [list] -- [id,det1,det2,token1,token2,token3,token4...]</span></span><br><span class="line"><span class="string">        &quot;&quot;&quot;</span></span><br><span class="line">        <span class="keyword">try</span>:</span><br><span class="line">            <span class="keyword">if</span> <span class="built_in">isinstance</span>(text,<span class="built_in">str</span>):</span><br><span class="line">                split_text = text.strip().split(<span class="string">&quot;\t&quot;</span>)</span><br><span class="line">            <span class="keyword">else</span>:</span><br><span class="line">                split_text = text</span><br><span class="line">            logger.info(<span class="string">&quot;split text &#123;&#125;&quot;</span>.<span class="built_in">format</span>(split_text))</span><br><span class="line">            image_id, image_url, title_text = split_text</span><br><span class="line">            <span class="keyword">if</span> <span class="keyword">not</span> AbaseClient.exists(Params.abase_image_text_relevance_data.<span class="built_in">format</span>(image_id)):</span><br><span class="line">                logger.error(<span class="string">&quot;&#123;&#125; do not exist in abase&quot;</span>.<span class="built_in">format</span>(image_id))</span><br><span class="line">                <span class="keyword">return</span> []</span><br><span class="line">            split_tokens = [image_id,image_url]</span><br><span class="line">            <span class="keyword">for</span> token <span class="keyword">in</span> self.basic_tokenizer.tokenize(title_text):</span><br><span class="line">                logger.debug(<span class="string">&quot;tokenize_unicoder: BasicTokenizer output is --&gt; &#123;&#125;&quot;</span>.<span class="built_in">format</span>(token))</span><br><span class="line">                <span class="keyword">for</span> sub_token <span class="keyword">in</span> self.wordpiece_tokenizer.tokenize(token):</span><br><span class="line">                    split_tokens.append(sub_token)</span><br><span class="line">            <span class="keyword">return</span> split_tokens</span><br><span class="line">        <span class="keyword">except</span>:</span><br><span class="line">            logger.error(traceback.format_exc())</span><br><span class="line">            <span class="keyword">return</span> []</span><br><span class="line">    </span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">convert_tokens_to_ids</span>(<span class="params">self, tokens</span>):</span><br><span class="line">        <span class="keyword">return</span> convert_by_vocab(self.vocab, tokens)</span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">convert_ids_to_tokens</span>(<span class="params">self, ids</span>):</span><br><span class="line">        <span class="keyword">return</span> convert_by_vocab(self.inv_vocab, ids)</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">class</span> <span class="title class_">BasicTokenizer</span>(<span class="title class_ inherited__">object</span>):</span><br><span class="line">    <span class="string">&quot;&quot;&quot;Runs basic tokenization (punctuation splitting, lower casing, etc.).&quot;&quot;&quot;</span></span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">__init__</span>(<span class="params">self, do_lower_case=<span class="literal">True</span></span>):</span><br><span class="line">        <span class="string">&quot;&quot;&quot;Constructs a BasicTokenizer.</span></span><br><span class="line"><span class="string"></span></span><br><span class="line"><span class="string">        Args:</span></span><br><span class="line"><span class="string">          do_lower_case: Whether to lower case the input.</span></span><br><span class="line"><span class="string">        &quot;&quot;&quot;</span></span><br><span class="line">        self.do_lower_case = do_lower_case</span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">tokenize</span>(<span class="params">self, text</span>):</span><br><span class="line">        <span class="string">&quot;&quot;&quot;Tokenizes a piece of text.&quot;&quot;&quot;</span></span><br><span class="line">        text = convert_to_unicode(text)</span><br><span class="line">        text = self._clean_text(text)</span><br><span class="line"></span><br><span class="line">        <span class="comment"># This was added on November 1st, 2018 for the multilingual and Chinese</span></span><br><span class="line">        <span class="comment"># models. This is also applied to the English models now, but it doesn&#x27;t</span></span><br><span class="line">        <span class="comment"># matter since the English models were not trained on any Chinese data</span></span><br><span class="line">        <span class="comment"># and generally don&#x27;t have any Chinese data in them (there are Chinese</span></span><br><span class="line">        <span class="comment"># characters in the vocabulary because Wikipedia does have some Chinese</span></span><br><span class="line">        <span class="comment"># words in the English Wikipedia.).</span></span><br><span class="line">        text = self._tokenize_chinese_chars(text)</span><br><span class="line"></span><br><span class="line">        orig_tokens = whitespace_tokenize(text)</span><br><span class="line">        split_tokens = []</span><br><span class="line">        <span class="keyword">for</span> token <span class="keyword">in</span> orig_tokens:</span><br><span class="line">            <span class="keyword">if</span> self.do_lower_case:</span><br><span class="line">                token = token.lower()</span><br><span class="line">                token = self._run_strip_accents(token)</span><br><span class="line">            split_tokens.extend(self._run_split_on_punc(token))</span><br><span class="line"></span><br><span class="line">        output_tokens = whitespace_tokenize(<span class="string">&quot; &quot;</span>.join(split_tokens))</span><br><span class="line">        <span class="keyword">return</span> output_tokens</span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">_run_strip_accents</span>(<span class="params">self, text</span>):</span><br><span class="line">        <span class="string">&quot;&quot;&quot;Strips accents from a piece of text.&quot;&quot;&quot;</span></span><br><span class="line">        text = unicodedata.normalize(<span class="string">&quot;NFD&quot;</span>, text)</span><br><span class="line">        output = []</span><br><span class="line">        <span class="keyword">for</span> char <span class="keyword">in</span> text:</span><br><span class="line">            cat = unicodedata.category(char)</span><br><span class="line">            <span class="keyword">if</span> cat == <span class="string">&quot;Mn&quot;</span>:</span><br><span class="line">                <span class="keyword">continue</span></span><br><span class="line">            output.append(char)</span><br><span class="line">        <span class="keyword">return</span> <span class="string">&quot;&quot;</span>.join(output)</span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">_run_split_on_punc</span>(<span class="params">self, text</span>):</span><br><span class="line">        <span class="string">&quot;&quot;&quot;Splits punctuation on a piece of text.&quot;&quot;&quot;</span></span><br><span class="line">        chars = <span class="built_in">list</span>(text)</span><br><span class="line">        i = <span class="number">0</span></span><br><span class="line">        start_new_word = <span class="literal">True</span></span><br><span class="line">        output = []</span><br><span class="line">        <span class="keyword">while</span> i &lt; <span class="built_in">len</span>(chars):</span><br><span class="line">            char = chars[i]</span><br><span class="line">            <span class="keyword">if</span> _is_punctuation(char):</span><br><span class="line">                output.append([char])</span><br><span class="line">                start_new_word = <span class="literal">True</span></span><br><span class="line">            <span class="keyword">else</span>:</span><br><span class="line">                <span class="keyword">if</span> start_new_word:</span><br><span class="line">                    output.append([])</span><br><span class="line">                start_new_word = <span class="literal">False</span></span><br><span class="line">                output[-<span class="number">1</span>].append(char)</span><br><span class="line">            i += <span class="number">1</span></span><br><span class="line"></span><br><span class="line">        <span class="keyword">return</span> [<span class="string">&quot;&quot;</span>.join(x) <span class="keyword">for</span> x <span class="keyword">in</span> output]</span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">_tokenize_chinese_chars</span>(<span class="params">self, text</span>):</span><br><span class="line">        <span class="string">&quot;&quot;&quot;Adds whitespace around any CJK character.&quot;&quot;&quot;</span></span><br><span class="line">        output = []</span><br><span class="line">        <span class="keyword">for</span> char <span class="keyword">in</span> text:</span><br><span class="line">            cp = <span class="built_in">ord</span>(char)</span><br><span class="line">            <span class="keyword">if</span> self._is_chinese_char(cp):</span><br><span class="line">                output.append(<span class="string">&quot; &quot;</span>)</span><br><span class="line">                output.append(char)</span><br><span class="line">                output.append(<span class="string">&quot; &quot;</span>)</span><br><span class="line">            <span class="keyword">else</span>:</span><br><span class="line">                output.append(char)</span><br><span class="line">        <span class="keyword">return</span> <span class="string">&quot;&quot;</span>.join(output)</span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">_is_chinese_char</span>(<span class="params">self, cp</span>):</span><br><span class="line">        <span class="string">&quot;&quot;&quot;Checks whether CP is the codepoint of a CJK character.&quot;&quot;&quot;</span></span><br><span class="line">        <span class="comment"># This defines a &quot;chinese character&quot; as anything in the CJK Unicode block:</span></span><br><span class="line">        <span class="comment">#   https://en.wikipedia.org/wiki/CJK_Unified_Ideographs_(Unicode_block)</span></span><br><span class="line">        <span class="comment">#</span></span><br><span class="line">        <span class="comment"># Note that the CJK Unicode block is NOT all Japanese and Korean characters,</span></span><br><span class="line">        <span class="comment"># despite its name. The modern Korean Hangul alphabet is a different block,</span></span><br><span class="line">        <span class="comment"># as is Japanese Hiragana and Katakana. Those alphabets are used to write</span></span><br><span class="line">        <span class="comment"># space-separated words, so they are not treated specially and handled</span></span><br><span class="line">        <span class="comment"># like the all of the other languages.</span></span><br><span class="line">        <span class="keyword">if</span> ((cp &gt;= <span class="number">0x4E00</span> <span class="keyword">and</span> cp &lt;= <span class="number">0x9FFF</span>) <span class="keyword">or</span>  <span class="comment">#</span></span><br><span class="line">            (cp &gt;= <span class="number">0x3400</span> <span class="keyword">and</span> cp &lt;= <span class="number">0x4DBF</span>) <span class="keyword">or</span>  <span class="comment">#</span></span><br><span class="line">            (cp &gt;= <span class="number">0x20000</span> <span class="keyword">and</span> cp &lt;= <span class="number">0x2A6DF</span>) <span class="keyword">or</span>  <span class="comment">#</span></span><br><span class="line">            (cp &gt;= <span class="number">0x2A700</span> <span class="keyword">and</span> cp &lt;= <span class="number">0x2B73F</span>) <span class="keyword">or</span>  <span class="comment">#</span></span><br><span class="line">            (cp &gt;= <span class="number">0x2B740</span> <span class="keyword">and</span> cp &lt;= <span class="number">0x2B81F</span>) <span class="keyword">or</span>  <span class="comment">#</span></span><br><span class="line">            (cp &gt;= <span class="number">0x2B820</span> <span class="keyword">and</span> cp &lt;= <span class="number">0x2CEAF</span>) <span class="keyword">or</span></span><br><span class="line">            (cp &gt;= <span class="number">0xF900</span> <span class="keyword">and</span> cp &lt;= <span class="number">0xFAFF</span>) <span class="keyword">or</span>  <span class="comment">#</span></span><br><span class="line">                (cp &gt;= <span class="number">0x2F800</span> <span class="keyword">and</span> cp &lt;= <span class="number">0x2FA1F</span>)):  <span class="comment">#</span></span><br><span class="line">            <span class="keyword">return</span> <span class="literal">True</span></span><br><span class="line"></span><br><span class="line">        <span class="keyword">return</span> <span class="literal">False</span></span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">_clean_text</span>(<span class="params">self, text</span>):</span><br><span class="line">        <span class="string">&quot;&quot;&quot;Performs invalid character removal and whitespace cleanup on text.&quot;&quot;&quot;</span></span><br><span class="line">        output = []</span><br><span class="line">        <span class="keyword">for</span> char <span class="keyword">in</span> text:</span><br><span class="line">            cp = <span class="built_in">ord</span>(char)</span><br><span class="line">            <span class="keyword">if</span> cp == <span class="number">0</span> <span class="keyword">or</span> cp == <span class="number">0xfffd</span> <span class="keyword">or</span> _is_control(char):</span><br><span class="line">                <span class="keyword">continue</span></span><br><span class="line">            <span class="keyword">if</span> _is_whitespace(char):</span><br><span class="line">                output.append(<span class="string">&quot; &quot;</span>)</span><br><span class="line">            <span class="keyword">else</span>:</span><br><span class="line">                output.append(char)</span><br><span class="line">        <span class="keyword">return</span> <span class="string">&quot;&quot;</span>.join(output)</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">class</span> <span class="title class_">WordpieceTokenizer</span>(<span class="title class_ inherited__">object</span>):</span><br><span class="line">    <span class="string">&quot;&quot;&quot;Runs WordPiece tokenziation.&quot;&quot;&quot;</span></span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">__init__</span>(<span class="params">self, vocab, unk_token=<span class="string">&quot;[UNK]&quot;</span>, max_input_chars_per_word=<span class="number">200</span></span>):</span><br><span class="line">        self.vocab = vocab</span><br><span class="line">        self.unk_token = unk_token</span><br><span class="line">        self.max_input_chars_per_word = max_input_chars_per_word</span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">tokenize</span>(<span class="params">self, text</span>):</span><br><span class="line">        <span class="string">&quot;&quot;&quot;Tokenizes a piece of text into its word pieces.</span></span><br><span class="line"><span class="string"></span></span><br><span class="line"><span class="string">        This uses a greedy longest-match-first algorithm to perform tokenization</span></span><br><span class="line"><span class="string">        using the given vocabulary.</span></span><br><span class="line"><span class="string"></span></span><br><span class="line"><span class="string">        For example:</span></span><br><span class="line"><span class="string">          input = &quot;unaffable&quot;</span></span><br><span class="line"><span class="string">          output = [&quot;un&quot;, &quot;##aff&quot;, &quot;##able&quot;]</span></span><br><span class="line"><span class="string"></span></span><br><span class="line"><span class="string">        Args:</span></span><br><span class="line"><span class="string">          text: A single token or whitespace separated tokens. This should have</span></span><br><span class="line"><span class="string">            already been passed through `BasicTokenizer.</span></span><br><span class="line"><span class="string"></span></span><br><span class="line"><span class="string">        Returns:</span></span><br><span class="line"><span class="string">          A list of wordpiece tokens.</span></span><br><span class="line"><span class="string">        &quot;&quot;&quot;</span></span><br><span class="line"></span><br><span class="line">        text = convert_to_unicode(text)</span><br><span class="line"></span><br><span class="line">        output_tokens = []</span><br><span class="line">        <span class="keyword">for</span> token <span class="keyword">in</span> whitespace_tokenize(text):</span><br><span class="line">            chars = <span class="built_in">list</span>(token)</span><br><span class="line">            <span class="keyword">if</span> <span class="built_in">len</span>(chars) &gt; self.max_input_chars_per_word:</span><br><span class="line">                output_tokens.append(self.unk_token)</span><br><span class="line">                <span class="keyword">continue</span></span><br><span class="line"></span><br><span class="line">            is_bad = <span class="literal">False</span></span><br><span class="line">            start = <span class="number">0</span></span><br><span class="line">            sub_tokens = []</span><br><span class="line">            <span class="keyword">while</span> start &lt; <span class="built_in">len</span>(chars):</span><br><span class="line">                end = <span class="built_in">len</span>(chars)</span><br><span class="line">                cur_substr = <span class="literal">None</span></span><br><span class="line">                <span class="keyword">while</span> start &lt; end:</span><br><span class="line">                    substr = <span class="string">&quot;&quot;</span>.join(chars[start:end])</span><br><span class="line">                    <span class="keyword">if</span> start &gt; <span class="number">0</span>:</span><br><span class="line">                        substr = <span class="string">&quot;##&quot;</span> + substr</span><br><span class="line">                    <span class="keyword">if</span> substr <span class="keyword">in</span> self.vocab:</span><br><span class="line">                        cur_substr = substr</span><br><span class="line">                        <span class="keyword">break</span></span><br><span class="line">                    end -= <span class="number">1</span></span><br><span class="line">                <span class="keyword">if</span> cur_substr <span class="keyword">is</span> <span class="literal">None</span>:</span><br><span class="line">                    is_bad = <span class="literal">True</span></span><br><span class="line">                    <span class="keyword">break</span></span><br><span class="line">                sub_tokens.append(cur_substr)</span><br><span class="line">                start = end</span><br><span class="line"></span><br><span class="line">            <span class="keyword">if</span> is_bad:</span><br><span class="line">                output_tokens.append(self.unk_token)</span><br><span class="line">            <span class="keyword">else</span>:</span><br><span class="line">                output_tokens.extend(sub_tokens)</span><br><span class="line">        <span class="keyword">return</span> output_tokens</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">_is_whitespace</span>(<span class="params">char</span>):</span><br><span class="line">    <span class="string">&quot;&quot;&quot;Checks whether `chars` is a whitespace character.&quot;&quot;&quot;</span></span><br><span class="line">    <span class="comment"># \t, \n, and \r are technically contorl characters but we treat them</span></span><br><span class="line">    <span class="comment"># as whitespace since they are generally considered as such.</span></span><br><span class="line">    <span class="keyword">if</span> char == <span class="string">&quot; &quot;</span> <span class="keyword">or</span> char == <span class="string">&quot;\t&quot;</span> <span class="keyword">or</span> char == <span class="string">&quot;\n&quot;</span> <span class="keyword">or</span> char == <span class="string">&quot;\r&quot;</span>:</span><br><span class="line">        <span class="keyword">return</span> <span class="literal">True</span></span><br><span class="line">    cat = unicodedata.category(char)</span><br><span class="line">    <span class="keyword">if</span> cat == <span class="string">&quot;Zs&quot;</span>:</span><br><span class="line">        <span class="keyword">return</span> <span class="literal">True</span></span><br><span class="line">    <span class="keyword">return</span> <span class="literal">False</span></span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">_is_control</span>(<span class="params">char</span>):</span><br><span class="line">    <span class="string">&quot;&quot;&quot;Checks whether `chars` is a control character.&quot;&quot;&quot;</span></span><br><span class="line">    <span class="comment"># These are technically control characters but we count them as whitespace</span></span><br><span class="line">    <span class="comment"># characters.</span></span><br><span class="line">    <span class="keyword">if</span> char == <span class="string">&quot;\t&quot;</span> <span class="keyword">or</span> char == <span class="string">&quot;\n&quot;</span> <span class="keyword">or</span> char == <span class="string">&quot;\r&quot;</span>:</span><br><span class="line">        <span class="keyword">return</span> <span class="literal">False</span></span><br><span class="line">    cat = unicodedata.category(char)</span><br><span class="line">    <span class="keyword">if</span> cat <span class="keyword">in</span> (<span class="string">&quot;Cc&quot;</span>, <span class="string">&quot;Cf&quot;</span>):</span><br><span class="line">        <span class="keyword">return</span> <span class="literal">True</span></span><br><span class="line">    <span class="keyword">return</span> <span class="literal">False</span></span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">_is_punctuation</span>(<span class="params">char</span>):</span><br><span class="line">    <span class="string">&quot;&quot;&quot;Checks whether `chars` is a punctuation character.&quot;&quot;&quot;</span></span><br><span class="line">    cp = <span class="built_in">ord</span>(char)</span><br><span class="line">    <span class="comment"># We treat all non-letter/number ASCII as punctuation.</span></span><br><span class="line">    <span class="comment"># Characters such as &quot;^&quot;, &quot;$&quot;, and &quot;`&quot; are not in the Unicode</span></span><br><span class="line">    <span class="comment"># Punctuation class but we treat them as punctuation anyways, for</span></span><br><span class="line">    <span class="comment"># consistency.</span></span><br><span class="line">    <span class="keyword">if</span> ((cp &gt;= <span class="number">33</span> <span class="keyword">and</span> cp &lt;= <span class="number">47</span>) <span class="keyword">or</span> (cp &gt;= <span class="number">58</span> <span class="keyword">and</span> cp &lt;= <span class="number">64</span>) <span class="keyword">or</span></span><br><span class="line">            (cp &gt;= <span class="number">91</span> <span class="keyword">and</span> cp &lt;= <span class="number">96</span>) <span class="keyword">or</span> (cp &gt;= <span class="number">123</span> <span class="keyword">and</span> cp &lt;= <span class="number">126</span>)):</span><br><span class="line">        <span class="keyword">return</span> <span class="literal">True</span></span><br><span class="line">    cat = unicodedata.category(char)</span><br><span class="line">    <span class="keyword">if</span> cat.startswith(<span class="string">&quot;P&quot;</span>):</span><br><span class="line">        <span class="keyword">return</span> <span class="literal">True</span></span><br><span class="line">    <span class="keyword">return</span> <span class="literal">False</span></span><br><span class="line"> </span><br><span class="line"><span class="keyword">if</span> __name__ == <span class="string">&quot;__main__&quot;</span>:</span><br><span class="line">  <span class="comment"># give the params: vocab file</span></span><br><span class="line">    tk = FullTokenizer(</span><br><span class="line">        <span class="string">&quot;config/vocab.txt&quot;</span>)</span><br><span class="line">    text = <span class="string">&quot;10009090090 熊猫烧香&quot;</span></span><br><span class="line">    tokens = tk.tokenize(text)</span><br><span class="line">    logger.info(<span class="string">&quot;tokens: &#123;&#125;&quot;</span>.<span class="built_in">format</span>(tokens))</span><br><span class="line">    ids = tk.convert_tokens_to_ids(tokens)</span><br><span class="line">    logger.info(<span class="string">&quot;ids: &#123;&#125;&quot;</span>.<span class="built_in">format</span>(ids))</span><br></pre></td></tr></table></figure><p>执行上述命令，可以得到</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">tokens: [u<span class="string">&#x27;1000&#x27;</span>, u<span class="string">&#x27;##90&#x27;</span>, u<span class="string">&#x27;##900&#x27;</span>, u<span class="string">&#x27;##90&#x27;</span>, u<span class="string">&#x27;\u718a&#x27;</span>, u<span class="string">&#x27;\u732b&#x27;</span>, u<span class="string">&#x27;\u70e7&#x27;</span>, u<span class="string">&#x27;\u9999&#x27;</span>]</span><br><span class="line">ids: [8212, 8599, 10589, 8599, 4220, 4344, 4173, 7676]</span><br></pre></td></tr></table></figure><p>可以看到对于中文进行wordpiece分词之后得到的是单个字，对于字符串分词之后得到的是多个字符串，在结果中<code>u&#39;##90&#39;, u&#39;##900&#39;, u&#39;##90&#39;</code> 可以看成这几个分割之后的属于一个此种的几个字，例如原词是“中国”，分词之后是‘##中’，‘##国’</p><h4 id="PositionEmbedding"><a href="#PositionEmbedding" class="headerlink" title="PositionEmbedding"></a>PositionEmbedding</h4><p>位置嵌入是指将单词的位置信息编码成特征向量，位置嵌入是向模型中引入单词位置关系的至关重要的一环。这里和<code>transformer</code>不同，在<code>transformer</code>中使用的是三角函数，在<code>Bert</code>中<code>position</code>是待学习参数，在Bert的参数定义文件中一开始设置最长的输入序列长度，这样就确定了输入的序列的最的位置的最大值和最小值，如此将token所在的位置按照词向量的方式生成<code>PositionEmbedding</code>。</p><h4 id="TokenType"><a href="#TokenType" class="headerlink" title="TokenType"></a>TokenType</h4><p>词的类别，这个很好理解，在<code>Bert</code>中输入的是大于等于两个句子，那么我们就规定分次之后的<code>token</code>归属于第一个句子那么其<code>tokentype</code>是<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>0</mn></mrow></semantics></math></span></span>，如果归属于第二个句子那么<code>tokentype</code>是<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>1</mn></mrow></semantics></math></span></span>。 下面是对输入<code>sequence</code>转化为<code>WordEmbedxidgs</code>之后进行后处理的代码，链接为 <a href="https://github.com/google-research/bert/blob/master/modeling.py#L428">https://github.com/google-research/bert/blob/master/modeling.py#L428</a></p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br><span class="line">51</span><br><span class="line">52</span><br><span class="line">53</span><br><span class="line">54</span><br><span class="line">55</span><br><span class="line">56</span><br><span class="line">57</span><br><span class="line">58</span><br><span class="line">59</span><br><span class="line">60</span><br><span class="line">61</span><br><span class="line">62</span><br><span class="line">63</span><br><span class="line">64</span><br><span class="line">65</span><br><span class="line">66</span><br><span class="line">67</span><br><span class="line">68</span><br><span class="line">69</span><br><span class="line">70</span><br><span class="line">71</span><br><span class="line">72</span><br><span class="line">73</span><br><span class="line">74</span><br><span class="line">75</span><br><span class="line">76</span><br><span class="line">77</span><br><span class="line">78</span><br><span class="line">79</span><br><span class="line">80</span><br><span class="line">81</span><br><span class="line">82</span><br><span class="line">83</span><br><span class="line">84</span><br><span class="line">85</span><br><span class="line">86</span><br><span class="line">87</span><br><span class="line">88</span><br><span class="line">89</span><br><span class="line">90</span><br><span class="line">91</span><br><span class="line">92</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">def</span> <span class="title function_">embedding_postprocessor</span>(<span class="params">input_tensor,</span></span><br><span class="line"><span class="params">                            use_token_type=<span class="literal">False</span>,</span></span><br><span class="line"><span class="params">                            token_type_ids=<span class="literal">None</span>,</span></span><br><span class="line"><span class="params">                            token_type_vocab_size=<span class="number">16</span>,</span></span><br><span class="line"><span class="params">                            token_type_embedding_name=<span class="string">&quot;token_type_embeddings&quot;</span>,</span></span><br><span class="line"><span class="params">                            use_position_embeddings=<span class="literal">True</span>,</span></span><br><span class="line"><span class="params">                            position_embedding_name=<span class="string">&quot;position_embeddings&quot;</span>,</span></span><br><span class="line"><span class="params">                            initializer_range=<span class="number">0.02</span>,</span></span><br><span class="line"><span class="params">                            max_position_embeddings=<span class="number">512</span>,</span></span><br><span class="line"><span class="params">                            dropout_prob=<span class="number">0.1</span></span>):</span><br><span class="line">  <span class="string">&quot;&quot;&quot;Performs various post-processing on a word embedding tensor.</span></span><br><span class="line"><span class="string">  Args:</span></span><br><span class="line"><span class="string">    input_tensor: float Tensor of shape [batch_size, seq_length,</span></span><br><span class="line"><span class="string">      embedding_size].</span></span><br><span class="line"><span class="string">    use_token_type: bool. Whether to add embeddings for `token_type_ids`.</span></span><br><span class="line"><span class="string">    token_type_ids: (optional) int32 Tensor of shape [batch_size, seq_length].</span></span><br><span class="line"><span class="string">      Must be specified if `use_token_type` is True.</span></span><br><span class="line"><span class="string">    token_type_vocab_size: int. The vocabulary size of `token_type_ids`.</span></span><br><span class="line"><span class="string">    token_type_embedding_name: string. The name of the embedding table variable</span></span><br><span class="line"><span class="string">      for token type ids.</span></span><br><span class="line"><span class="string">    use_position_embeddings: bool. Whether to add position embeddings for the</span></span><br><span class="line"><span class="string">      position of each token in the sequence.</span></span><br><span class="line"><span class="string">    position_embedding_name: string. The name of the embedding table variable</span></span><br><span class="line"><span class="string">      for positional embeddings.</span></span><br><span class="line"><span class="string">    initializer_range: float. Range of the weight initialization.</span></span><br><span class="line"><span class="string">    max_position_embeddings: int. Maximum sequence length that might ever be</span></span><br><span class="line"><span class="string">      used with this model. This can be longer than the sequence length of</span></span><br><span class="line"><span class="string">      input_tensor, but cannot be shorter.</span></span><br><span class="line"><span class="string">    dropout_prob: float. Dropout probability applied to the final output tensor.</span></span><br><span class="line"><span class="string">  Returns:</span></span><br><span class="line"><span class="string">    float tensor with same shape as `input_tensor`.</span></span><br><span class="line"><span class="string">  Raises:</span></span><br><span class="line"><span class="string">    ValueError: One of the tensor shapes or input values is invalid.</span></span><br><span class="line"><span class="string">  &quot;&quot;&quot;</span></span><br><span class="line">  <span class="comment"># shape is [batch,sequence_length,embeding_dims]</span></span><br><span class="line">  input_shape = get_shape_list(input_tensor, expected_rank=<span class="number">3</span>)</span><br><span class="line">  batch_size = input_shape[<span class="number">0</span>]</span><br><span class="line">  seq_length = input_shape[<span class="number">1</span>]</span><br><span class="line">  width = input_shape[<span class="number">2</span>]</span><br><span class="line"></span><br><span class="line">  output = input_tensor</span><br><span class="line"></span><br><span class="line">  <span class="keyword">if</span> use_token_type:</span><br><span class="line">    <span class="keyword">if</span> token_type_ids <span class="keyword">is</span> <span class="literal">None</span>:</span><br><span class="line">      <span class="keyword">raise</span> ValueError(<span class="string">&quot;`token_type_ids` must be specified if&quot;</span></span><br><span class="line">                       <span class="string">&quot;`use_token_type` is True.&quot;</span>)</span><br><span class="line">    token_type_table = tf.get_variable(</span><br><span class="line">        name=token_type_embedding_name,</span><br><span class="line">        shape=[token_type_vocab_size, width],</span><br><span class="line">        initializer=create_initializer(initializer_range))</span><br><span class="line">    <span class="comment"># This vocab will be small so we always do one-hot here, since it is always</span></span><br><span class="line">    <span class="comment"># faster for a small vocabulary.</span></span><br><span class="line">    flat_token_type_ids = tf.reshape(token_type_ids, [-<span class="number">1</span>])</span><br><span class="line">    one_hot_ids = tf.one_hot(flat_token_type_ids, depth=token_type_vocab_size)</span><br><span class="line">    token_type_embeddings = tf.matmul(one_hot_ids, token_type_table)</span><br><span class="line">    token_type_embeddings = tf.reshape(token_type_embeddings,</span><br><span class="line">                                       [batch_size, seq_length, width])</span><br><span class="line">    output += token_type_embeddings</span><br><span class="line"></span><br><span class="line">  <span class="keyword">if</span> use_position_embeddings:</span><br><span class="line">    assert_op = tf.assert_less_equal(seq_length, max_position_embeddings)</span><br><span class="line">    <span class="keyword">with</span> tf.control_dependencies([assert_op]):</span><br><span class="line">      full_position_embeddings = tf.get_variable(</span><br><span class="line">          name=position_embedding_name,</span><br><span class="line">          shape=[max_position_embeddings, width],</span><br><span class="line">          initializer=create_initializer(initializer_range))</span><br><span class="line">      <span class="comment"># Since the position embedding table is a learned variable, we create it</span></span><br><span class="line">      <span class="comment"># using a (long) sequence length `max_position_embeddings`. The actual</span></span><br><span class="line">      <span class="comment"># sequence length might be shorter than this, for faster training of</span></span><br><span class="line">      <span class="comment"># tasks that do not have long sequences.</span></span><br><span class="line">      <span class="comment">#</span></span><br><span class="line">      <span class="comment"># So `full_position_embeddings` is effectively an embedding table</span></span><br><span class="line">      <span class="comment"># for position [0, 1, 2, ..., max_position_embeddings-1], and the current</span></span><br><span class="line">      <span class="comment"># sequence has positions [0, 1, 2, ... seq_length-1], so we can just</span></span><br><span class="line">      <span class="comment"># perform a slice.</span></span><br><span class="line">      position_embeddings = tf.<span class="built_in">slice</span>(full_position_embeddings, [<span class="number">0</span>, <span class="number">0</span>],</span><br><span class="line">                                     [seq_length, -<span class="number">1</span>])</span><br><span class="line">      num_dims = <span class="built_in">len</span>(output.shape.as_list())</span><br><span class="line"></span><br><span class="line">      <span class="comment"># Only the last two dimensions are relevant (`seq_length` and `width`), so</span></span><br><span class="line">      <span class="comment"># we broadcast among the first dimensions, which is typically just</span></span><br><span class="line">      <span class="comment"># the batch size.</span></span><br><span class="line">      position_broadcast_shape = []</span><br><span class="line">      <span class="keyword">for</span> _ <span class="keyword">in</span> <span class="built_in">range</span>(num_dims - <span class="number">2</span>):</span><br><span class="line">        position_broadcast_shape.append(<span class="number">1</span>)</span><br><span class="line">      position_broadcast_shape.extend([seq_length, width])</span><br><span class="line">      position_embeddings = tf.reshape(position_embeddings,</span><br><span class="line">                                       position_broadcast_shape)</span><br><span class="line">      output += position_embeddings</span><br><span class="line"></span><br><span class="line">  output = layer_norm_and_dropout(output, dropout_prob)</span><br><span class="line">  <span class="keyword">return</span> output</span><br></pre></td></tr></table></figure><p>通过代码很容易看出来，在<code>BERT</code>中对于<code>tokentype</code>和<code>position</code>都是学习参数化。</p><p>就像上面代码所述</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br></pre></td><td class="code"><pre><span class="line"><span class="string">&quot;&quot;&quot;</span></span><br><span class="line"><span class="string">Input</span></span><br><span class="line"><span class="string">&quot;&quot;&quot;</span></span><br><span class="line">output = input_tensor</span><br><span class="line"><span class="string">&quot;&quot;&quot;</span></span><br><span class="line"><span class="string">process token type</span></span><br><span class="line"><span class="string">&quot;&quot;&quot;</span></span><br><span class="line">output += token_type_embeddings</span><br><span class="line"><span class="string">&quot;&quot;&quot;</span></span><br><span class="line"><span class="string">process position</span></span><br><span class="line"><span class="string">&quot;&quot;&quot;</span></span><br><span class="line">output += position_embeddings</span><br><span class="line"><span class="string">&quot;&quot;&quot;</span></span><br><span class="line"><span class="string">LN and dropout</span></span><br><span class="line"><span class="string">&quot;&quot;&quot;</span></span><br><span class="line">output = layer_norm_and_dropout(output, dropout_prob)</span><br></pre></td></tr></table></figure><p>将各个部分的<code>embedding</code>叠加在一起然后经过<code>LN</code>和<code>dropout</code>，就得到了进入<code>transformer</code>之前输入特征。</p><h3 id="数据特点"><a href="#数据特点" class="headerlink" title="数据特点"></a>数据特点</h3><p><code>BERT</code>是一个基础特征提取模型，主要学习的是词向量，具体到我们的下游任务，需要在<code>BERT</code>的基础上继续训练才可以。</p><h4 id="自然语料训练"><a href="#自然语料训练" class="headerlink" title="自然语料训练"></a>自然语料训练</h4><p>目的：学习模型的通用表达能力</p><p>语料：最好是<strong>document-level</strong>的，比如百科答，wiki，新闻等通用预料，如此能够保证预训练阶段得到的网络权重足够鲁棒以适应后续的特定领域的下游任务。</p><h4 id="下游任务训练"><a href="#下游任务训练" class="headerlink" title="下游任务训练"></a>下游任务训练</h4><p>目的：学习特定的模型表达能力，比如相关性，问答等子任务</p><p>语料：特定任务的标定数据，比如要学习<code>query</code>和<code>recall</code>的相关性，那么就要准备相应的数据进行训练。</p><h2 id="基于BERT的应用"><a href="#基于BERT的应用" class="headerlink" title="基于BERT的应用"></a>基于BERT的应用</h2><p>既然BERT这么好用，那么是否能在其他领域也借鉴使用呢，不止我这么想，很多大牛已经尝试过了，由此催生出了videoBert，ELECTRA，uniter，uncoder等这些基于BERT的相关研究。</p><h3 id="图文BERT"><a href="#图文BERT" class="headerlink" title="图文BERT"></a>图文BERT</h3><p>本人目前在做图片搜索相关工作，复现了uniter这篇论文的代码，由于工作原因，目前代码无法开源，实际上这部分还是很简单的，基于google-bert的代码，加入图片visual部分的处理前处理和后续loss的计算。</p><hr><img src="/2019/12/10/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-NLP-BERT/uniter.png" class="" title="UniterModel"><hr><p>本篇论文是将检测和图片描述作为提个一组输入，数据的构成方式和BERT类似，一些区别点是</p><ol><li>第一个句子用图片检测<code>RPN</code>之后得到的<code>ROIPooling</code>特征，第二个句子对应着当前这张图片的描述信息</li><li>使用和<code>BERT</code>相似的训练策略，不过略有不同，在原来<code>MLM</code>，<code>NSP</code>基础上加对视觉部分的<code>MRM</code></li><li><code>MLM</code>和<code>MRM</code>是基于条件性的，二者不能同时进行，这个在制作数据的时候要注意</li><li>在数据预处理过程中，视觉部分和文本部分分别处理之后进行<code>concat</code>，再输入给<code>transformer</code>部分</li><li><code>Loss</code>部分在原来的基础上计入了<code>MRM</code>部分的损失，并且论文中针对<code>MRM</code>部分的损失设计了三种方式<ol><li>视觉特征回归<code>MRFR</code></li><li>类别分类<code>MRC</code></li><li>KL散度类别回归<code>MRC-kl</code></li></ol></li></ol><h2 id="Reference"><a href="#Reference" class="headerlink" title="Reference"></a>Reference</h2><ol><li>Official Github: <a href="https://github.com/google-research/bert">https://github.com/google-research/bert</a></li><li>知乎: <a href="https://zhuanlan.zhihu.com/p/48612853">https://zhuanlan.zhihu.com/p/48612853</a></li></ol>]]>
    </content>
    <id>https://xiaofengshi.com/2019/12/10/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-NLP-BERT/</id>
    <link href="https://xiaofengshi.com/2019/12/10/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-NLP-BERT/"/>
    <published>2019-12-10T14:42:56.000Z</published>
    <summary>
      <![CDATA[<img src="/2019/12/10/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-NLP-BERT/bert.png" class="" title="BERT">

<p><strong>BERT</strong>全名为(<strong>Bidirectional Encoder Representations from Transformers</strong>), 在<strong>NLP</strong>领域作为<strong>Word2vec</strong>的替代者，将NLP中的<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>11</mn></mrow></semantics></math></span></span>项任务精度向前大大推进，作为一名算法工程师，非常有必要好好研究一下。</p>]]>
    </summary>
    <title>深度学习-NLP-BERT</title>
    <updated>2020-02-03T21:30:36.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Xiaofeng Shi</name>
    </author>
    <category term="Tensorflow" scheme="https://xiaofengshi.com/categories/Tensorflow/"/>
    <category term="Tensorflow" scheme="https://xiaofengshi.com/tags/Tensorflow/"/>
    <content>
      <![CDATA[<p>本篇主要记录在日常工作中遇到的TensorFlow的相关信息，包括如何处理报错信息，环境设置，训练测试，数据等等。</p><span id="more"></span><h2 id="如何安装"><a href="#如何安装" class="headerlink" title="如何安装"></a>如何安装</h2><p>安装tensorflow或者ubunt时，优先使用清华镜像</p><p>地址：<a href="https://mirrors.tuna.tsinghua.edu.cn/help/tensorflow/">https://mirrors.tuna.tsinghua.edu.cn/help/tensorflow/</a></p><p>安装教程可以参考 <a href="https://www.tensorflow.org/install/source">https://www.tensorflow.org/install/source</a></p><p>在安装GPU版本的时候，要安装对应的cuda和cudnn文件，详细信息可以参考NVIDIA的官网，对于CUDA 和TensorFlow-GPU的版本对照，</p><img src="/2019/03/19/DeepLearning_Tensorflow/cuda_tf.png" class=""><h3 id="1-安装pipeline"><a href="#1-安装pipeline" class="headerlink" title="1. 安装pipeline"></a>1. 安装pipeline</h3><ol><li><p>安装NVIDIA驱动</p><p>使用<code>nvidia-smi</code>进行测试，如果没有该命令，需要安装，安装链接为<a href="https://www.nvidia.com/Download/index.aspx?lang=en-us">https://www.nvidia.com/Download/index.aspx?lang=en-us</a> ，如果已经安装，进入下一步 </p></li><li><p>安装cuda</p><ol><li><p>首先要查询想要安装的TensorFlow版本与cuda版本的对应关系，可以在此处查询<a href="https://www.tensorflow.org/install/source%EF%BC%8C%E5%8F%A6%E5%A4%96%EF%BC%8C%E8%A1%A5%E5%85%85TensorFlow1.14.0">https://www.tensorflow.org/install/source，另外，补充TensorFlow1.14.0</a> 对应cuda10.0</p></li><li><p>确认好版本之后在此处进行下载<a href="https://developer.nvidia.com/cuda-toolkit-archive">https://developer.nvidia.com/cuda-toolkit-archive</a> 以cuda10+linux为例，当安装的是debain版本时，选择14.04的版本，因为cuda是向下兼容的，这样可以避免出错，</p></li><li><p>推荐下载runfile的方式，安装方式如下</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">Installation Instructions:</span><br><span class="line">Run `sudo sh cuda_10.0.130_410.48_linux.run`</span><br><span class="line">Follow the command-line prompts</span><br></pre></td></tr></table></figure></li><li><p>按照提示一步步进行安装即可，最后在<code>.zshrc</code> 或者<code>.bashrc</code>中加入cuda的路径</p></li></ol></li><li><p>安装cudnn</p><ol><li><p>下载地址<a href="https://developer.nvidia.com/rdp/cudnn-download">https://developer.nvidia.com/rdp/cudnn-download</a></p></li><li><p>根据安装的cuda版本找到对应的cudnn版本，尽量选择runtime版本，下载完之后，进行安装</p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">sudo dpkg -i xxx.deb</span><br></pre></td></tr></table></figure></li></ol></li><li><p>安装tensorflow</p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">pip install tensorflow-gpu=1.14.0</span><br></pre></td></tr></table></figure></li></ol><h2 id="API查询"><a href="#API查询" class="headerlink" title="API查询"></a>API查询</h2><p><a href="https://www.tensorflow.org/overview?hl=zh_cn">https://www.tensorflow.org/overview?hl=zh_cn</a>该网址保存着tensorflow的实例，操作手册和api查询</p><h2 id="高质量仓库和博客"><a href="#高质量仓库和博客" class="headerlink" title="高质量仓库和博客"></a>高质量仓库和博客</h2><p>BLOG:</p><ol><li>总览：<a href="https://www.tensorflow.org/overview">https://www.tensorflow.org/overview</a></li><li>常用指令的用法：<a href="https://www.tensorflow.org/guide">https://www.tensorflow.org/guide</a></li><li>常见模型：<a href="https://www.tensorflow.org/tutorials">https://www.tensorflow.org/tutorials</a></li></ol><p>GITHUB：</p><ol><li>官方仓库：<a href="https://github.com/tensorflow/models/">https://github.com/tensorflow/models/</a></li><li>高星仓库：<a href="https://github.com/aymericdamien/TensorFlow-Examples">https://github.com/aymericdamien/TensorFlow-Examples</a></li></ol><h2 id="报错信息及处理方案"><a href="#报错信息及处理方案" class="headerlink" title="报错信息及处理方案"></a>报错信息及处理方案</h2><h3 id="CentOS安装TensorFlow-ImportError-usr-lib64-libstdc-so-6-version-CXXABI-1-3-7’-not-found"><a href="#CentOS安装TensorFlow-ImportError-usr-lib64-libstdc-so-6-version-CXXABI-1-3-7’-not-found" class="headerlink" title="CentOS安装TensorFlow:ImportError: &#x2F;usr&#x2F;lib64&#x2F;libstdc++.so.6: version CXXABI_1.3.7’ not found"></a>CentOS安装TensorFlow:ImportError: &#x2F;usr&#x2F;lib64&#x2F;libstdc++.so.6: version CXXABI_1.3.7’ not found</h3><p>也有可能是这种信息,终端启动python，执行import tensorflow的操作出现的报错信息</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br></pre></td><td class="code"><pre><span class="line">(tf) shixiaofeng@n8-035-087:~$ python</span><br><span class="line">Python 2.7.16 |Anaconda, Inc.| (default, Mar 14 2019, 21:00:58)</span><br><span class="line">[GCC 7.3.0] on linux2</span><br><span class="line">Type <span class="string">&quot;help&quot;</span>, <span class="string">&quot;copyright&quot;</span>, <span class="string">&quot;credits&quot;</span> or <span class="string">&quot;license&quot;</span> <span class="keyword">for</span> more information.</span><br><span class="line">&gt;&gt;&gt; import tensorflow as tf</span><br><span class="line">Traceback (most recent call last):</span><br><span class="line">  File <span class="string">&quot;&lt;stdin&gt;&quot;</span>, line 1, <span class="keyword">in</span> &lt;module&gt;</span><br><span class="line">  File <span class="string">&quot;/data00/home/shixiaofeng/anaconda2/envs/tf/lib/python2.7/site-packages/tensorflow/__init__.py&quot;</span>, line 24, <span class="keyword">in</span> &lt;module&gt;</span><br><span class="line">    from tensorflow.python import *</span><br><span class="line">  File <span class="string">&quot;/data00/home/shixiaofeng/anaconda2/envs/tf/lib/python2.7/site-packages/tensorflow/python/__init__.py&quot;</span>, line 52, <span class="keyword">in</span> &lt;module&gt;</span><br><span class="line">    from tensorflow.core.framework.graph_pb2 import *</span><br><span class="line">  File <span class="string">&quot;/data00/home/shixiaofeng/anaconda2/envs/tf/lib/python2.7/site-packages/tensorflow/core/framework/graph_pb2.py&quot;</span>, line 6, <span class="keyword">in</span> &lt;module&gt;</span><br><span class="line">    from google.protobuf import descriptor as _descriptor</span><br><span class="line">  File <span class="string">&quot;/data00/home/shixiaofeng/anaconda2/envs/tf/lib/python2.7/site-packages/google/protobuf/descriptor.py&quot;</span>, line 47, <span class="keyword">in</span> &lt;module&gt;</span><br><span class="line">    from google.protobuf.pyext import _message</span><br><span class="line">ImportError: /usr/lib/x86_64-linux-gnu/libstdc++.so.6: version `CXXABI_1.3.9<span class="string">&#x27; not found (required by /data00/home/shixiaofeng/anaconda2/envs/tf/lib/python2.7/site-packages/google/protobuf/pyext/_message.so)</span></span><br></pre></td></tr></table></figure><p>遇到这种相关信息是因为动态库版本过低造成的。对于TensorFlow的model目前一般使用的是最低1.5版本，这就需要对TensorFlow进行编码的时候需要一定的动态库版本。</p><ul><li><p>处理方式：</p><ul><li>查看虚拟环境中的动态库版本，下面的代码是找到名称为tf的虚拟环境下的动态库版本  <figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">strings ~/anaconda2/envs/tf/lib/libstdc++.so.6 | grep <span class="string">&#x27;CXXABI&#x27;</span></span><br></pre></td></tr></table></figure></li><li>查看系统的动态库版本  <figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line">strings /usr/lib/x86_64-linux-gnu/libstdc++.so.6 | grep <span class="string">&#x27;CXXABI&#x27;</span></span><br><span class="line">strings</span><br><span class="line">或者</span><br><span class="line">/usr/lib64/libstdc++.so.6 | grep <span class="string">&#x27;CXXABI&#x27;</span></span><br></pre></td></tr></table></figure></li><li>如果发现系统的动态库版本较低并且就如报错信息所言，不存在需要的动态库版本，并且虚拟环境中的动态库版本较高，这个时候将虚拟环境下的动态库文件复制到系统环境下</li></ul>  <figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br></pre></td><td class="code"><pre><span class="line"># cd到系统路径</span><br><span class="line">cd /usr/lib/x86_64-linux-gnu</span><br><span class="line"># 或者</span><br><span class="line">cd /usr/lib64</span><br><span class="line"># 查询libstd++版本文件</span><br><span class="line">find . -name &quot;libstdc++&quot;</span><br><span class="line"># 复制动态库文件到系统目录</span><br><span class="line">sudo cp ~/anaconda2/envs/tf/lib/libstdc++.so.6.0.25 /usr/lib/x86_64-linux-gnu/</span><br><span class="line"># /usr/lib/x86_64-linux-gnu/目录下在创建软连接</span><br><span class="line">ln -snf ./libstdc++.so.6.0.25 ./libstdc++.so.6</span><br></pre></td></tr></table></figure></li></ul><h3 id="查看tf在cpu还是gpu"><a href="#查看tf在cpu还是gpu" class="headerlink" title="查看tf在cpu还是gpu"></a>查看tf在cpu还是gpu</h3><p>激活环境</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">import</span> numpy</span><br><span class="line"><span class="keyword">import</span> tensorflow <span class="keyword">as</span> tf</span><br><span class="line">a = tf.constant([<span class="number">1.0</span>, <span class="number">2.0</span>, <span class="number">3.0</span>, <span class="number">4.0</span>, <span class="number">5.0</span>, <span class="number">6.0</span>], shape=[<span class="number">2</span>, <span class="number">3</span>], name=<span class="string">&#x27;a&#x27;</span>)</span><br><span class="line">b = tf.constant([<span class="number">1.0</span>, <span class="number">2.0</span>, <span class="number">3.0</span>, <span class="number">4.0</span>, <span class="number">5.0</span>, <span class="number">6.0</span>], shape=[<span class="number">3</span>, <span class="number">2</span>], name=<span class="string">&#x27;b&#x27;</span>)</span><br><span class="line">c = tf.matmul(a, b)</span><br><span class="line">sess = tf.Session(config=tf.ConfigProto(log_device_placement=<span class="literal">True</span>))</span><br><span class="line"><span class="built_in">print</span> sess.run(c)</span><br></pre></td></tr></table></figure><p>会得到运行信息</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br></pre></td><td class="code"><pre><span class="line">2019-04-03 16:20:34.035168: I tensorflow/core/platform/cpu_feature_guard.cc:137] Your CPU supports instructions that this TensorFlow binary was not compiled to use: SSE4.1 SSE4.2 AVX AVX2 FMA</span><br><span class="line">2019-04-03 16:20:34.833230: I tensorflow/core/common_runtime/gpu/gpu_device.cc:1030] Found device 0 with properties:</span><br><span class="line">name: GeForce GTX 1080 Ti major: 6 minor: 1 memoryClockRate(GHz): 1.582</span><br><span class="line">pciBusID: 0000:02:00.0</span><br><span class="line">totalMemory: 10.92GiB freeMemory: 10.77GiB</span><br><span class="line">2019-04-03 16:20:34.945989: I tensorflow/core/common_runtime/gpu/gpu_device.cc:1030] Found device 1 with properties:</span><br><span class="line">name: GeForce GTX 1080 Ti major: 6 minor: 1 memoryClockRate(GHz): 1.582</span><br><span class="line">pciBusID: 0000:03:00.0</span><br><span class="line">totalMemory: 10.92GiB freeMemory: 10.77GiB</span><br><span class="line">2019-04-03 16:20:35.058179: I tensorflow/core/common_runtime/gpu/gpu_device.cc:1030] Found device 2 with properties:</span><br><span class="line">name: GeForce GTX 1080 Ti major: 6 minor: 1 memoryClockRate(GHz): 1.582</span><br><span class="line">pciBusID: 0000:82:00.0</span><br><span class="line">totalMemory: 10.92GiB freeMemory: 10.77GiB</span><br><span class="line">2019-04-03 16:20:35.171617: I tensorflow/core/common_runtime/gpu/gpu_device.cc:1030] Found device 3 with properties:</span><br><span class="line">name: GeForce GTX 1080 Ti major: 6 minor: 1 memoryClockRate(GHz): 1.582</span><br><span class="line">pciBusID: 0000:83:00.0</span><br><span class="line">totalMemory: 10.92GiB freeMemory: 10.77GiB</span><br><span class="line">2019-04-03 16:20:35.173885: I tensorflow/core/common_runtime/gpu/gpu_device.cc:1045] Device peer to peer matrix</span><br><span class="line">2019-04-03 16:20:35.173989: I tensorflow/core/common_runtime/gpu/gpu_device.cc:1051] DMA: 0 1 2 3</span><br><span class="line">2019-04-03 16:20:35.174006: I tensorflow/core/common_runtime/gpu/gpu_device.cc:1061] 0:   Y Y N N</span><br><span class="line">2019-04-03 16:20:35.174017: I tensorflow/core/common_runtime/gpu/gpu_device.cc:1061] 1:   Y Y N N</span><br><span class="line">2019-04-03 16:20:35.174026: I tensorflow/core/common_runtime/gpu/gpu_device.cc:1061] 2:   N N Y Y</span><br><span class="line">2019-04-03 16:20:35.174036: I tensorflow/core/common_runtime/gpu/gpu_device.cc:1061] 3:   N N Y Y</span><br><span class="line">2019-04-03 16:20:35.174052: I tensorflow/core/common_runtime/gpu/gpu_device.cc:1120] Creating TensorFlow device (/device:GPU:0) -&gt; (device: 0, name: GeForce GTX 1080 Ti, pci bus <span class="built_in">id</span>: 0000:02:00.0, compute capability: 6.1)</span><br><span class="line">2019-04-03 16:20:35.174065: I tensorflow/core/common_runtime/gpu/gpu_device.cc:1120] Creating TensorFlow device (/device:GPU:1) -&gt; (device: 1, name: GeForce GTX 1080 Ti, pci bus <span class="built_in">id</span>: 0000:03:00.0, compute capability: 6.1)</span><br><span class="line">2019-04-03 16:20:35.174077: I tensorflow/core/common_runtime/gpu/gpu_device.cc:1120] Creating TensorFlow device (/device:GPU:2) -&gt; (device: 2, name: GeForce GTX 1080 Ti, pci bus <span class="built_in">id</span>: 0000:82:00.0, compute capability: 6.1)</span><br><span class="line">2019-04-03 16:20:35.174088: I tensorflow/core/common_runtime/gpu/gpu_device.cc:1120] Creating TensorFlow device (/device:GPU:3) -&gt; (device: 3, name: GeForce GTX 1080 Ti, pci bus <span class="built_in">id</span>: 0000:83:00.0, compute capability: 6.1)</span><br><span class="line">Device mapping:</span><br><span class="line">/job:localhost/replica:0/task:0/device:GPU:0 -&gt; device: 0, name: GeForce GTX 1080 Ti, pci bus <span class="built_in">id</span>: 0000:02:00.0, compute capability: 6.1</span><br><span class="line">/job:localhost/replica:0/task:0/device:GPU:1 -&gt; device: 1, name: GeForce GTX 1080 Ti, pci bus <span class="built_in">id</span>: 0000:03:00.0, compute capability: 6.1</span><br><span class="line">/job:localhost/replica:0/task:0/device:GPU:2 -&gt; device: 2, name: GeForce GTX 1080 Ti, pci bus <span class="built_in">id</span>: 0000:82:00.0, compute capability: 6.1</span><br><span class="line">/job:localhost/replica:0/task:0/device:GPU:3 -&gt; device: 3, name: GeForce GTX 1080 Ti, pci bus <span class="built_in">id</span>: 0000:83:00.0, compute capability: 6.1</span><br><span class="line">2019-04-03 16:20:35.924911: I tensorflow/core/common_runtime/direct_session.cc:299] Device mapping:</span><br><span class="line">/job:localhost/replica:0/task:0/device:GPU:0 -&gt; device: 0, name: GeForce GTX 1080 Ti, pci bus <span class="built_in">id</span>: 0000:02:00.0, compute capability: 6.1</span><br><span class="line">/job:localhost/replica:0/task:0/device:GPU:1 -&gt; device: 1, name: GeForce GTX 1080 Ti, pci bus <span class="built_in">id</span>: 0000:03:00.0, compute capability: 6.1</span><br><span class="line">/job:localhost/replica:0/task:0/device:GPU:2 -&gt; device: 2, name: GeForce GTX 1080 Ti, pci bus <span class="built_in">id</span>: 0000:82:00.0, compute capability: 6.1</span><br><span class="line">/job:localhost/replica:0/task:0/device:GPU:3 -&gt; device: 3, name: GeForce GTX 1080 Ti, pci bus <span class="built_in">id</span>: 0000:83:00.0, compute capability: 6.1</span><br><span class="line"></span><br><span class="line">&gt;&gt;&gt; <span class="built_in">print</span> sess.run(c)</span><br><span class="line">MatMul: (MatMul): /job:localhost/replica:0/task:0/device:GPU:0</span><br><span class="line">2019-04-03 16:20:38.192824: I tensorflow/core/common_runtime/placer.cc:874] MatMul: (MatMul)/job:localhost/replica:0/task:0/device:GPU:0</span><br><span class="line">b: (Const): /job:localhost/replica:0/task:0/device:GPU:0</span><br><span class="line">2019-04-03 16:20:38.192864: I tensorflow/core/common_runtime/placer.cc:874] b: (Const)/job:localhost/replica:0/task:0/device:GPU:0</span><br><span class="line">a: (Const): /job:localhost/replica:0/task:0/device:GPU:0</span><br><span class="line">2019-04-03 16:20:38.192885: I tensorflow/core/common_runtime/placer.cc:874] a: (Const)/job:localhost/replica:0/task:0/device:GPU:0</span><br><span class="line">[[22. 28.]</span><br><span class="line"> [49. 64.]]</span><br></pre></td></tr></table></figure><h3 id="anaconda虚拟环境添加路径"><a href="#anaconda虚拟环境添加路径" class="headerlink" title="anaconda虚拟环境添加路径"></a>anaconda虚拟环境添加路径</h3><p>如果是个人创建的环境，则目录为，针对的是anaconda2，当然要根据自己安装的anaconda版本确定路径。</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">~/anaconda2/envs/tf/lib/python2.7/site-packages</span><br></pre></td></tr></table></figure><p>如果是base环境</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">~/anaconda2/lib/python2.7/site-packages</span><br></pre></td></tr></table></figure><p>在目录下创建文件<code>*.pth</code>文件</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">vim add_path.pth</span><br></pre></td></tr></table></figure><p>在文件下添加内容，如下针对的是对于目前本人使用的开发机</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">/data00/home/xxx/repos/toutiao/lib/</span><br><span class="line">/data00/home/xxx/repos/toutiao/tools/rpc-tool</span><br><span class="line">/data00/home/xxx/ow_package/Theano</span><br></pre></td></tr></table></figure><p>如果想要cuda路径信息</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 添加cuda8路径</span></span><br><span class="line">/usr/local/cuda-8.0/bin/</span><br><span class="line">/usr/local/cuda-8.0/lib64</span><br></pre></td></tr></table></figure><p>也可以直接添加到<code>~/.bashrc</code>中</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line"><span class="built_in">export</span> PATH=/usr/local/cuda-8.0/bin/:<span class="variable">$PATH</span></span><br><span class="line"><span class="built_in">export</span> LD_LIBRARY_PATH=/usr/local/cuda-8.0/lib64:<span class="variable">$LD_LIBRARY_PATH</span></span><br></pre></td></tr></table></figure><h3 id="无法导入tensorflow"><a href="#无法导入tensorflow" class="headerlink" title="无法导入tensorflow"></a>无法导入tensorflow</h3><p>已经安装<code>tensorflow</code>，但是在import的时候会出现<code>no module name tensorflow</code>的错误信息</p><p><strong>卸载tensorflow并重新安装</strong></p><h2 id="多GPU使用"><a href="#多GPU使用" class="headerlink" title="多GPU使用"></a>多GPU使用</h2><h3 id="Train"><a href="#Train" class="headerlink" title="Train"></a>Train</h3><p>官方的参考链接</p><p><a href="https://www.tensorflow.org/guide/using_gpu#using_multiple_gpus">https://www.tensorflow.org/guide/using_gpu#using_multiple_gpus</a></p><p><a href="https://www.tensorflow.org/alpha/guide/using_gpu?hl=zh_cn#using_multiple_gpus">https://www.tensorflow.org/alpha/guide/using_gpu?hl=zh_cn#using_multiple_gpus</a></p><p>官方代码，存在于tensorflow&#x2F;model&#x2F;</p><p>这个说的就是并行化，一般是模型并行化和数据并行化</p><ul><li>模型并行化：不同的gpu保存的模型不同，输入的数据相同，共同训练，可以认为是一种bagging，一般Deeplearning用的不多</li><li>数据并行化：不同的gpu保存的模型是相同，输入的数据不同，共同训练，指定一个device来保存模型参数，分配给使用的gpu模型中，使用所有模型的平均梯度来进行参数更新，一般用的是这种方式。</li></ul><img src="/2019/03/19/DeepLearning_Tensorflow/multi_gpu.png" class="" title="多GPU训练数据流"><p><strong>使用Minist进行多GPU试验</strong></p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br><span class="line">51</span><br><span class="line">52</span><br><span class="line">53</span><br><span class="line">54</span><br><span class="line">55</span><br><span class="line">56</span><br><span class="line">57</span><br><span class="line">58</span><br><span class="line">59</span><br><span class="line">60</span><br><span class="line">61</span><br><span class="line">62</span><br><span class="line">63</span><br><span class="line">64</span><br><span class="line">65</span><br><span class="line">66</span><br><span class="line">67</span><br><span class="line">68</span><br><span class="line">69</span><br><span class="line">70</span><br><span class="line">71</span><br><span class="line">72</span><br><span class="line">73</span><br><span class="line">74</span><br><span class="line">75</span><br><span class="line">76</span><br><span class="line">77</span><br><span class="line">78</span><br><span class="line">79</span><br><span class="line">80</span><br><span class="line">81</span><br><span class="line">82</span><br><span class="line">83</span><br><span class="line">84</span><br><span class="line">85</span><br><span class="line">86</span><br><span class="line">87</span><br><span class="line">88</span><br><span class="line">89</span><br><span class="line">90</span><br><span class="line">91</span><br><span class="line">92</span><br><span class="line">93</span><br><span class="line">94</span><br><span class="line">95</span><br><span class="line">96</span><br><span class="line">97</span><br><span class="line">98</span><br><span class="line">99</span><br><span class="line">100</span><br><span class="line">101</span><br><span class="line">102</span><br><span class="line">103</span><br><span class="line">104</span><br><span class="line">105</span><br><span class="line">106</span><br><span class="line">107</span><br><span class="line">108</span><br><span class="line">109</span><br><span class="line">110</span><br><span class="line">111</span><br><span class="line">112</span><br><span class="line">113</span><br><span class="line">114</span><br><span class="line">115</span><br><span class="line">116</span><br><span class="line">117</span><br><span class="line">118</span><br><span class="line">119</span><br><span class="line">120</span><br><span class="line">121</span><br><span class="line">122</span><br><span class="line">123</span><br><span class="line">124</span><br><span class="line">125</span><br><span class="line">126</span><br><span class="line">127</span><br><span class="line">128</span><br><span class="line">129</span><br><span class="line">130</span><br><span class="line">131</span><br><span class="line">132</span><br><span class="line">133</span><br><span class="line">134</span><br><span class="line">135</span><br><span class="line">136</span><br><span class="line">137</span><br><span class="line">138</span><br><span class="line">139</span><br><span class="line">140</span><br><span class="line">141</span><br><span class="line">142</span><br><span class="line">143</span><br><span class="line">144</span><br><span class="line">145</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">import</span> tensorflow <span class="keyword">as</span> tf</span><br><span class="line"><span class="keyword">import</span> numpy <span class="keyword">as</span> np</span><br><span class="line"><span class="keyword">from</span> tensorflow.contrib <span class="keyword">import</span> slim</span><br><span class="line"><span class="keyword">from</span> tensorflow.examples.tutorials.mnist <span class="keyword">import</span> input_data</span><br><span class="line"><span class="comment"># 读取minist数据集</span></span><br><span class="line">mnist = input_data.read_data_sets(<span class="string">&quot;/tmp/mnist/&quot;</span>, one_hot=<span class="literal">True</span>)</span><br><span class="line"> </span><br><span class="line">num_gpus = <span class="number">2</span></span><br><span class="line">num_steps = <span class="number">1000</span></span><br><span class="line">learning_rate = <span class="number">0.001</span></span><br><span class="line">batch_size = <span class="number">1000</span></span><br><span class="line">display_step = <span class="number">10</span></span><br><span class="line"> </span><br><span class="line">num_input = <span class="number">784</span></span><br><span class="line">num_classes = <span class="number">10</span></span><br><span class="line"></span><br><span class="line"><span class="comment"># 定义minist训练网络</span></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">conv_net_with_layers</span>(<span class="params">x,is_training,dropout = <span class="number">0.75</span></span>):</span><br><span class="line">    <span class="keyword">with</span> tf.variable_scope(<span class="string">&quot;ConvNet&quot;</span>, reuse=tf.AUTO_REUSE):</span><br><span class="line">        x = tf.reshape(x, [-<span class="number">1</span>, <span class="number">28</span>, <span class="number">28</span>, <span class="number">1</span>])</span><br><span class="line">        x = tf.layers.conv2d(x, <span class="number">12</span>, <span class="number">5</span>, activation=tf.nn.relu)</span><br><span class="line">        x = tf.layers.max_pooling2d(x, <span class="number">2</span>, <span class="number">2</span>)</span><br><span class="line">        x = tf.layers.conv2d(x, <span class="number">24</span>, <span class="number">3</span>, activation=tf.nn.relu)</span><br><span class="line">        x = tf.layers.max_pooling2d(x, <span class="number">2</span>, <span class="number">2</span>)</span><br><span class="line">        x = tf.layers.flatten(x)</span><br><span class="line">        x = tf.layers.dense(x, <span class="number">100</span>)</span><br><span class="line">        x = tf.layers.dropout(x, rate=dropout, training=is_training)</span><br><span class="line">        out = tf.layers.dense(x, <span class="number">10</span>)</span><br><span class="line">        out = tf.nn.softmax(out) <span class="keyword">if</span> <span class="keyword">not</span> is_training <span class="keyword">else</span> out</span><br><span class="line">    <span class="keyword">return</span> out</span><br><span class="line"> </span><br><span class="line"><span class="keyword">def</span> <span class="title function_">conv_net</span>(<span class="params">x,is_training</span>):</span><br><span class="line">    <span class="comment"># &quot;updates_collections&quot;: None is very import ,without will only get 0.10</span></span><br><span class="line">    batch_norm_params = &#123;<span class="string">&quot;is_training&quot;</span>: is_training, <span class="string">&quot;decay&quot;</span>: <span class="number">0.9</span>, <span class="string">&quot;updates_collections&quot;</span>: <span class="literal">None</span>&#125;</span><br><span class="line">    <span class="comment">#,&#x27;variables_collections&#x27;: [ tf.GraphKeys.TRAINABLE_VARIABLES ]</span></span><br><span class="line">    <span class="keyword">with</span> slim.arg_scope([slim.conv2d, slim.fully_connected],</span><br><span class="line">                        activation_fn=tf.nn.relu,</span><br><span class="line">                        weights_initializer=tf.truncated_normal_initializer(mean=<span class="number">0.0</span>, stddev=<span class="number">0.01</span>),</span><br><span class="line">                        weights_regularizer=slim.l2_regularizer(<span class="number">0.0005</span>),</span><br><span class="line">                        normalizer_fn=slim.batch_norm, normalizer_params=batch_norm_params):</span><br><span class="line">        <span class="keyword">with</span> tf.variable_scope(<span class="string">&quot;ConvNet&quot;</span>,reuse=tf.AUTO_REUSE):</span><br><span class="line">            x = tf.reshape(x, [-<span class="number">1</span>, <span class="number">28</span>, <span class="number">28</span>, <span class="number">1</span>])</span><br><span class="line">            net = slim.conv2d(x, <span class="number">6</span>, [<span class="number">5</span>,<span class="number">5</span>], scope=<span class="string">&quot;conv_1&quot;</span>)</span><br><span class="line">            net = slim.max_pool2d(net, [<span class="number">2</span>, <span class="number">2</span>],scope=<span class="string">&quot;pool_1&quot;</span>)</span><br><span class="line">            net = slim.conv2d(net, <span class="number">12</span>, [<span class="number">5</span>,<span class="number">5</span>], scope=<span class="string">&quot;conv_2&quot;</span>)</span><br><span class="line">            net = slim.max_pool2d(net, [<span class="number">2</span>, <span class="number">2</span>], scope=<span class="string">&quot;pool_2&quot;</span>)</span><br><span class="line">            net = slim.flatten(net, scope=<span class="string">&quot;flatten&quot;</span>)</span><br><span class="line">            net = slim.fully_connected(net, <span class="number">100</span>, scope=<span class="string">&quot;fc&quot;</span>)</span><br><span class="line">            net = slim.dropout(net,is_training=is_training)</span><br><span class="line">            net = slim.fully_connected(net, num_classes, scope=<span class="string">&quot;prob&quot;</span>, activation_fn=<span class="literal">None</span>,normalizer_fn=<span class="literal">None</span>)</span><br><span class="line">            <span class="keyword">return</span> net</span><br><span class="line"> </span><br><span class="line"><span class="keyword">def</span> <span class="title function_">average_gradients</span>(<span class="params">tower_grads</span>):</span><br><span class="line">    average_grads = []</span><br><span class="line">    <span class="keyword">for</span> grad_and_vars <span class="keyword">in</span> <span class="built_in">zip</span>(*tower_grads):</span><br><span class="line">        grads = []</span><br><span class="line">        <span class="keyword">for</span> g, _ <span class="keyword">in</span> grad_and_vars:</span><br><span class="line">            expend_g = tf.expand_dims(g, <span class="number">0</span>)</span><br><span class="line">            grads.append(expend_g)</span><br><span class="line">        grad = tf.concat(grads, <span class="number">0</span>)</span><br><span class="line">        grad = tf.reduce_mean(grad, <span class="number">0</span>)</span><br><span class="line">        v = grad_and_vars[<span class="number">0</span>][<span class="number">1</span>]</span><br><span class="line">        grad_and_var = (grad, v)</span><br><span class="line">        average_grads.append(grad_and_var)</span><br><span class="line">    <span class="keyword">return</span> average_grads</span><br><span class="line"> </span><br><span class="line"> </span><br><span class="line"><span class="keyword">def</span> <span class="title function_">train</span>():</span><br><span class="line">    <span class="keyword">with</span> tf.device(<span class="string">&quot;/cpu:0&quot;</span>):</span><br><span class="line">      <span class="comment"># tower_grads变量保存在cpu中</span></span><br><span class="line">        global_step=tf.train.get_or_create_global_step()</span><br><span class="line">        tower_grads = []</span><br><span class="line">        </span><br><span class="line">        X = tf.placeholder(tf.float32, [<span class="literal">None</span>, num_input])</span><br><span class="line">        Y = tf.placeholder(tf.float32, [<span class="literal">None</span>, num_classes])</span><br><span class="line">        </span><br><span class="line">        opt = tf.train.AdamOptimizer(learning_rate)</span><br><span class="line">        <span class="keyword">with</span> tf.variable_scope(tf.get_variable_scope()):</span><br><span class="line">            <span class="keyword">for</span> i <span class="keyword">in</span> <span class="built_in">range</span>(<span class="number">2</span>):</span><br><span class="line">                <span class="keyword">with</span> tf.device(<span class="string">&quot;/gpu:%d&quot;</span> % i):</span><br><span class="line">                    <span class="keyword">with</span> tf.name_scope(<span class="string">&quot;tower_%d&quot;</span> % i):</span><br><span class="line">                      <span class="comment"># 数据并行，使用该数据在当前设备下计算预测值</span></span><br><span class="line">                            _x = X[i * batch_size:(i + <span class="number">1</span>) * batch_size]</span><br><span class="line">                            _y = Y[i * batch_size:(i + <span class="number">1</span>) * batch_size]</span><br><span class="line">                            logits = conv_net(_x, <span class="literal">True</span>)</span><br><span class="line">                            tf.get_variable_scope().reuse_variables()</span><br><span class="line">                            loss = tf.reduce_mean(tf.nn.softmax_cross_entropy_with_logits(labels=_y, logits=logits))</span><br><span class="line">                            <span class="comment"># 根据当前模型的损失计算梯度</span></span><br><span class="line">                            grads = opt.compute_gradients(loss)</span><br><span class="line">                            <span class="comment"># 将梯度保存在临时变量tower_grads中</span></span><br><span class="line">                            tower_grads.append(grads)</span><br><span class="line">                            <span class="comment"># 使用第一个gpu进行验证，计算正确率</span></span><br><span class="line">                            <span class="keyword">if</span> i == <span class="number">0</span>:</span><br><span class="line">                                logits_test = conv_net(_x, <span class="literal">False</span>)</span><br><span class="line">                                correct_prediction = tf.equal(tf.argmax(logits_test, <span class="number">1</span>), tf.argmax(_y, <span class="number">1</span>))</span><br><span class="line">                                accuracy = tf.reduce_mean(tf.cast(correct_prediction, tf.float32))</span><br><span class="line">        <span class="comment"># 计算所有模型的平均梯度</span></span><br><span class="line">        grads = average_gradients(tower_grads)</span><br><span class="line">        <span class="comment"># 对优化器赋予当前的平均梯度进行参数更新</span></span><br><span class="line">        train_op = opt.apply_gradients(grads)</span><br><span class="line">        <span class="keyword">with</span> tf.Session() <span class="keyword">as</span> sess:</span><br><span class="line">            sess.run(tf.global_variables_initializer())</span><br><span class="line">            <span class="keyword">for</span> step <span class="keyword">in</span> <span class="built_in">range</span>(<span class="number">1</span>, num_steps + <span class="number">1</span>):</span><br><span class="line">              <span class="comment"># 假设模型中的batch为N，使用gpu数量为M，那么每次拿到的数据为M*N</span></span><br><span class="line"><span class="comment"># 每个模型中feed的数据量都是N</span></span><br><span class="line">                batch_x, batch_y = mnist.train.next_batch(batch_size * num_gpus)</span><br><span class="line">                sess.run(train_op, feed_dict=&#123;X: batch_x, Y: batch_y&#125;)</span><br><span class="line">                <span class="comment"># 每10次计算一次正确率</span></span><br><span class="line">                <span class="keyword">if</span> step % <span class="number">10</span> == <span class="number">0</span> <span class="keyword">or</span> step == <span class="number">1</span>:</span><br><span class="line">                    loss_value, acc = sess.run([loss, accuracy], feed_dict=&#123;X: batch_x, Y: batch_y&#125;)</span><br><span class="line">                    <span class="built_in">print</span>(<span class="string">&quot;Step:&quot;</span> + <span class="built_in">str</span>(step) + <span class="string">&quot;:&quot;</span> + <span class="built_in">str</span>(loss_value) + <span class="string">&quot; &quot;</span> + <span class="built_in">str</span>(acc))</span><br><span class="line">            <span class="built_in">print</span>(<span class="string">&quot;Done&quot;</span>)</span><br><span class="line">            <span class="built_in">print</span>(<span class="string">&quot;Testing Accuracy:&quot;</span>,</span><br><span class="line">                  np.mean([sess.run(accuracy, feed_dict=&#123;X: mnist.test.images[i:i + batch_size],</span><br><span class="line">                                                         Y: mnist.test.labels[i:i + batch_size]&#125;) <span class="keyword">for</span> i <span class="keyword">in</span></span><br><span class="line">                           <span class="built_in">range</span>(<span class="number">0</span>, <span class="built_in">len</span>(mnist.test.images), batch_size)]))</span><br><span class="line">            </span><br><span class="line"><span class="comment"># 使用单个gpu设备进行训练</span></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">train_single</span>():</span><br><span class="line">    X = tf.placeholder(tf.float32, [<span class="literal">None</span>, num_input])</span><br><span class="line">    Y = tf.placeholder(tf.float32, [<span class="literal">None</span>, num_classes])</span><br><span class="line">    logits=conv_net(X,<span class="literal">True</span>)</span><br><span class="line">    loss=tf.reduce_mean(tf.nn.softmax_cross_entropy_with_logits(labels=Y,logits=logits))</span><br><span class="line">    opt=tf.train.AdamOptimizer(learning_rate)</span><br><span class="line">    train_op=opt.minimize(loss)</span><br><span class="line">    logits_test=conv_net(X,<span class="literal">False</span>)</span><br><span class="line">    correct_prediction = tf.equal(tf.argmax(logits_test, <span class="number">1</span>), tf.argmax(Y, <span class="number">1</span>))</span><br><span class="line">    accuracy = tf.reduce_mean(tf.cast(correct_prediction, tf.float32))</span><br><span class="line">    <span class="keyword">with</span> tf.Session() <span class="keyword">as</span> sess:</span><br><span class="line">        sess.run(tf.global_variables_initializer())</span><br><span class="line">        <span class="keyword">for</span> step <span class="keyword">in</span> <span class="built_in">range</span>(<span class="number">1</span>,num_steps+<span class="number">1</span>):</span><br><span class="line">            batch_x, batch_y = mnist.train.next_batch(batch_size)</span><br><span class="line">            sess.run(train_op,feed_dict=&#123;X:batch_x,Y:batch_y&#125;)</span><br><span class="line">            <span class="keyword">if</span> step%display_step==<span class="number">0</span> <span class="keyword">or</span> step==<span class="number">1</span>:</span><br><span class="line">                loss_value,acc=sess.run([loss,accuracy],feed_dict=&#123;X:batch_x,Y:batch_y&#125;)</span><br><span class="line">                <span class="built_in">print</span>(<span class="string">&quot;Step:&quot;</span> + <span class="built_in">str</span>(step) + <span class="string">&quot;:&quot;</span> + <span class="built_in">str</span>(loss_value) + <span class="string">&quot; &quot;</span> + <span class="built_in">str</span>(acc))</span><br><span class="line">        <span class="built_in">print</span>(<span class="string">&quot;Done&quot;</span>)</span><br><span class="line">        <span class="built_in">print</span>(<span class="string">&quot;Testing Accuracy:&quot;</span>,np.mean([sess.run(accuracy, feed_dict=&#123;X: mnist.test.images[i:i + batch_size],</span><br><span class="line">              Y: mnist.test.labels[i:i + batch_size]&#125;) <span class="keyword">for</span> i <span class="keyword">in</span></span><br><span class="line">              <span class="built_in">range</span>(<span class="number">0</span>, <span class="built_in">len</span>(mnist.test.images), batch_size)]))</span><br><span class="line"> </span><br><span class="line"><span class="keyword">if</span> __name__ == <span class="string">&quot;__main__&quot;</span>:</span><br><span class="line">    <span class="comment">#train_single()</span></span><br><span class="line">    train()</span><br><span class="line"></span><br></pre></td></tr></table></figure><h3 id="Eval-Inference"><a href="#Eval-Inference" class="headerlink" title="Eval &amp;&amp; Inference"></a>Eval &amp;&amp; Inference</h3><p>在验证和测试的时候，每次输入的数据是单个数据，一般情况下无法进行拆分，因此，单gpu运算。如果增加服务器来处理大量的访问请求，要调用tensorflow serving，多个gpu不熟相同的graph，由tensorflow serving来控制请求的队列。</p><h4 id="GPU选择"><a href="#GPU选择" class="headerlink" title="GPU选择"></a>GPU选择</h4><p>在运行tensorflow gpu时候，如果机器上存在多块显卡，并且没有在代码中进行多gpu设置，最好只用一块gpu，在运行程序的时候，可以使用如下命令</p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">CUDA_VISIBLE_DEVICES=0 python **.py</span><br></pre></td></tr></table></figure><p>如此，之后使用第一块gpu进行计算。</p><p>当然也有其他的设置方法，可以在程序中设置TensorFlow的device环境。</p><h2 id="TensorRT"><a href="#TensorRT" class="headerlink" title="TensorRT"></a>TensorRT</h2><h3 id="install"><a href="#install" class="headerlink" title="install"></a>install</h3><p><a href="https://zhuanlan.zhihu.com/p/88318324">https://zhuanlan.zhihu.com/p/88318324</a></p><p><a href="https://tbr8.org/how-to-install-tensorrt-on-centos/">https://tbr8.org/how-to-install-tensorrt-on-centos/</a></p><h2 id="TfRecord"><a href="#TfRecord" class="headerlink" title="TfRecord"></a>TfRecord</h2><p>TensorFlow推荐使用tfrecord的数据格式。</p><h3 id="read"><a href="#read" class="headerlink" title="read"></a>read</h3><h3 id="write"><a href="#write" class="headerlink" title="write"></a>write</h3><p>将tfrecord中的数据读出，只读取一个epoch， 也就是不进行重复读取，该代码不是为了进行模型训练，只是单纯的读取tfrecord中的数据并保存本地</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br></pre></td><td class="code"><pre><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">tf2image</span>(<span class="params">swd,data_path</span>):</span><br><span class="line"> <span class="string">&quot;&quot;&quot;</span></span><br><span class="line"><span class="string"> swd: 读取的样本要保存的路径</span></span><br><span class="line"><span class="string"> data_path: tfrecord的路径 &#x27;xxx/xxx/*.tfrecord&#x27;格式</span></span><br><span class="line"><span class="string"> &quot;&quot;&quot;</span></span><br><span class="line">    <span class="comment"># get tfrecords</span></span><br><span class="line">    data_files = tf.gfile.Glob(data_path)</span><br><span class="line">    <span class="built_in">print</span>(<span class="string">&#x27;data_files&#x27;</span>,data_files)</span><br><span class="line">    </span><br><span class="line">    <span class="keyword">with</span> tf.Session() <span class="keyword">as</span> sess:</span><br><span class="line">      <span class="comment"># generator</span></span><br><span class="line">        filename_queue = tf.train.string_input_producer(data_files,shuffle=<span class="literal">False</span>,num_epochs=<span class="number">1</span>) </span><br><span class="line">        <span class="comment"># get sample from tfrecod</span></span><br><span class="line">        reader = tf.TFRecordReader()</span><br><span class="line">        _, serialized_example = reader.read(filename_queue)   </span><br><span class="line">        features = tf.parse_single_example(serialized_example,</span><br><span class="line">                                        features=&#123;</span><br><span class="line">                                            <span class="string">&#x27;image_data&#x27;</span>: tf.FixedLenFeature([], dtype=tf.string)&#125;)  </span><br><span class="line">        image = tf.image.decode_jpeg(features[<span class="string">&#x27;image_data&#x27;</span>], channels=<span class="number">3</span>)</span><br><span class="line">        image = tf.image.convert_image_dtype(image, tf.uint8)</span><br><span class="line"></span><br><span class="line">        count=<span class="number">0</span></span><br><span class="line">        sess.run(tf.initialize_local_variables())</span><br><span class="line">        sess.run(tf.initialize_all_variables())</span><br><span class="line">        <span class="comment"># create queue</span></span><br><span class="line">        coord=tf.train.Coordinator()</span><br><span class="line">        <span class="comment"># start queue</span></span><br><span class="line">        threads = tf.train.start_queue_runners(coord=coord)</span><br><span class="line">        </span><br><span class="line">        <span class="keyword">try</span>:</span><br><span class="line">          </span><br><span class="line">            <span class="keyword">while</span> <span class="keyword">not</span> coord.should_stop():</span><br><span class="line">                single= sess.run(image)</span><br><span class="line">                img=Image.fromarray(single, <span class="string">&#x27;RGB&#x27;</span>)</span><br><span class="line">                img.save(swd +<span class="string">&#x27;/&#x27;</span>+ <span class="built_in">str</span>(count) + <span class="string">&#x27;.jpg&#x27;</span>)</span><br><span class="line">                count += <span class="number">1</span></span><br><span class="line">                <span class="keyword">if</span> count % <span class="number">100</span> == <span class="number">0</span>:</span><br><span class="line">                    <span class="built_in">print</span> (<span class="string">&#x27;Alreay run %d images&#x27;</span> % count)</span><br><span class="line">        <span class="keyword">except</span> tf.errors.OutOfRangeError:</span><br><span class="line">          <span class="comment"># if the queue is empty, break </span></span><br><span class="line">            <span class="built_in">print</span>(<span class="string">&#x27;Done running&#x27;</span>)</span><br><span class="line">        <span class="keyword">finally</span>:</span><br><span class="line">            coord.request_stop()</span><br><span class="line">            coord.join(threads)</span><br><span class="line">       </span><br><span class="line"></span><br></pre></td></tr></table></figure><h2 id="Fintune"><a href="#Fintune" class="headerlink" title="Fintune"></a>Fintune</h2><p>微调模型，一般指我们使用一些成型框架如VGG,GOOGLENET等，并在这个网络的基础上添加不同的网络训练层，以适应我们自己的任务。对于vgg等网络，一般是基于Imagenet预训练好的，因此我们没必要再重新从头训练，但是对于IMagenet是1000类，但是我们自己的任务很可能不是在这个数据集上进行的，为了快速训练模型，我们选用模型微调的方法。</p><p>加载一个预训练的模型，固定加载的这个模型的部分权重，只更新部分网络权重。</p><p>参考博客：<a href="https://blog.csdn.net/ying86615791/article/details/76215363">https://blog.csdn.net/ying86615791/article/details/76215363</a></p><p>代码来源：tensorflow yolo3</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br><span class="line">51</span><br><span class="line">52</span><br><span class="line">53</span><br><span class="line">54</span><br><span class="line">55</span><br><span class="line">56</span><br><span class="line">57</span><br><span class="line">58</span><br><span class="line">59</span><br><span class="line">60</span><br><span class="line">61</span><br><span class="line">62</span><br><span class="line">63</span><br><span class="line">64</span><br><span class="line">65</span><br><span class="line">66</span><br><span class="line">67</span><br><span class="line">68</span><br><span class="line">69</span><br><span class="line">70</span><br><span class="line">71</span><br><span class="line">72</span><br><span class="line">73</span><br><span class="line">74</span><br><span class="line">75</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 训练数据集</span></span><br><span class="line">trainset = dataset(parser, train_tfrecord, BATCH_SIZE, shuffle=SHUFFLE_SIZE)</span><br><span class="line">testset = dataset(parser, test_tfrecord, BATCH_SIZE, shuffle=<span class="literal">None</span>)</span><br><span class="line"></span><br><span class="line">is_training = tf.placeholder(tf.<span class="built_in">bool</span>)</span><br><span class="line">example = tf.cond(is_training, <span class="keyword">lambda</span>: trainset.get_next(), <span class="keyword">lambda</span>: testset.get_next())</span><br><span class="line"></span><br><span class="line">images = example[<span class="number">0</span>]</span><br><span class="line">y_true = example[<span class="number">1</span>:]</span><br><span class="line"><span class="comment"># 整个模型结构</span></span><br><span class="line">model = yolov3.yolov3(NUM_CLASSES, ANCHORS)</span><br><span class="line"><span class="keyword">with</span> tf.variable_scope(<span class="string">&#x27;yolov3&#x27;</span>):</span><br><span class="line">    <span class="comment"># pred_feature_map contains three detection feature maps</span></span><br><span class="line">    pred_feature_map = model.forward(images, is_training=is_training)</span><br><span class="line">    loss = model.compute_loss(pred_feature_map, y_true)</span><br><span class="line">    y_pred = model.predict(pred_feature_map)</span><br><span class="line"><span class="comment"># 此时graph中保存着整个网络的全部节点  </span></span><br><span class="line">graph = tf.get_default_graph()</span><br><span class="line"></span><br><span class="line">tf.summary.scalar(<span class="string">&quot;loss/coord_loss&quot;</span>,   loss[<span class="number">1</span>])</span><br><span class="line">tf.summary.scalar(<span class="string">&quot;loss/sizes_loss&quot;</span>,   loss[<span class="number">2</span>])</span><br><span class="line">tf.summary.scalar(<span class="string">&quot;loss/confs_loss&quot;</span>,   loss[<span class="number">3</span>])</span><br><span class="line">tf.summary.scalar(<span class="string">&quot;loss/class_loss&quot;</span>,   loss[<span class="number">4</span>])</span><br><span class="line"></span><br><span class="line">global_step = tf.Variable(<span class="number">0</span>, trainable=<span class="literal">False</span>, collections=[tf.GraphKeys.LOCAL_VARIABLES])</span><br><span class="line">write_op = tf.summary.merge_all()</span><br><span class="line">writer_train = tf.summary.FileWriter(<span class="string">&quot;./checkpoint/summary/train&quot;</span>)</span><br><span class="line">writer_test = tf.summary.FileWriter(<span class="string">&quot;./checkpoint/summary/test&quot;</span>)</span><br><span class="line"></span><br><span class="line"><span class="comment"># 要恢复的权重参数</span></span><br><span class="line">saver_to_restore = tf.train.Saver(var_list=tf.contrib.framework.get_variables_to_restore(</span><br><span class="line">    include=[<span class="string">&quot;yolov3/darknet-53&quot;</span>]))</span><br><span class="line"><span class="comment"># 要更新的网络参数</span></span><br><span class="line">update_vars = tf.contrib.framework.get_variables_to_restore(include=[<span class="string">&quot;yolov3/yolo-v3&quot;</span>])</span><br><span class="line">learning_rate = tf.train.exponential_decay(</span><br><span class="line">    LR, global_step, decay_steps=DECAY_STEPS, decay_rate=DECAY_RATE, staircase=<span class="literal">True</span>)</span><br><span class="line">optimizer = tf.train.AdamOptimizer(learning_rate)</span><br><span class="line"></span><br><span class="line"><span class="comment"># 只更新update_vars网络参数</span></span><br><span class="line">update_ops = tf.get_collection(tf.GraphKeys.UPDATE_OPS)</span><br><span class="line"><span class="keyword">with</span> tf.control_dependencies(update_ops):</span><br><span class="line">    train_op = optimizer.minimize(loss[<span class="number">0</span>], var_list=update_vars, global_step=global_step)</span><br><span class="line"></span><br><span class="line"><span class="comment"># 整个模型的saver</span></span><br><span class="line">saver = tf.train.Saver(max_to_keep=<span class="number">2</span>)</span><br><span class="line"><span class="comment"># sess中的graph为整个模型的graph，很重要，这里如果不指定graph，那么sess的默认graph不会保留saver_to_restore中的节点</span></span><br><span class="line">sess = tf.Session(config=config,graph=graph)</span><br><span class="line"></span><br><span class="line">sess.run([tf.global_variables_initializer(), tf.local_variables_initializer()])</span><br><span class="line"></span><br><span class="line"><span class="comment"># 加载的权重文件位置</span></span><br><span class="line">ckpt = tf.train.get_checkpoint_state(<span class="string">&quot;./checkpoint/ckpt&quot;</span>)</span><br><span class="line">saver_to_restore.restore(sess, ckpt.model_checkpoint_path)</span><br><span class="line"></span><br><span class="line">stem = os.path.splitext(os.path.basename(ckpt.model_checkpoint_path))[-<span class="number">1</span>]</span><br><span class="line">restore_iter = <span class="built_in">int</span>(stem.split(<span class="string">&#x27;-&#x27;</span>)[-<span class="number">1</span>])</span><br><span class="line"></span><br><span class="line"><span class="comment"># 在tensorboard中显示graph</span></span><br><span class="line">writer_train.add_graph(sess.graph)</span><br><span class="line"></span><br><span class="line"><span class="built_in">print</span> <span class="string">&#x27;resotre iter:&#x27;</span>, restore_iter</span><br><span class="line"></span><br><span class="line"><span class="keyword">for</span> step <span class="keyword">in</span> <span class="built_in">range</span>(restore_iter, STEPS):</span><br><span class="line">    run_items = sess.run([train_op, write_op, y_pred, y_true] + loss, feed_dict=&#123;is_training: <span class="literal">True</span>&#125;)</span><br><span class="line"><span class="comment"># 验证步数</span></span><br><span class="line">    <span class="keyword">if</span> (step+<span class="number">1</span>) % EVAL_INTERNAL == <span class="number">0</span>:</span><br><span class="line">        <span class="comment"># calculate recall and precision</span></span><br><span class="line">        train_rec_value, train_prec_value = utils.evaluate(run_items[<span class="number">2</span>], run_items[<span class="number">3</span>])</span><br><span class="line"></span><br><span class="line">    writer_train.add_summary(run_items[<span class="number">1</span>], global_step=step)</span><br><span class="line">    writer_train.flush()  <span class="comment"># Flushes the event file to disk</span></span><br><span class="line">    <span class="comment"># 保存网络权重</span></span><br><span class="line">    <span class="keyword">if</span> (step+<span class="number">1</span>) % SAVE_INTERNAL == <span class="number">0</span>:</span><br><span class="line">        saver.save(sess, save_path=<span class="string">&quot;./checkpoint/ckpt/yolov3.ckpt&quot;</span>, global_step=step + <span class="number">1</span>)</span><br><span class="line">        </span><br></pre></td></tr></table></figure><h2 id="Export-Graph"><a href="#Export-Graph" class="headerlink" title="Export Graph"></a>Export Graph</h2><p>参考文章：</p><p><a href="https://blog.metaflow.fr/tensorflow-how-to-freeze-a-model-and-serve-it-with-a-python-api-d4f3596b3adc">https://blog.metaflow.fr/tensorflow-how-to-freeze-a-model-and-serve-it-with-a-python-api-d4f3596b3adc</a></p><p><a href="https://blog.csdn.net/guyuealian/article/details/82218092">https://blog.csdn.net/guyuealian/article/details/82218092</a></p><p>当训练好模型之后，默认会得到一些训练的权重文件</p><img src="/2019/03/19/DeepLearning_Tensorflow/ckpt.png" class="" title="模型训练得到的权重参数"><ul><li>checkpoint文件保存着模型文件的路径</li></ul><img src="/2019/03/19/DeepLearning_Tensorflow/checkpoint.png" class="" title="checkpoint下保存的权重文件路径"><ul><li>model.ckpt.meta保存了TensorFlow计算图的结构信息</li><li>model.ckpt保存每个变量的取值，此处文件名的写入方式会因不同参数的设置而不同，加载restore时的文件路径名是以checkpoint文件中的“model_checkpoint_path”值决定的</li></ul><p>在ckpt文件夹下面，存储着的信息包含着整个模型的全部信息，这些信息很显然是可以进行模型的重新加载的，但是有一些信息是没必要的，尤其是在进行测试阶段的时候，在inference的时候，只需要加载已经训练好的权重参数即可，该阶段只有正向传播，没有反向传播过程，只需要告诉模型如何输入如何输出即可，不再需要想训练阶段那样要进行模型初始化，模型保存，优化参数等设置。在tensorflow中推荐将模型进行固化的方式，只保留模型的参数。</p><p>具体实现代码为</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br><span class="line">51</span><br><span class="line">52</span><br><span class="line">53</span><br><span class="line">54</span><br><span class="line">55</span><br><span class="line">56</span><br><span class="line">57</span><br><span class="line">58</span><br><span class="line">59</span><br><span class="line">60</span><br><span class="line">61</span><br><span class="line">62</span><br><span class="line">63</span><br><span class="line">64</span><br><span class="line">65</span><br><span class="line">66</span><br><span class="line">67</span><br><span class="line">68</span><br><span class="line">69</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">import</span> os, argparse</span><br><span class="line"></span><br><span class="line"><span class="keyword">import</span> tensorflow <span class="keyword">as</span> tf</span><br><span class="line"></span><br><span class="line"><span class="comment"># The original freeze_graph function</span></span><br><span class="line"><span class="comment"># from tensorflow.python.tools.freeze_graph import freeze_graph </span></span><br><span class="line"></span><br><span class="line"><span class="built_in">dir</span> = os.path.dirname(os.path.realpath(__file__))</span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">freeze_graph</span>(<span class="params">model_dir, output_node_names</span>):</span><br><span class="line">    <span class="string">&quot;&quot;&quot;Extract the sub graph defined by the output nodes and convert </span></span><br><span class="line"><span class="string">    all its variables into constant </span></span><br><span class="line"><span class="string">    Args:</span></span><br><span class="line"><span class="string">        model_dir: the root folder containing the checkpoint state file</span></span><br><span class="line"><span class="string">        output_node_names: a string, containing all the output node&#x27;s names, </span></span><br><span class="line"><span class="string">                            comma separated</span></span><br><span class="line"><span class="string">    &quot;&quot;&quot;</span></span><br><span class="line">    <span class="keyword">if</span> <span class="keyword">not</span> tf.gfile.Exists(model_dir):</span><br><span class="line">        <span class="keyword">raise</span> AssertionError(</span><br><span class="line">            <span class="string">&quot;Export directory doesn&#x27;t exists. Please specify an export &quot;</span></span><br><span class="line">            <span class="string">&quot;directory: %s&quot;</span> % model_dir)</span><br><span class="line"></span><br><span class="line">    <span class="keyword">if</span> <span class="keyword">not</span> output_node_names:</span><br><span class="line">        <span class="built_in">print</span>(<span class="string">&quot;You need to supply the name of a node to --output_node_names.&quot;</span>)</span><br><span class="line">        <span class="keyword">return</span> -<span class="number">1</span></span><br><span class="line"></span><br><span class="line">    <span class="comment"># We retrieve our checkpoint fullpath</span></span><br><span class="line">    checkpoint = tf.train.get_checkpoint_state(model_dir)</span><br><span class="line">    input_checkpoint = checkpoint.model_checkpoint_path</span><br><span class="line">    </span><br><span class="line">    <span class="comment"># We precise the file fullname of our freezed graph</span></span><br><span class="line">    absolute_model_dir = <span class="string">&quot;/&quot;</span>.join(input_checkpoint.split(<span class="string">&#x27;/&#x27;</span>)[:-<span class="number">1</span>])</span><br><span class="line">    output_graph = absolute_model_dir + <span class="string">&quot;/frozen_model.pb&quot;</span></span><br><span class="line"></span><br><span class="line">    <span class="comment"># We clear devices to allow TensorFlow to control on which device it will load operations</span></span><br><span class="line">    <span class="comment"># if have cpu and gpu, we can load this graph on each device</span></span><br><span class="line">    clear_devices = <span class="literal">True</span></span><br><span class="line">    <span class="comment"># We import the meta graph in the current default Graph</span></span><br><span class="line">saver = tf.train.import_meta_graph(input_checkpoint + <span class="string">&#x27;.meta&#x27;</span>, clear_devices=clear_devices)</span><br><span class="line">    <span class="comment"># We start a session using a temporary fresh Graph</span></span><br><span class="line">    graph=tf.get_default_graph()</span><br><span class="line">    </span><br><span class="line">    <span class="keyword">with</span> tf.Session(graph=graph) <span class="keyword">as</span> sess:</span><br><span class="line">      <span class="comment"># 模型初始化</span></span><br><span class="line">        sess.run(tf.global_variables_initializer())</span><br><span class="line">        <span class="comment"># We restore the weights</span></span><br><span class="line">        saver.restore(sess, input_checkpoint)</span><br><span class="line"></span><br><span class="line">        <span class="comment"># We use a built-in TF helper to export variables to constants</span></span><br><span class="line">        output_graph_def = tf.graph_util.convert_variables_to_constants(</span><br><span class="line">            sess, <span class="comment"># The session is used to retrieve the weights</span></span><br><span class="line">            graph.as_graph_def(), <span class="comment"># The graph_def is used to retrieve the nodes </span></span><br><span class="line">            output_node_names.split(<span class="string">&quot;,&quot;</span>) <span class="comment"># The output node names are used to select the usefull nodes</span></span><br><span class="line">        ) </span><br><span class="line"></span><br><span class="line">        <span class="comment"># Finally we serialize and dump the output graph to the filesystem</span></span><br><span class="line">        <span class="keyword">with</span> tf.gfile.GFile(output_graph, <span class="string">&quot;wb&quot;</span>) <span class="keyword">as</span> f:</span><br><span class="line">            f.write(output_graph_def.SerializeToString())</span><br><span class="line">        <span class="built_in">print</span>(<span class="string">&quot;%d ops in the final graph.&quot;</span> % <span class="built_in">len</span>(output_graph_def.node))</span><br><span class="line"></span><br><span class="line">    <span class="keyword">return</span> output_graph_def</span><br><span class="line"></span><br><span class="line"><span class="keyword">if</span> __name__ == <span class="string">&#x27;__main__&#x27;</span>:</span><br><span class="line">    parser = argparse.ArgumentParser()</span><br><span class="line">    parser.add_argument(<span class="string">&quot;--model_dir&quot;</span>, <span class="built_in">type</span>=<span class="built_in">str</span>, default=<span class="string">&quot;&quot;</span>, <span class="built_in">help</span>=<span class="string">&quot;Model folder to export&quot;</span>)</span><br><span class="line">    parser.add_argument(<span class="string">&quot;--output_node_names&quot;</span>, <span class="built_in">type</span>=<span class="built_in">str</span>, default=<span class="string">&quot;&quot;</span>, <span class="built_in">help</span>=<span class="string">&quot;The name of the output nodes, comma separated.&quot;</span>)</span><br><span class="line">    args = parser.parse_args()</span><br><span class="line"></span><br><span class="line">    freeze_graph(args.model_dir, args.output_node_names)</span><br></pre></td></tr></table></figure><p>上述代码可以完成将ckpt中文件的固化，并输出<code>frozen_model.pb</code>文件，该文件中保存着模型的参数。</p><p>那么如何加载已经固化的文件呢？代码如下</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">import</span> tensorflow <span class="keyword">as</span> tf</span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">load_graph</span>(<span class="params">frozen_graph_filename</span>):</span><br><span class="line">    <span class="comment"># We load the protobuf file from the disk and parse it to retrieve the </span></span><br><span class="line">    <span class="comment"># unserialized graph_def</span></span><br><span class="line">    <span class="keyword">with</span> tf.gfile.GFile(frozen_graph_filename, <span class="string">&quot;rb&quot;</span>) <span class="keyword">as</span> f:</span><br><span class="line">        graph_def = tf.GraphDef()</span><br><span class="line">        graph_def.ParseFromString(f.read())</span><br><span class="line"></span><br><span class="line">    <span class="comment"># Then, we import the graph_def into a new Graph and returns it </span></span><br><span class="line">    <span class="keyword">with</span> tf.Graph().as_default() <span class="keyword">as</span> graph:</span><br><span class="line">        <span class="comment"># The name var will prefix every op/nodes in your graph</span></span><br><span class="line">        <span class="comment"># Since we load everything in a new graph, this is not needed</span></span><br><span class="line">        tf.import_graph_def(graph_def, name=<span class="string">&quot;prefix&quot;</span>)</span><br><span class="line">    <span class="keyword">return</span> graph</span><br></pre></td></tr></table></figure><p>加载<code>*.pb</code>文件并返回模型的graph</p><h2 id="下载数据集COCO-VOC"><a href="#下载数据集COCO-VOC" class="headerlink" title="下载数据集COCO&amp;VOC"></a>下载数据集COCO&amp;VOC</h2><ul><li><p>VOC数据集地址</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">wget http://host.robots.ox.ac.uk/pascal/VOC/voc2007/VOCtrainval_06-Nov-2007.tar</span><br><span class="line">wget http://host.robots.ox.ac.uk/pascal/VOC/voc2012/VOCtrainval_11-May-2012.tar</span><br><span class="line">wget http://host.robots.ox.ac.uk/pascal/VOC/voc2007/VOCtest_06-Nov-2007.tar</span><br></pre></td></tr></table></figure></li><li><p>COCO数据集</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line">wget http://images.cocodataset.org/zips/train2017.zip</span><br><span class="line">wget http://images.cocodataset.org/annotations/annotations_trainval2017.zip</span><br><span class="line">wget http://images.cocodataset.org/zips/test2017.zip</span><br><span class="line">wget http://images.cocodataset.org/annotations/image_info_test2017.zip </span><br></pre></td></tr></table></figure></li><li><p>代码实现</p><p>Reference  from tensorflow model</p></li></ul><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">#! /usr/bin/env python</span></span><br><span class="line"><span class="comment"># coding=utf-8</span></span><br><span class="line"></span><br><span class="line"><span class="keyword">import</span> six.moves.urllib <span class="keyword">as</span> urllib</span><br><span class="line"><span class="keyword">import</span> tarfile</span><br><span class="line"><span class="keyword">import</span> zipfile</span><br><span class="line"></span><br><span class="line">MODEL_NAME=<span class="string">&#x27;ssd_mobilenet_v2_oid_v4_2018_12_12&#x27;</span></span><br><span class="line">MODEL_FILE = MODEL_NAME + <span class="string">&#x27;.tar.gz&#x27;</span></span><br><span class="line">DOWNLOAD_BASE = <span class="string">&#x27;http://download.tensorflow.org/models/object_detection/&#x27;</span></span><br><span class="line"><span class="built_in">print</span> <span class="string">&#x27;model name is:&#x27;</span>, MODEL_FILE</span><br><span class="line"><span class="comment"># Path to frozen detection graph. This is the actual model that is used for the object detection.</span></span><br><span class="line">opener = urllib.request.URLopener()</span><br><span class="line">opener.retrieve(DOWNLOAD_BASE + MODEL_FILE, MODEL_FILE)</span><br><span class="line">tar_file = tarfile.<span class="built_in">open</span>(MODEL_FILE)</span><br><span class="line"><span class="keyword">for</span> file <span class="keyword">in</span> tar_file.getmembers():</span><br><span class="line">  file_name = os.path.basename(file.name)</span><br><span class="line">  <span class="keyword">if</span> <span class="string">&#x27;frozen_inference_graph.pb&#x27;</span> <span class="keyword">in</span> file_name:</span><br><span class="line">    tar_file.extract(file, os.getcwd())</span><br><span class="line"></span><br></pre></td></tr></table></figure><p>Use the wget</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br><span class="line">51</span><br><span class="line">52</span><br><span class="line">53</span><br><span class="line">54</span><br><span class="line">55</span><br><span class="line">56</span><br><span class="line">57</span><br><span class="line">58</span><br><span class="line">59</span><br><span class="line">60</span><br><span class="line">61</span><br><span class="line">62</span><br><span class="line">63</span><br><span class="line">64</span><br><span class="line">65</span><br><span class="line">66</span><br><span class="line">67</span><br><span class="line">68</span><br><span class="line">69</span><br><span class="line">70</span><br><span class="line">71</span><br><span class="line">72</span><br><span class="line">73</span><br><span class="line">74</span><br><span class="line">75</span><br><span class="line">76</span><br><span class="line">77</span><br><span class="line">78</span><br><span class="line">79</span><br><span class="line">80</span><br><span class="line">81</span><br><span class="line">82</span><br><span class="line">83</span><br><span class="line">84</span><br><span class="line">85</span><br><span class="line">86</span><br><span class="line">87</span><br><span class="line">88</span><br><span class="line">89</span><br><span class="line">90</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">#! /usr/bin/env python</span></span><br><span class="line"><span class="comment"># coding=utf-8</span></span><br><span class="line"></span><br><span class="line"><span class="keyword">import</span> zipfile</span><br><span class="line"><span class="keyword">import</span> tarfile</span><br><span class="line"><span class="keyword">import</span> time</span><br><span class="line"><span class="keyword">import</span> wget</span><br><span class="line"><span class="keyword">import</span> sys</span><br><span class="line"><span class="keyword">import</span> os</span><br><span class="line"><span class="keyword">import</span> argparse</span><br><span class="line"></span><br><span class="line"><span class="comment"># VOC urls</span></span><br><span class="line"><span class="string">&quot;&quot;&quot;</span></span><br><span class="line"><span class="string">wget http://host.robots.ox.ac.uk/pascal/VOC/voc2007/VOCtrainval_06-Nov-2007.tar</span></span><br><span class="line"><span class="string">wget http://host.robots.ox.ac.uk/pascal/VOC/voc2012/VOCtrainval_11-May-2012.tar</span></span><br><span class="line"><span class="string">wget http://host.robots.ox.ac.uk/pascal/VOC/voc2007/VOCtest_06-Nov-2007.tar</span></span><br><span class="line"><span class="string">&quot;&quot;&quot;</span></span><br><span class="line"></span><br><span class="line"><span class="comment"># COCO urls</span></span><br><span class="line"><span class="string">&quot;&quot;&quot;</span></span><br><span class="line"><span class="string">wget http://images.cocodataset.org/zips/train2017.zip</span></span><br><span class="line"><span class="string">wget http://images.cocodataset.org/annotations/annotations_trainval2017.zip</span></span><br><span class="line"><span class="string">wget http://images.cocodataset.org/zips/test2017.zip</span></span><br><span class="line"><span class="string">wget http://images.cocodataset.org/annotations/image_info_test2017.zip </span></span><br><span class="line"><span class="string">&quot;&quot;&quot;</span></span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">class</span> <span class="title class_">parser</span>(argparse.ArgumentParser):</span><br><span class="line"></span><br><span class="line">    <span class="keyword">def</span> <span class="title function_">__init__</span>(<span class="params">self, description</span>):</span><br><span class="line">        <span class="built_in">super</span>(parser, self).__init__(description)</span><br><span class="line"></span><br><span class="line">        self.add_argument(</span><br><span class="line">            <span class="string">&quot;--dataset&quot;</span>, <span class="string">&quot;-data&quot;</span>, default=<span class="string">&#x27;voc&#x27;</span>, <span class="built_in">type</span>=<span class="built_in">str</span>, choices=&#123;<span class="string">&#x27;voc&#x27;</span>, <span class="string">&#x27;coco&#x27;</span>&#125;,</span><br><span class="line">            <span class="built_in">help</span>=<span class="string">&quot;[default: %(default)s] The type  of dataset ...&quot;</span></span><br><span class="line">        )</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">voc_url = [<span class="string">&#x27;http://host.robots.ox.ac.uk/pascal/VOC/voc2007/VOCtrainval_06-Nov-2007.tar&#x27;</span>,</span><br><span class="line">           <span class="string">&#x27;http://host.robots.ox.ac.uk/pascal/VOC/voc2012/VOCtrainval_11-May-2012.tar&#x27;</span>,</span><br><span class="line">           <span class="string">&#x27;http://host.robots.ox.ac.uk/pascal/VOC/voc2007/VOCtest_06-Nov-2007.tar&#x27;</span>]</span><br><span class="line"></span><br><span class="line">coco_url = [<span class="string">&#x27;http://images.cocodataset.org/zips/train2017.zip&#x27;</span>,</span><br><span class="line">            <span class="string">&#x27;http://images.cocodataset.org/annotations/annotations_trainval2017.zip&#x27;</span>,</span><br><span class="line">            <span class="string">&#x27;http://images.cocodataset.org/zips/test2017.zip&#x27;</span>,</span><br><span class="line">            <span class="string">&#x27;http://images.cocodataset.org/annotations/image_info_test2017.zip&#x27;</span>]</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">main</span>(<span class="params">args</span>):</span><br><span class="line">    flags = parser(description=<span class="string">&quot;Download dataset&quot;</span>).parse_args()</span><br><span class="line">    <span class="keyword">if</span> flags.dataset == <span class="string">&#x27;voc&#x27;</span>:</span><br><span class="line">        saved_path = [os.path.join(<span class="string">&#x27;/data00/home/shixiaofeng/data&#x27;</span>, <span class="string">&#x27;voc&#x27;</span>)]</span><br><span class="line">        urls = voc_url</span><br><span class="line">    <span class="keyword">elif</span> flags.dataset == <span class="string">&#x27;coco&#x27;</span>:</span><br><span class="line">        saved_path = [os.path.join(<span class="string">&#x27;/data00/home/shixiaofeng/data&#x27;</span>, <span class="string">&#x27;coco&#x27;</span>)]</span><br><span class="line">        urls = coco_url</span><br><span class="line">    <span class="keyword">else</span>:</span><br><span class="line">        saved_path = [os.path.join(<span class="string">&#x27;/data00/home/shixiaofeng/data&#x27;</span>, <span class="string">&#x27;voc&#x27;</span>),</span><br><span class="line">                      os.path.join(<span class="string">&#x27;/data00/home/shixiaofeng/data&#x27;</span>, <span class="string">&#x27;coco&#x27;</span>)]</span><br><span class="line">        urls = [voc_url, coco_url]</span><br><span class="line">    <span class="keyword">for</span> _path <span class="keyword">in</span> saved_path:</span><br><span class="line">        <span class="keyword">if</span> <span class="keyword">not</span> os.path.exists(_path):</span><br><span class="line">            os.makedirs(_path)</span><br><span class="line">    <span class="keyword">for</span> _path <span class="keyword">in</span> saved_path:</span><br><span class="line">        <span class="keyword">for</span> url <span class="keyword">in</span> urls:</span><br><span class="line">            DATA_NAME = url.split(<span class="string">&#x27;/&#x27;</span>)[-<span class="number">1</span>]</span><br><span class="line">            <span class="built_in">print</span> <span class="string">&#x27;Downloading %s&#x27;</span> % DATA_NAME</span><br><span class="line">            DATA_FILE = os.path.join(_path, DATA_NAME)</span><br><span class="line">            <span class="built_in">print</span> <span class="string">&#x27;Download the file to : %s&#x27;</span> %DATA_FILE</span><br><span class="line">            wget.download(url, DATA_FILE)</span><br><span class="line">            <span class="keyword">try</span>:</span><br><span class="line">                <span class="keyword">if</span> url.split(<span class="string">&#x27;.&#x27;</span>)[-<span class="number">1</span>] == <span class="string">&#x27;tar&#x27;</span>:</span><br><span class="line">                    tar_file = tarfile.<span class="built_in">open</span>(DATA_FILE)</span><br><span class="line">                    <span class="keyword">for</span> file_name <span class="keyword">in</span> tar_file.getnames():</span><br><span class="line">                        tar_file.extract(file_name, _path)</span><br><span class="line">                    tar_file.close()</span><br><span class="line"></span><br><span class="line">                <span class="keyword">elif</span> url.split(<span class="string">&#x27;.&#x27;</span>)[-<span class="number">1</span>] == <span class="string">&#x27;zip&#x27;</span>:</span><br><span class="line">                    zip_file = zipfile.ZipFile(DATA_FILE)</span><br><span class="line">                    <span class="keyword">for</span> file_name <span class="keyword">in</span> zip_file.namelist():</span><br><span class="line">                        zip_file.extract(file_name, _path)</span><br><span class="line">                    zip_file.close()</span><br><span class="line"></span><br><span class="line">            <span class="keyword">except</span> Exception <span class="keyword">as</span> e:</span><br><span class="line">                <span class="built_in">print</span> e</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">if</span> __name__ == <span class="string">&quot;__main__&quot;</span>:</span><br><span class="line">    main(sys.argv[<span class="number">1</span>:])</span><br><span class="line"></span><br></pre></td></tr></table></figure><p>直接执行</p><figure class="highlight bash"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">python xxx.py --dataset coco </span><br></pre></td></tr></table></figure><p>可以直接下载coco数据集到设置的位置，并将数据集解压缩</p><h2 id="OpenImage-下载"><a href="#OpenImage-下载" class="headerlink" title="OpenImage 下载"></a>OpenImage 下载</h2><p>由于OpenImage文件较多，单次下载非常慢，特此保存一个下载脚本，输入想要的模型名称，下载openimage中对应的数据图片和标注信息</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br><span class="line">51</span><br><span class="line">52</span><br><span class="line">53</span><br><span class="line">54</span><br><span class="line">55</span><br><span class="line">56</span><br><span class="line">57</span><br><span class="line">58</span><br><span class="line">59</span><br><span class="line">60</span><br><span class="line">61</span><br><span class="line">62</span><br><span class="line">63</span><br><span class="line">64</span><br><span class="line">65</span><br><span class="line">66</span><br><span class="line">67</span><br><span class="line">68</span><br><span class="line">69</span><br><span class="line">70</span><br><span class="line">71</span><br><span class="line">72</span><br><span class="line">73</span><br><span class="line">74</span><br><span class="line">75</span><br><span class="line">76</span><br><span class="line">77</span><br><span class="line">78</span><br><span class="line">79</span><br><span class="line">80</span><br><span class="line">81</span><br><span class="line">82</span><br><span class="line">83</span><br><span class="line">84</span><br><span class="line">85</span><br><span class="line">86</span><br><span class="line">87</span><br><span class="line">88</span><br><span class="line">89</span><br><span class="line">90</span><br><span class="line">91</span><br><span class="line">92</span><br><span class="line">93</span><br><span class="line">94</span><br><span class="line">95</span><br><span class="line">96</span><br><span class="line">97</span><br><span class="line">98</span><br><span class="line">99</span><br><span class="line">100</span><br><span class="line">101</span><br><span class="line">102</span><br><span class="line">103</span><br><span class="line">104</span><br><span class="line">105</span><br><span class="line">106</span><br><span class="line">107</span><br><span class="line">108</span><br><span class="line">109</span><br><span class="line">110</span><br><span class="line">111</span><br><span class="line">112</span><br><span class="line">113</span><br><span class="line">114</span><br><span class="line">115</span><br><span class="line">116</span><br><span class="line">117</span><br><span class="line">118</span><br><span class="line">119</span><br><span class="line">120</span><br><span class="line">121</span><br><span class="line">122</span><br><span class="line">123</span><br><span class="line">124</span><br><span class="line">125</span><br><span class="line">126</span><br><span class="line">127</span><br><span class="line">128</span><br><span class="line">129</span><br><span class="line">130</span><br><span class="line">131</span><br><span class="line">132</span><br><span class="line">133</span><br><span class="line">134</span><br><span class="line">135</span><br><span class="line">136</span><br><span class="line">137</span><br><span class="line">138</span><br><span class="line">139</span><br><span class="line">140</span><br><span class="line">141</span><br><span class="line">142</span><br><span class="line">143</span><br><span class="line">144</span><br><span class="line">145</span><br><span class="line">146</span><br><span class="line">147</span><br><span class="line">148</span><br><span class="line">149</span><br><span class="line">150</span><br><span class="line">151</span><br><span class="line">152</span><br><span class="line">153</span><br><span class="line">154</span><br><span class="line">155</span><br><span class="line">156</span><br><span class="line">157</span><br><span class="line">158</span><br><span class="line">159</span><br><span class="line">160</span><br><span class="line">161</span><br><span class="line">162</span><br><span class="line">163</span><br><span class="line">164</span><br><span class="line">165</span><br><span class="line">166</span><br><span class="line">167</span><br><span class="line">168</span><br><span class="line">169</span><br><span class="line">170</span><br><span class="line">171</span><br><span class="line">172</span><br><span class="line">173</span><br><span class="line">174</span><br><span class="line">175</span><br><span class="line">176</span><br><span class="line">177</span><br><span class="line">178</span><br><span class="line">179</span><br><span class="line">180</span><br><span class="line">181</span><br><span class="line">182</span><br><span class="line">183</span><br><span class="line">184</span><br><span class="line">185</span><br><span class="line">186</span><br><span class="line">187</span><br><span class="line">188</span><br><span class="line">189</span><br><span class="line">190</span><br><span class="line">191</span><br><span class="line">192</span><br><span class="line">193</span><br><span class="line">194</span><br><span class="line">195</span><br><span class="line">196</span><br><span class="line">197</span><br><span class="line">198</span><br><span class="line">199</span><br><span class="line">200</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">import</span> time</span><br><span class="line"><span class="keyword">import</span> boto3</span><br><span class="line"><span class="keyword">from</span> botocore <span class="keyword">import</span> UNSIGNED</span><br><span class="line"><span class="keyword">from</span> botocore.config <span class="keyword">import</span> Config</span><br><span class="line"><span class="keyword">import</span> botocore</span><br><span class="line"><span class="keyword">import</span> logging</span><br><span class="line"><span class="keyword">from</span> multiprocessing <span class="keyword">import</span> Pool, Manager</span><br><span class="line"><span class="keyword">import</span> pandas <span class="keyword">as</span> pd</span><br><span class="line"><span class="keyword">import</span> os</span><br><span class="line"><span class="keyword">import</span> argparse</span><br><span class="line"><span class="keyword">import</span> sys</span><br><span class="line"><span class="keyword">import</span> functools</span><br><span class="line"><span class="keyword">from</span> urllib <span class="keyword">import</span> request</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">s3 = boto3.client(<span class="string">&#x27;s3&#x27;</span>, config=Config(signature_version=UNSIGNED))</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">download</span>(<span class="params">bucket, root, retry, counter, lock, path</span>):</span><br><span class="line">    i = <span class="number">0</span></span><br><span class="line">    src = path</span><br><span class="line">    dest = <span class="string">&quot;&#123;root&#125;/&#123;path&#125;&quot;</span>.<span class="built_in">format</span>(root=root, path=path)</span><br><span class="line">    <span class="keyword">while</span> i &lt; retry:</span><br><span class="line">        <span class="keyword">try</span>:</span><br><span class="line">            <span class="keyword">if</span> <span class="keyword">not</span> os.path.exists(dest):</span><br><span class="line">                s3.download_file(bucket, src, dest)</span><br><span class="line">            <span class="keyword">else</span>:</span><br><span class="line">                logging.info(<span class="string">&quot;&#123;dest&#125; already exists.&quot;</span>.<span class="built_in">format</span>(dest=dest))</span><br><span class="line">            <span class="keyword">with</span> lock:</span><br><span class="line">                counter.value += <span class="number">1</span></span><br><span class="line">                <span class="keyword">if</span> counter.value % <span class="number">100</span> == <span class="number">0</span>:</span><br><span class="line">                    logging.warning(<span class="string">&quot;Downloaded &#123;&#125; images: &#123;&#125;&quot;</span>.<span class="built_in">format</span>(counter.value,dest))</span><br><span class="line">            <span class="keyword">return</span></span><br><span class="line">        <span class="keyword">except</span> botocore.exceptions.ClientError <span class="keyword">as</span> e:</span><br><span class="line">            <span class="keyword">if</span> e.response[<span class="string">&#x27;Error&#x27;</span>][<span class="string">&#x27;Code&#x27;</span>] == <span class="string">&quot;404&quot;</span>:</span><br><span class="line">                logging.warning(<span class="string">&quot;The file s3://&#123;bucket&#125;/&#123;src&#125; does not exist.&quot;</span>.<span class="built_in">format</span>(bucket=bucket,src=src))</span><br><span class="line">                <span class="keyword">return</span></span><br><span class="line">            i += <span class="number">1</span></span><br><span class="line">            logging.warning(<span class="string">&quot;Sleep &#123;i&#125; and try again.&quot;</span>.<span class="built_in">format</span>(i))</span><br><span class="line">            time.sleep(i)</span><br><span class="line">    logging.warning(<span class="string">&quot;Failed to download the file s3://&#123;bucket&#125;/&#123;src&#125;. Exception: &#123;e&#125;&quot;</span>.<span class="built_in">format</span>(bucket=bucket,src=src,e=e))</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">batch_download</span>(<span class="params">bucket, file_paths, root, num_workers=<span class="number">10</span>, retry=<span class="number">10</span></span>):</span><br><span class="line">    <span class="keyword">with</span> Pool(num_workers) <span class="keyword">as</span> p:</span><br><span class="line">        m = Manager()</span><br><span class="line">        counter = m.Value(<span class="string">&#x27;i&#x27;</span>, <span class="number">0</span>)</span><br><span class="line">        lock = m.Lock()</span><br><span class="line">        download_ = functools.partial(download, bucket, root, retry, counter, lock)</span><br><span class="line">        p.<span class="built_in">map</span>(download_, file_paths)</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">http_download</span>(<span class="params">url, path</span>):</span><br><span class="line">    <span class="keyword">with</span> request.urlopen(url) <span class="keyword">as</span> f:</span><br><span class="line">        <span class="keyword">with</span> <span class="built_in">open</span>(path, <span class="string">&quot;wb&quot;</span>) <span class="keyword">as</span> fout:</span><br><span class="line">            buf = f.read(<span class="number">1024</span>)</span><br><span class="line">            <span class="keyword">while</span> buf:</span><br><span class="line">                fout.write(buf)</span><br><span class="line">                buf = f.read(<span class="number">1024</span>)</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">log_counts</span>(<span class="params">values</span>):</span><br><span class="line">    <span class="keyword">for</span> k, count <span class="keyword">in</span> values.value_counts().iteritems():</span><br><span class="line">        logging.warning(<span class="string">&quot;&#123;&#125;: &#123;&#125;/&#123;&#125; = &#123;:.8f&#125;.&quot;</span>.<span class="built_in">format</span>(k,count,<span class="built_in">len</span>(values),count/<span class="built_in">len</span>(values)))</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">parse_args</span>():</span><br><span class="line">    parser = argparse.ArgumentParser(</span><br><span class="line">        description=<span class="string">&#x27;Dowload open image dataset by class.&#x27;</span>)</span><br><span class="line"></span><br><span class="line">    parser.add_argument(<span class="string">&quot;--root&quot;</span>, <span class="built_in">type</span>=<span class="built_in">str</span>,</span><br><span class="line">                        <span class="built_in">help</span>=<span class="string">&#x27;The root directory that you want to store the open image data.&#x27;</span>)</span><br><span class="line">    parser.add_argument(<span class="string">&quot;include_depiction&quot;</span>, action=<span class="string">&quot;store_true&quot;</span>,</span><br><span class="line">                        <span class="built_in">help</span>=<span class="string">&quot;Do you want to include drawings or depictions?&quot;</span>)</span><br><span class="line">    parser.add_argument(<span class="string">&quot;--class_names&quot;</span>, <span class="built_in">type</span>=<span class="built_in">str</span>,</span><br><span class="line">                        <span class="built_in">help</span>=<span class="string">&quot;the classes you want to download.&quot;</span>)</span><br><span class="line">    parser.add_argument(<span class="string">&quot;--class_names_file&quot;</span>, <span class="built_in">type</span>=<span class="built_in">str</span>,</span><br><span class="line">                        <span class="built_in">help</span>=<span class="string">&quot;the classes you want to download.&quot;</span>)</span><br><span class="line">    parser.add_argument(<span class="string">&quot;--num_workers&quot;</span>, <span class="built_in">type</span>=<span class="built_in">int</span>, default=<span class="number">10</span>,</span><br><span class="line">                        <span class="built_in">help</span>=<span class="string">&quot;the classes you want to download.&quot;</span>)</span><br><span class="line">    parser.add_argument(<span class="string">&quot;--retry&quot;</span>, <span class="built_in">type</span>=<span class="built_in">int</span>, default=<span class="number">10</span>,</span><br><span class="line">                        <span class="built_in">help</span>=<span class="string">&quot;retry times when downloading.&quot;</span>)</span><br><span class="line">    parser.add_argument(<span class="string">&quot;--filter_file&quot;</span>, <span class="built_in">type</span>=<span class="built_in">str</span>, default=<span class="string">&quot;&quot;</span>,</span><br><span class="line">                        <span class="built_in">help</span>=<span class="string">&quot;This file specifies the image ids you want to exclude.&quot;</span>)</span><br><span class="line">    parser.add_argument(<span class="string">&#x27;--remove_overlapped&#x27;</span>, action=<span class="string">&#x27;store_true&#x27;</span>,</span><br><span class="line">                        <span class="built_in">help</span>=<span class="string">&quot;Remove single boxes covered by group boxes.&quot;</span>)</span><br><span class="line">    <span class="keyword">return</span> parser.parse_args()</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">if</span> __name__ == <span class="string">&#x27;__main__&#x27;</span>:</span><br><span class="line">    logging.basicConfig(stream=sys.stdout, level=logging.WARNING,</span><br><span class="line">                        <span class="built_in">format</span>=<span class="string">&#x27;%(asctime)s - %(name)s - %(message)s&#x27;</span>)</span><br><span class="line"></span><br><span class="line">    args = parse_args()</span><br><span class="line">    bucket = <span class="string">&quot;open-images-dataset&quot;</span></span><br><span class="line">    names = [e.strip() <span class="keyword">for</span> e <span class="keyword">in</span> args.class_names.split(<span class="string">&quot;,&quot;</span>)]</span><br><span class="line">    class_names = []</span><br><span class="line">    group_filters = []</span><br><span class="line">    percentages = []</span><br><span class="line">    <span class="keyword">for</span> name <span class="keyword">in</span> names:</span><br><span class="line">        t = name.split(<span class="string">&quot;:&quot;</span>)</span><br><span class="line">        class_names.append(t[<span class="number">0</span>].strip())</span><br><span class="line">        <span class="keyword">if</span> <span class="built_in">len</span>(t) &gt;= <span class="number">2</span> <span class="keyword">and</span> t[<span class="number">1</span>].strip():</span><br><span class="line">            group_filters.append(t[<span class="number">1</span>].strip())</span><br><span class="line">        <span class="keyword">else</span>:</span><br><span class="line">            group_filters.append(<span class="string">&quot;&quot;</span>)</span><br><span class="line">        <span class="keyword">if</span> <span class="built_in">len</span>(t) &gt;= <span class="number">3</span> <span class="keyword">and</span> t[<span class="number">2</span>].strip():</span><br><span class="line">            percentages.append(<span class="built_in">float</span>(t[<span class="number">2</span>].strip()))</span><br><span class="line">        <span class="keyword">else</span>:</span><br><span class="line">            percentages.append(<span class="number">1.0</span>)</span><br><span class="line"></span><br><span class="line">    <span class="keyword">if</span> <span class="keyword">not</span> os.path.exists(args.root):</span><br><span class="line">        os.makedirs(args.root)</span><br><span class="line"></span><br><span class="line">    excluded_images = <span class="built_in">set</span>()</span><br><span class="line">    <span class="keyword">if</span> args.filter_file:</span><br><span class="line">        <span class="keyword">for</span> line <span class="keyword">in</span> <span class="built_in">open</span>(args.filter_file):</span><br><span class="line">            img_id = line.strip()</span><br><span class="line">            <span class="keyword">if</span> <span class="keyword">not</span> img_id:</span><br><span class="line">                <span class="keyword">continue</span></span><br><span class="line">            excluded_images.add(img_id)</span><br><span class="line"></span><br><span class="line">    class_description_file = os.path.join(args.root, <span class="string">&quot;class-descriptions-boxable.csv&quot;</span>)</span><br><span class="line">    <span class="keyword">if</span> <span class="keyword">not</span> os.path.exists(class_description_file):</span><br><span class="line">        url = <span class="string">&quot;https://storage.googleapis.com/openimages/2018_04/class-descriptions-boxable.csv&quot;</span></span><br><span class="line">        logging.warning(<span class="string">&quot;Download &#123;url&#125;.&quot;</span>.<span class="built_in">format</span>(url=url))</span><br><span class="line">        http_download(url, class_description_file)</span><br><span class="line"></span><br><span class="line">    class_descriptions = pd.read_csv(class_description_file,</span><br><span class="line">                                    names=[<span class="string">&quot;id&quot;</span>, <span class="string">&quot;ClassName&quot;</span>])</span><br><span class="line">    </span><br><span class="line">    class_names=[]</span><br><span class="line">    <span class="keyword">for</span> line <span class="keyword">in</span> <span class="built_in">open</span>(args.class_names_file, <span class="string">&#x27;r&#x27;</span>).readlines():</span><br><span class="line">        x=line.strip().split(<span class="string">&#x27;/&#x27;</span>) </span><br><span class="line">        x = [i.capitalize() <span class="keyword">for</span> i <span class="keyword">in</span> x]</span><br><span class="line">        class_names.extend(x)</span><br><span class="line">        </span><br><span class="line">    class_names = <span class="built_in">list</span>(<span class="built_in">set</span>(class_names))</span><br><span class="line">    </span><br><span class="line">    class_descriptions = class_descriptions[class_descriptions[<span class="string">&#x27;ClassName&#x27;</span>].isin(class_names)]</span><br><span class="line">    <span class="built_in">print</span>(<span class="string">&#x27;class_descriptions&#x27;</span>,class_descriptions)</span><br><span class="line">    image_files = []</span><br><span class="line">    <span class="keyword">for</span> dataset_type <span class="keyword">in</span> [<span class="string">&quot;train&quot;</span>, <span class="string">&quot;validation&quot;</span>, <span class="string">&quot;test&quot;</span>]:</span><br><span class="line">        image_dir = os.path.join(args.root, dataset_type)</span><br><span class="line">        os.makedirs(image_dir, exist_ok=<span class="literal">True</span>)</span><br><span class="line"></span><br><span class="line">        annotation_file = <span class="string">&quot;&#123;&#125;/&#123;&#125;-annotations-bbox.csv&quot;</span>.<span class="built_in">format</span>(args.root,dataset_type)</span><br><span class="line">        <span class="keyword">if</span> <span class="keyword">not</span> os.path.exists(annotation_file):</span><br><span class="line">            url = <span class="string">&quot;https://storage.googleapis.com/openimages/2018_04/&#123;&#125;/&#123;&#125;-annotations-bbox.csv&quot;</span>.<span class="built_in">format</span>(dataset_type,dataset_type)</span><br><span class="line">            logging.warning(<span class="string">&quot;Download &#123;url&#125;.&quot;</span>.<span class="built_in">format</span>(url=url))</span><br><span class="line">            http_download(url, annotation_file)</span><br><span class="line">        logging.warning(<span class="string">&quot;Read annotation file &#123;&#125;&quot;</span>.<span class="built_in">format</span>(annotation_file))</span><br><span class="line">        annotations = pd.read_csv(annotation_file)</span><br><span class="line">        annotations = pd.merge(annotations, class_descriptions,</span><br><span class="line">                               left_on=<span class="string">&quot;LabelName&quot;</span>, right_on=<span class="string">&quot;id&quot;</span>,</span><br><span class="line">                               how=<span class="string">&quot;inner&quot;</span>)</span><br><span class="line">        <span class="keyword">if</span> <span class="keyword">not</span> args.include_depiction:</span><br><span class="line">            annotations = annotations.loc[annotations[<span class="string">&#x27;IsDepiction&#x27;</span>] != <span class="number">1</span>, :]</span><br><span class="line"></span><br><span class="line">        filtered = []</span><br><span class="line">        <span class="built_in">print</span>(<span class="string">&quot;class_names&quot;</span>, class_names)</span><br><span class="line">        group_filters = [<span class="string">&#x27;~group&#x27;</span>] * <span class="built_in">len</span>(class_names)</span><br><span class="line">        percentages=[<span class="number">1.0</span>]*<span class="built_in">len</span>(class_names)</span><br><span class="line">        <span class="keyword">for</span> class_name, group_filter, percentage <span class="keyword">in</span> <span class="built_in">zip</span>(class_names, group_filters, percentages):</span><br><span class="line">            sub = annotations.loc[annotations[<span class="string">&#x27;ClassName&#x27;</span>] == class_name, :]</span><br><span class="line">            excluded_images |= <span class="built_in">set</span>(sub[<span class="string">&#x27;ImageID&#x27;</span>].sample(frac=<span class="number">1</span> - percentage))</span><br><span class="line"></span><br><span class="line">            <span class="keyword">if</span> group_filter == <span class="string">&#x27;~group&#x27;</span>:</span><br><span class="line">                excluded_images |= <span class="built_in">set</span>(sub.loc[sub[<span class="string">&#x27;IsGroupOf&#x27;</span>] == <span class="number">1</span>, <span class="string">&#x27;ImageID&#x27;</span>])</span><br><span class="line">            <span class="keyword">elif</span> group_filter == <span class="string">&#x27;group&#x27;</span>:</span><br><span class="line">                excluded_images |= <span class="built_in">set</span>(sub.loc[sub[<span class="string">&#x27;IsGroupOf&#x27;</span>] == <span class="number">0</span>, <span class="string">&#x27;ImageID&#x27;</span>])</span><br><span class="line">            filtered.append(sub)</span><br><span class="line"></span><br><span class="line">        <span class="built_in">print</span>(<span class="string">&quot;annotations&quot;</span>, annotations.shape)</span><br><span class="line">        <span class="built_in">print</span>(<span class="string">&quot;filtered&quot;</span>,<span class="built_in">len</span>(filtered))</span><br><span class="line">        annotations = pd.concat(filtered)</span><br><span class="line">        annotations = annotations.loc[~annotations[<span class="string">&#x27;ImageID&#x27;</span>].isin(excluded_images), :]</span><br><span class="line"></span><br><span class="line">        <span class="keyword">if</span> args.remove_overlapped:</span><br><span class="line">            images_with_group = annotations.loc[annotations[<span class="string">&#x27;IsGroupOf&#x27;</span>] == <span class="number">1</span>, <span class="string">&#x27;ImageID&#x27;</span>]</span><br><span class="line">            annotations = annotations.loc[~(annotations[<span class="string">&#x27;ImageID&#x27;</span>].isin(<span class="built_in">set</span>(images_with_group)) &amp; (annotations[<span class="string">&#x27;IsGroupOf&#x27;</span>] == <span class="number">0</span>)), :]</span><br><span class="line">        annotations = annotations.sample(frac=<span class="number">1.0</span>)</span><br><span class="line"></span><br><span class="line">        logging.warning(<span class="string">&quot;&#123;&#125; bounding boxes size: &#123;&#125;&quot;</span>.<span class="built_in">format</span>(dataset_type,annotations.shape[<span class="number">0</span>]))</span><br><span class="line">        logging.warning(<span class="string">&quot;Approximate Image Stats: &quot;</span>)</span><br><span class="line">        log_counts(annotations.drop_duplicates([<span class="string">&quot;ImageID&quot;</span>, <span class="string">&quot;ClassName&quot;</span>])[<span class="string">&quot;ClassName&quot;</span>])</span><br><span class="line">        logging.warning(<span class="string">&quot;Label distribution: &quot;</span>)</span><br><span class="line">        log_counts(annotations[<span class="string">&#x27;ClassName&#x27;</span>])</span><br><span class="line"></span><br><span class="line">        logging.warning(<span class="string">&quot;Shuffle dataset.&quot;</span>)</span><br><span class="line"></span><br><span class="line">        sub_annotation_file = <span class="string">&quot;&#123;&#125;/sub-&#123;&#125;-annotations-bbox.csv&quot;</span>.<span class="built_in">format</span>(args.root,dataset_type)</span><br><span class="line">        logging.warning(<span class="string">&quot;Save &#123;&#125; data to &#123;&#125;.&quot;</span>.<span class="built_in">format</span>(dataset_type,sub_annotation_file))</span><br><span class="line">        annotations.to_csv(sub_annotation_file, index=<span class="literal">False</span>)</span><br><span class="line">        image_files.extend(<span class="string">&quot;&#123;&#125;/&#123;&#125;.jpg&quot;</span>.<span class="built_in">format</span>(dataset_type, ids) <span class="keyword">for</span> ids <span class="keyword">in</span> <span class="built_in">set</span>(annotations[<span class="string">&#x27;ImageID&#x27;</span>]))</span><br><span class="line">    <span class="built_in">print</span>(<span class="string">&#x27;image_files&#x27;</span>,<span class="built_in">len</span>(image_files))</span><br><span class="line">    logging.warning(<span class="string">&quot;Start downloading &#123;&#125; images.&quot;</span>.<span class="built_in">format</span>(<span class="built_in">len</span>(image_files)))</span><br><span class="line">    batch_download(bucket, image_files, args.root, args.num_workers, args.retry)</span><br><span class="line">    logging.warning(<span class="string">&quot;Task Done.&quot;</span>)</span><br><span class="line"></span><br></pre></td></tr></table></figure><p>可以使用如下方法进行下载</p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">python open_images_downloader.py --root ~/datas/openimage  --class_names_file dataset/awesome_open.names  --num_workers 500</span><br></pre></td></tr></table></figure>]]>
    </content>
    <id>https://xiaofengshi.com/2019/03/19/DeepLearning_Tensorflow/</id>
    <link href="https://xiaofengshi.com/2019/03/19/DeepLearning_Tensorflow/"/>
    <published>2019-03-19T11:47:25.000Z</published>
    <summary>
      <![CDATA[<p>本篇主要记录在日常工作中遇到的TensorFlow的相关信息，包括如何处理报错信息，环境设置，训练测试，数据等等。</p>]]>
    </summary>
    <title>DeepLearning_Tensorflow</title>
    <updated>2020-03-05T21:52:14.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Xiaofeng Shi</name>
    </author>
    <category term="深度学习" scheme="https://xiaofengshi.com/categories/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/"/>
    <category term="CV" scheme="https://xiaofengshi.com/categories/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/CV/"/>
    <category term="OCR" scheme="https://xiaofengshi.com/tags/OCR/"/>
    <content>
      <![CDATA[<p>本篇详细说明了OCR的应用，技术实现，当前相关进展等，不定时补充更新。</p><p>本篇博客最初想写成一本掘金小册，可是掘金的那边看了我的提纲说太难了，应该没什么受众，额……，那我就自己写一下记录下来，不会太讲究斟词酌句了，希望见谅。</p><p>本篇博客算是一篇针对OCR相关学习或者初步接触者的引导和入门，讲的不深，实际上针对每个模块，比如<code>CTPN</code>，<code>CTC</code>，<code>Attention</code>，<code>Densenet</code>这些我都有专门写过博客来讲述过，感兴趣的可以翻翻我的博客文章。</p><p>更新记录：</p><p>2020.01.31: 自从19年4月份入职字节跳动之后一直忙于工作，很久没有更新个人博客了，今天看到各位的留言很是感动，为自己长久的拖延感到羞愧。由于武汉肺炎延迟开工，今天努力把以前写的提纲补充齐全，这一年来，相比于之前增加了更多的工业界算法思维，一个好的算法是在能够实现预定目的的同时，尽可能节省算力的，接下来也会把自己的一些感触和经验体现在博客里面。</p><span id="more"></span><h2 id="OCR任务详解及应用场景"><a href="#OCR任务详解及应用场景" class="headerlink" title="OCR任务详解及应用场景"></a>OCR任务详解及应用场景</h2><h3 id="什么叫OCR"><a href="#什么叫OCR" class="headerlink" title="什么叫OCR"></a>什么叫OCR</h3><p>按照维基百科的定义，(<strong>Optical Character Recognition,OCR</strong>)光学字符识别是指对文本资料的图像文件进行分析识别处理，获取文字及版面信息的过程。通俗来讲，<strong>OCR任务就是我们输入一张包含文本资料的图片，得到该图像中包含的文字和版面信息输出，图形中包含的文字很好理解，版面信息对应的是在输入的图片中文字所在的位置信息。</strong></p><p>下面通过一张简单的图像进行OCR任务的说明</p><img src="/2019/03/13/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-OCR-%E4%BB%8E%E9%9B%B6%E5%BC%80%E5%A7%8B/text.png" class="" title="OCR待识别图片"><p>通过OCR得到的返回结果</p><img src="/2019/03/13/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-OCR-%E4%BB%8E%E9%9B%B6%E5%BC%80%E5%A7%8B/ali_text.png" class="" title="OCR返回结果"><p>上图为使用阿里云提供的OCR服务得到的返回结果，可以看到，通过OCR识别技术，不仅得到了输入图像中的文字信息，并且包含输入图像的版面信息。</p><h3 id="OCR用于何处"><a href="#OCR用于何处" class="headerlink" title="OCR用于何处"></a>OCR用于何处</h3><p>目前OCR识别在身份证，驾驶证，营业执照，银行卡，车牌，名片，合同文本等具有规范版面格式的图像场景中已经达到了商用指标，并取得了广泛的应用；在学术界则在探索更广泛的应用，研究更先进高效的算法以适用于街景文字识别，手写体识别等场景中。</p><p>人的懒惰推动着技术的进步，之所以开发并使用OCR相关技术，就是为了帮助我们更快的进行信息提取。但是在提取图像信息的同时人们对信息提取的准确率是有着的要求的，任何一个算法都要抱着宁缺毋滥的原则，并且在OCR识别中对于小说等文学文档的信息提取准确率，显然和对身份证、驾驶证等识别结果的要求是不同的，这就代表着要开发不同的算法以适应不同的场景需求。</p><p>接下来使用阿里云提供的OCR服务：<a href="https://ai.aliyun.com/ocr/general?spm=5176.12188956.1280361.58.4ddb1a9eyHHIYB">https://ai.aliyun.com/ocr/general?spm=5176.12188956.1280361.58.4ddb1a9eyHHIYB</a></p><p>进行不同类型照片的测试</p><p>对于身份证照片</p><img src="/2019/03/13/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-OCR-%E4%BB%8E%E9%9B%B6%E5%BC%80%E5%A7%8B/id_card.jpg" class="" title="身份证照片"><img src="/2019/03/13/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-OCR-%E4%BB%8E%E9%9B%B6%E5%BC%80%E5%A7%8B/id_card_out.png" class="" title="身份证识别结果"><p>对于汽车车牌照片识别</p><img src="/2019/03/13/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-OCR-%E4%BB%8E%E9%9B%B6%E5%BC%80%E5%A7%8B/car_id.jpg" class="" title="汽车牌照照片"><img src="/2019/03/13/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-OCR-%E4%BB%8E%E9%9B%B6%E5%BC%80%E5%A7%8B/car_id_out.png" class="" title="汽车牌照识别结果"><p>如上的识别结果由阿里云OCR服务提供，并且目前已经得到了广泛的应用，可以看到对于具有标准格式的照片OCR识别结果非常准确。</p><h3 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h3><p>本章节结合实例对OCR的概念和应用场景进行了讲解，目前OCR技术已经在众多领域得到了广泛应用，相信大家一定好奇OCR识别具体是如何实现的，会在接下来的章节进行详细讲解</p><h3 id="思考"><a href="#思考" class="headerlink" title="思考"></a>思考</h3><p>请大家思考一个问题，对于OCR识别结果，如何确保其正确性的呢？</p><h2 id="中文OCR任务解决方案"><a href="#中文OCR任务解决方案" class="headerlink" title="中文OCR任务解决方案"></a>中文OCR任务解决方案</h2><p>本章节主要针对OCR识别具体的实现方案进行详细的阐述。</p><p>环境需求：</p><p>python&#x3D;&#x3D;3.6</p><p>opencv-python&#x3D;&#x3D;4.0</p><p>启动jupyter之后，首先导入依赖</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">import</span> os</span><br><span class="line"><span class="keyword">import</span> sys</span><br><span class="line"><span class="keyword">import</span> cv2</span><br><span class="line"><span class="keyword">from</span> PIL <span class="keyword">import</span> Image</span><br><span class="line"><span class="keyword">import</span> numpy <span class="keyword">as</span> np</span><br><span class="line"><span class="keyword">from</span> matplotlib <span class="keyword">import</span> pyplot <span class="keyword">as</span> plt</span><br></pre></td></tr></table></figure><h3 id="OCR识别过程"><a href="#OCR识别过程" class="headerlink" title="OCR识别过程"></a>OCR识别过程</h3><ul><li><p>图片预处理</p><p>对于输入的图片，一般来源是手机拍摄，摄像头拍摄，打印机扫描等，这就意味着输入的图片具有多种格式和色彩特征和多种数据格式，在OCR识别时，要对输入的图片进行预处理，一般的预处理方式包括如下几种。</p><ul><li><p>图像读取</p><p>该步骤要读取图像为统一格式，输入的图片包含’jpg’、’png’、’jpeg’等格式，不同的图片格式意味着不同的数据格式，因此在读取图片的时候要转换成一个固定的格式，一般情况下，将所有转换的图像都转换成灰度图数据格式</p><p>以上一章节的身份证照片为例</p><img src="/2019/03/13/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-OCR-%E4%BB%8E%E9%9B%B6%E5%BC%80%E5%A7%8B/id_card.jpg" class="" title="原始身份证图片"><p>将读取的图像转化成灰度图</p><img src="/2019/03/13/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-OCR-%E4%BB%8E%E9%9B%B6%E5%BC%80%E5%A7%8B/id_card_gray.png" class="" title="转换成灰度图"><p>可以看到，通过转换成灰度图，输入的彩色图片转换成了灰度图</p><p><strong>代码实现如下</strong></p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 图片地址</span></span><br><span class="line">img_path=<span class="string">&#x27;id_card.png&#x27;</span></span><br><span class="line"><span class="comment"># 读取图片</span></span><br><span class="line">img=Image.<span class="built_in">open</span>(img_path)</span><br><span class="line"><span class="comment"># 显示图片</span></span><br><span class="line">plt.imshow(img)</span><br><span class="line"><span class="comment"># 数据转换成numpy格式</span></span><br><span class="line">img_data=np.asarray(img)</span><br><span class="line"><span class="comment"># 图片转换成灰度图</span></span><br><span class="line">gray_img=cv2.cvtColor(img_data,cv2.COLOR_RGB2GRAY)</span><br><span class="line"><span class="comment"># 显示灰度图</span></span><br><span class="line">plt.imshow(gray_img)</span><br><span class="line"><span class="comment"># 保存图片</span></span><br><span class="line">cv2.imwrite(<span class="string">&#x27;gray.png&#x27;</span>,gray_img)</span><br></pre></td></tr></table></figure></li><li><p>图像色彩处理</p><p>一般情况下，OCR输入的图像输入的是彩色图像，图像中包含着大量的色彩信息，为了提高OCR的识别效率，更快的提取图像中的文字信息，通常对输入的图像进行二值化处理，所谓二值化就是将图像进行处理，使其只包含黑白二色。</p><img src="/2019/03/13/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-OCR-%E4%BB%8E%E9%9B%B6%E5%BC%80%E5%A7%8B/id_card_binary.png" class="" title="转化为黑白二值图"><p><strong>代码实现如下</strong></p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 动态阈值进行图像二值化处理</span></span><br><span class="line">blur_img = cv2.adaptiveThreshold(</span><br><span class="line">            gray_img, <span class="number">255</span>, cv2.ADAPTIVE_THRESH_MEAN_C, cv2.THRESH_BINARY, <span class="number">25</span>, <span class="number">20</span>)</span><br><span class="line"><span class="comment"># 显示二值化图像</span></span><br><span class="line">plt.imshow(blur_img)</span><br><span class="line"><span class="comment"># 保存图片</span></span><br><span class="line">cv2.imwrite(<span class="string">&#x27;blur.png&#x27;</span>,blur_img)</span><br></pre></td></tr></table></figure></li><li><p>图片去噪</p><p>将图像转换成二值图之后，会发现图片中存在很多噪声，对于噪声的分类一般为椒盐噪声，高斯噪声。在图像处理中使用中值滤波或者均值滤波进行图片去噪处理</p><img src="/2019/03/13/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-OCR-%E4%BB%8E%E9%9B%B6%E5%BC%80%E5%A7%8B/id_card_denoised.png" class="" title="图片去噪"><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 对二值图片进行噪声去除</span></span><br><span class="line"><span class="comment"># fastNlMeansDenoising的参数为</span></span><br><span class="line"><span class="comment"># 待处理图片，滤波器强度，对彩色图片滤波摩人与滤波器强度相等，模板尺寸，搜索窗口尺寸</span></span><br><span class="line">img_denoised=cv2.fastNlMeansDenoising(blur_img,<span class="number">10</span>,<span class="number">10</span>,<span class="number">7</span>,<span class="number">21</span>)</span><br><span class="line"><span class="comment"># 显示图片</span></span><br><span class="line">plt.imshow(img_denoised)</span><br><span class="line"><span class="comment"># 保存图片</span></span><br><span class="line">cv2.imwrite(<span class="string">&#x27;denoised.png&#x27;</span>,img_denoised)</span><br></pre></td></tr></table></figure></li><li><p>图片倾斜矫正</p><p>如果输入的图片是手机拍摄，一般情况下照片会不可避免的存在倾斜，这时候就要对输入的图片进行倾斜矫正。倾斜矫正包括两种，一种是图片旋转，一种是图片的仿射变换。</p><p>对于图片旋转，首先考虑如何实现图片的旋转呢，实际上对图片进行旋转就是进行矩阵旋转，首先分析旋转在二维平面中围绕一个点进行旋转</p><img src="/2019/03/13/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-OCR-%E4%BB%8E%E9%9B%B6%E5%BC%80%E5%A7%8B/rotate_2d.png" class="" title="旋转示意图"><p>图中所示为点V绕远点旋转角度<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>θ</mi></mrow></semantics></math></span></span>，得到旋转后的点<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><msup><mi mathvariant="bold">v</mi><mo mathvariant="normal" lspace="0em" rspace="0em">′</mo></msup></mrow></semantics></math></span></span>，假设<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>v</mi></mrow></semantics></math></span></span>点原来的坐标为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mo stretchy="false">(</mo><mi>x</mi><mo separator="true">,</mo><mi>y</mi><mo stretchy="false">)</mo></mrow></semantics></math></span></span>，进行推导<br><span class="katex-display" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML" display="block"><semantics><mtable rowspacing="0.16em" columnalign="left" columnspacing="1em"><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mi>x</mi><mo>&#x3D;</mo><mi>r</mi><mi>cos</mi><mo>⁡</mo><mi>ϕ</mi><mspace linebreak="newline"></mspace><mi>y</mi><mo>&#x3D;</mo><mi>r</mi><mi>sin</mi><mo>⁡</mo><mi>ϕ</mi></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><msup><mi>x</mi><mo mathvariant="normal" lspace="0em" rspace="0em">′</mo></msup><mo>&#x3D;</mo><mi>r</mi><mi>cos</mi><mo>⁡</mo><mo stretchy="false">(</mo><mi>θ</mi><mo>+</mo><mi>ϕ</mi><mo stretchy="false">)</mo><mspace linebreak="newline"></mspace><msup><mi>y</mi><mo mathvariant="normal" lspace="0em" rspace="0em">′</mo></msup><mo>&#x3D;</mo><mi>r</mi><mi>sin</mi><mo>⁡</mo><mo stretchy="false">(</mo><mi>θ</mi><mo>+</mo><mi>ϕ</mi><mo stretchy="false">)</mo></mrow></mstyle></mtd></mtr></mtable></semantics></math></span></span><br>使用三角函数进行展开<br><span class="katex-display" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML" display="block"><semantics><mtable rowspacing="0.25em" columnalign="right left" columnspacing="0em"><mtr><mtd><mstyle scriptlevel="0" displaystyle="true"><msup><mi>x</mi><mo mathvariant="normal" lspace="0em" rspace="0em">′</mo></msup></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="true"><mrow><mrow></mrow><mo>&#x3D;</mo><mi>r</mi><mi>cos</mi><mo>⁡</mo><mi>θ</mi><mi>cos</mi><mo>⁡</mo><mi>ϕ</mi><mo>−</mo><mi>r</mi><mi>sin</mi><mo>⁡</mo><mi>θ</mi><mi>sin</mi><mo>⁡</mo><mi>ϕ</mi></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="true"><msup><mi>y</mi><mo mathvariant="normal" lspace="0em" rspace="0em">′</mo></msup></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="true"><mrow><mrow></mrow><mo>&#x3D;</mo><mi>r</mi><mi>sin</mi><mo>⁡</mo><mi>θ</mi><mi>cos</mi><mo>⁡</mo><mi>ϕ</mi><mo>+</mo><mi>r</mi><mi>cos</mi><mo>⁡</mo><mi>θ</mi><mi>sin</mi><mo>⁡</mo><mi>ϕ</mi></mrow></mstyle></mtd></mtr></mtable></semantics></math></span></span><br>再将x，y带入到上面式子中可以得到表达式<br><span class="katex-display" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML" display="block"><semantics><mtable rowspacing="0.16em" columnalign="left" columnspacing="1em"><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><msup><mi>x</mi><mo mathvariant="normal" lspace="0em" rspace="0em">′</mo></msup><mo>&#x3D;</mo><mi>x</mi><mi>cos</mi><mo>⁡</mo><mi>θ</mi><mo>−</mo><mi>y</mi><mi>sin</mi><mo>⁡</mo><mi>θ</mi></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><msup><mi>y</mi><mo mathvariant="normal" lspace="0em" rspace="0em">′</mo></msup><mo>&#x3D;</mo><mi>x</mi><mi>sin</mi><mo>⁡</mo><mi>θ</mi><mo>+</mo><mi>y</mi><mi>cos</mi><mo>⁡</mo><mi>θ</mi></mrow></mstyle></mtd></mtr></mtable></semantics></math></span></span><br>这是对单个点以原点为中心进行旋转，当扩展到一个图像中的时候，写成矩阵形式<br><span class="katex-display" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML" display="block"><semantics><mrow><mrow><mo fence="true">[</mo><mtable rowspacing="0.16em" columnalign="left" columnspacing="1em"><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><msup><mi>x</mi><mo mathvariant="normal" lspace="0em" rspace="0em">′</mo></msup></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><msup><mi>y</mi><mo mathvariant="normal" lspace="0em" rspace="0em">′</mo></msup></mstyle></mtd></mtr></mtable><mo fence="true">]</mo></mrow><mo>&#x3D;</mo><mrow><mo fence="true">[</mo><mtable rowspacing="0.16em" columnalign="center center" columnspacing="1em"><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mi>cos</mi><mo>⁡</mo><mi>θ</mi></mrow></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mo>−</mo><mi>sin</mi><mo>⁡</mo><mi>θ</mi></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mi>sin</mi><mo>⁡</mo><mi>θ</mi></mrow></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mi>cos</mi><mo>⁡</mo><mi>θ</mi></mrow></mstyle></mtd></mtr></mtable><mo fence="true">]</mo></mrow><mo>∗</mo><mrow><mo fence="true">[</mo><mtable rowspacing="0.16em" columnalign="left" columnspacing="1em"><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mi>x</mi></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mi>y</mi></mstyle></mtd></mtr></mtable><mo fence="true">]</mo></mrow></mrow></semantics></math></span></span><br>如果旋转中心点不是原点，而是任意一个点，那么这时候该怎么做呢？</p><p>在计算机图形学中，为了统一将图形平移、旋转、缩放等都用矩阵形式表示，需要引入<a href="https://zh.wikipedia.org/wiki/%E9%BD%90%E6%AC%A1%E5%9D%90%E6%A0%87">齐次坐标</a>。将上述问题进行拆分，首先将旋转点移动到原点处，之后按照原点进行旋转，最后将旋转点从原点移动到原来的位置。</p><img src="/2019/03/13/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-OCR-%E4%BB%8E%E9%9B%B6%E5%BC%80%E5%A7%8B/move2d.jpeg" class="" title="二维平移"><p>首先进行二维平移操作，如上图所示，一个点<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>P</mi><mo stretchy="false">(</mo><mi>x</mi><mo separator="true">,</mo><mi>y</mi><mo stretchy="false">)</mo></mrow></semantics></math></span></span>，移动到点<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><msup><mi>P</mi><mo mathvariant="normal" lspace="0em" rspace="0em">′</mo></msup><mo stretchy="false">(</mo><msup><mi>x</mi><mo mathvariant="normal" lspace="0em" rspace="0em">′</mo></msup><mo separator="true">,</mo><msup><mi>y</mi><mo mathvariant="normal" lspace="0em" rspace="0em">′</mo></msup><mo stretchy="false">)</mo></mrow></semantics></math></span></span>，从图中可以很明显的看出在二维空间的坐标位置关系<br><span class="katex-display" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML" display="block"><semantics><mrow><msup><mi>x</mi><mo mathvariant="normal" lspace="0em" rspace="0em">′</mo></msup><mo>&#x3D;</mo><mi>x</mi><mo>+</mo><mi>t</mi><mi>x</mi><mspace linebreak="newline"></mspace><msup><mi>y</mi><mo mathvariant="normal" lspace="0em" rspace="0em">′</mo></msup><mo>&#x3D;</mo><mi>y</mi><mo>+</mo><mi>t</mi><mi>y</mi></mrow></semantics></math></span></span><br>使用其次坐标进行表示二维平移<br><span class="katex-display" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML" display="block"><semantics><mrow><mrow><mo fence="true">[</mo><mtable rowspacing="0.16em" columnalign="center" columnspacing="1em"><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><msup><mi>x</mi><mo mathvariant="normal" lspace="0em" rspace="0em">′</mo></msup></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><msup><mi>y</mi><mo mathvariant="normal" lspace="0em" rspace="0em">′</mo></msup></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>1</mn></mstyle></mtd></mtr></mtable><mo fence="true">]</mo></mrow><mo>&#x3D;</mo><mrow><mo fence="true">[</mo><mtable rowspacing="0.16em" columnalign="left left left" columnspacing="1em"><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>1</mn></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>0</mn></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mi>t</mi><mi>x</mi></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>0</mn></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>1</mn></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mi>t</mi><mi>y</mi></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>0</mn></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>0</mn></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>1</mn></mstyle></mtd></mtr></mtable><mo fence="true">]</mo></mrow><mo>∗</mo><mrow><mo fence="true">[</mo><mtable rowspacing="0.16em" columnalign="left" columnspacing="1em"><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mi>x</mi></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mi>y</mi></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>1</mn></mstyle></mtd></mtr></mtable><mo fence="true">]</mo></mrow></mrow></semantics></math></span></span><br>同理，结合二维空间的旋转操作，在其次坐标下进行旋转操作，得到变换关系式为<br><span class="katex-display" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML" display="block"><semantics><mrow><mrow><mo fence="true">[</mo><mtable rowspacing="0.16em" columnalign="center" columnspacing="1em"><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><msup><mi>x</mi><mo mathvariant="normal" lspace="0em" rspace="0em">′</mo></msup></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><msup><mi>y</mi><mo mathvariant="normal" lspace="0em" rspace="0em">′</mo></msup></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>1</mn></mstyle></mtd></mtr></mtable><mo fence="true">]</mo></mrow><mo>&#x3D;</mo><mrow><mo fence="true">[</mo><mtable rowspacing="0.16em" columnalign="center center center" columnspacing="1em"><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mi>cos</mi><mo>⁡</mo><mi>θ</mi></mrow></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mo>−</mo><mi>sin</mi><mo>⁡</mo><mi>θ</mi></mrow></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>0</mn></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mi>sin</mi><mo>⁡</mo><mi>θ</mi></mrow></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mi>cos</mi><mo>⁡</mo><mi>θ</mi></mrow></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>0</mn></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>0</mn></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>0</mn></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>1</mn></mstyle></mtd></mtr></mtable><mo fence="true">]</mo></mrow><mo>∗</mo><mrow><mo fence="true">[</mo><mtable rowspacing="0.16em" columnalign="left" columnspacing="1em"><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mi>x</mi></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mi>y</mi></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>1</mn></mstyle></mtd></mtr></mtable><mo fence="true">]</mo></mrow></mrow></semantics></math></span></span><br>按照前面对绕任一点旋转的拆分，先进行平移，之后旋转，最后再反向平移</p><p>可以得到旋转矩阵为<br><span class="katex-display" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML" display="block"><semantics><mrow><mi>M</mi><mo>&#x3D;</mo><mrow><mo fence="true">[</mo><mtable rowspacing="0.16em" columnalign="center center center" columnspacing="1em"><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>1</mn></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>0</mn></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mi mathvariant="normal">-tx</mi><mo>⁡</mo></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>0</mn></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>1</mn></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mo>−</mo><mi>t</mi><mi>y</mi></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>0</mn></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>0</mn></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>1</mn></mstyle></mtd></mtr></mtable><mo fence="true">]</mo></mrow><mo>∗</mo><mrow><mo fence="true">[</mo><mtable rowspacing="0.16em" columnalign="center center center" columnspacing="1em"><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mi>cos</mi><mo>⁡</mo><mi>θ</mi></mrow></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mo>−</mo><mi>sin</mi><mo>⁡</mo><mi>θ</mi></mrow></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>0</mn></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mi>sin</mi><mo>⁡</mo><mi>θ</mi></mrow></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mi>cos</mi><mo>⁡</mo><mi>θ</mi></mrow></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>0</mn></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>0</mn></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>0</mn></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>1</mn></mstyle></mtd></mtr></mtable><mo fence="true">]</mo></mrow><mo>∗</mo><mrow><mo fence="true">[</mo><mtable rowspacing="0.16em" columnalign="center center center" columnspacing="1em"><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>1</mn></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>0</mn></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mi>t</mi><mi>x</mi></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>0</mn></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>1</mn></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mi>t</mi><mi>y</mi></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>0</mn></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>0</mn></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>1</mn></mstyle></mtd></mtr></mtable><mo fence="true">]</mo></mrow><mspace linebreak="newline"></mspace><mo>&#x3D;</mo><mrow><mo fence="true">[</mo><mtable rowspacing="0.16em" columnalign="center center center" columnspacing="1em"><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mi>cos</mi><mo>⁡</mo><mi>θ</mi></mrow></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mo>−</mo><mi>sin</mi><mo>⁡</mo><mi>θ</mi></mrow></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mo stretchy="false">(</mo><mn>1</mn><mo>−</mo><mi>cos</mi><mo>⁡</mo><mi>θ</mi><mo stretchy="false">)</mo><mi>t</mi><mi>x</mi><mo>−</mo><mi>t</mi><mi>y</mi><mo>∗</mo><mi>sin</mi><mo>⁡</mo><mi>θ</mi></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mi>sin</mi><mo>⁡</mo><mi>θ</mi></mrow></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mi>cos</mi><mo>⁡</mo><mi>θ</mi></mrow></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><mo stretchy="false">(</mo><mn>1</mn><mo>−</mo><mi>cos</mi><mo>⁡</mo><mi>θ</mi><mo stretchy="false">)</mo><mi>t</mi><mi>y</mi><mo>+</mo><mi>t</mi><mi>x</mi><mo>∗</mo><mi>sin</mi><mo>⁡</mo><mi>θ</mi></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>0</mn></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>0</mn></mstyle></mtd><mtd><mstyle scriptlevel="0" displaystyle="false"><mn>1</mn></mstyle></mtd></mtr></mtable><mo fence="true">]</mo></mrow></mrow></semantics></math></span></span><br>如上便是在计算机图形学中对图像进行旋转的数学原理，在代码实现中一般使用opencv实现。</p><img src="/2019/03/13/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-OCR-%E4%BB%8E%E9%9B%B6%E5%BC%80%E5%A7%8B/id_card_rotated.png" class="" title="旋转图片45度"><p>实现代码</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><span class="line">h,w=img_denoised.shape</span><br><span class="line"><span class="comment"># 计算图片中心点</span></span><br><span class="line">center=(w//<span class="number">2</span>,h//<span class="number">2</span>)</span><br><span class="line"><span class="comment"># 创建旋转矩阵，旋转角度为45度</span></span><br><span class="line">M = cv2.getRotationMatrix2D(center, <span class="number">45</span>, <span class="number">1.0</span>) </span><br><span class="line"><span class="comment"># 得到旋转之后的图像</span></span><br><span class="line">img_rotated = cv2.warpAffine(img_denoised, M, (w, h))</span><br><span class="line"><span class="comment"># 显示图片</span></span><br><span class="line">plt.imshow(img_rotated)</span><br><span class="line"><span class="comment"># 保存图片</span></span><br><span class="line">cv2.imwrite(<span class="string">&#x27;rotated.png&#x27;</span>, img_rotated)</span><br></pre></td></tr></table></figure><p>上述是进行图像旋转的代码实现。可以打印矩阵M查看和使用公式计算的结果是一致的。</p><p>可以看到，旋转前后的图像的尺寸保持一致，这就会造成旋转之后的图片会丢失部分图片信息，实际上可以对上面的代码进行修正</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 计算图片的几何尺寸</span></span><br><span class="line">h,w=img_denoised.shape</span><br><span class="line"><span class="comment"># 计算图片中心点</span></span><br><span class="line">center=(w//<span class="number">2</span>,h//<span class="number">2</span>)</span><br><span class="line"><span class="comment"># 创建旋转矩阵，旋转角度为45度</span></span><br><span class="line">M = cv2.getRotationMatrix2D(center, <span class="number">45</span>, <span class="number">1.0</span>)</span><br><span class="line"><span class="comment"># 计算旋转角度的正余弦值</span></span><br><span class="line">cos = np.<span class="built_in">abs</span>(M[<span class="number">0</span>, <span class="number">0</span>])</span><br><span class="line">sin = np.<span class="built_in">abs</span>(M[<span class="number">0</span>, <span class="number">1</span>])</span><br><span class="line"><span class="comment"># 计算旋转之后的图片的宽度和高度</span></span><br><span class="line">nW = <span class="built_in">int</span>((h * sin) + (w * cos))</span><br><span class="line">nH = <span class="built_in">int</span>((h * cos) + (w * sin))</span><br><span class="line"><span class="comment"># 在旋转矩阵的基础上加入角度旋转造成的图片尺寸的影响</span></span><br><span class="line">M[<span class="number">0</span>, <span class="number">2</span>] += (nW / <span class="number">2</span>) - center[<span class="number">0</span>]</span><br><span class="line">M[<span class="number">1</span>, <span class="number">2</span>] += (nH / <span class="number">2</span>) - center[<span class="number">1</span>]</span><br><span class="line"><span class="comment"># 旋转图像</span></span><br><span class="line">rotated2=cv2.warpAffine(img_denoised, M, (nW, nH))</span><br><span class="line"><span class="comment"># 显示图像</span></span><br><span class="line">plt.imshow(rotated2)</span><br></pre></td></tr></table></figure><img src="/2019/03/13/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-OCR-%E4%BB%8E%E9%9B%B6%E5%BC%80%E5%A7%8B/id_card_rotated2.png" class="" title="修正旋转矩阵"><p>对图片进行修正之后，可以看到旋转之后的图片保留了原图片的全部信息，</p></li><li><p>版面分析</p><p>将输入的文档图片按照段落或行为单位进行版面分析，在实际操作中，由于文档是丰富多样的，因此目前没有固定的版面分析算法，要根据实际应用场景进行设计，这也是目前OCR识别任务重比较重要的一部，会在之后部分详细说明。</p></li><li><p>字符识别</p><p>在OCR识别任务中，存在多种字符识别的方法，早期使用的是模板匹配的方法，后期有特征提取的方法，直至目前的深度学习的方法，该步骤对OCR识别准确率至关重要，同样会在之后的部分进行详细说明。</p></li><li><p>版面还原</p><p>对于OCR任务中，我们希望识别后的文字仍然按照输入文档图片那样排列，保持段落不变，文字位置不变，顺序不变的输出，该步骤就是版面还原的过程。在该步骤中，版面还原的信息依赖于前期的版面分析的到的版面信息。</p></li><li><p>输出校对</p><p>最后是对输出的识别结果使用自然语言的方法进行识别结果的校正。</p></li></ul><p>上述过程就是OCR识别的一般过程，简单来讲就是，先对图像进行预处理，将输入的图像变成统一的格式，之后进行版面分析和文字识别，最终进行版面还原输出。在整个过程中，图像预处理一般使用的是通用的技术解决方案，就如上文所说，进行图像转成灰度图，二值化处理，提高对比度亮度，旋转仿射变换等常规处理手段，经过如上的图像预处理，输入的图像变成相对统一的图像数据。之后便要对输入的图像进行版面分析，主要是找到图像中的待识别文字的位置区域，这里的文字区域可以是中文中的单个文字，可以使英文中的单个单词，也可以是一行文字；当找到待识别文字的位置区域之后，就下来就是对区域内图像文字进行识别。接下来便对版面分析和文字识别进行着重说明。</p></li></ul><h3 id="版面分析"><a href="#版面分析" class="headerlink" title="版面分析"></a>版面分析</h3><p>正如上文所述，版面分析就是要找到待识别文字的位置区域，所谓文字区域，一般是指单个文字或者一整行的文字</p><h4 id="传统手工特征方法"><a href="#传统手工特征方法" class="headerlink" title="传统手工特征方法"></a>传统手工特征方法</h4><p>如果要提取单文字的位置区域，存在多种技术实现方法，下面进行简略说明。</p><ul><li>图像投影方法</li></ul><p>对预处理之后的图像，将图像对垂直方向的坐标轴进行投影，图像中不同行的文字经过投影会被间隔开，如此就可以提取到不同的文本行，如下所示为对进行噪声去噪之后的二值图进行水平方向的投影。</p><img src="/2019/03/13/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-OCR-%E4%BB%8E%E9%9B%B6%E5%BC%80%E5%A7%8B/id_card_horizonal.png" class="" title="图像进行水平方向投影"><p>代码实现</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment"># 图片预处理</span></span><br><span class="line">img_path=<span class="string">&#x27;id_card.png&#x27;</span></span><br><span class="line">img_color=cv2.imread(img_path)</span><br><span class="line">img_gray=cv2.cvtColor(image_color, cv2.COLOR_BGR2GRAY)</span><br><span class="line">blur_img = cv2.adaptiveThreshold(</span><br><span class="line">            img_gray, <span class="number">255</span>, cv2.ADAPTIVE_THRESH_MEAN_C, cv2.THRESH_BINARY_INV, <span class="number">25</span>, <span class="number">20</span>)</span><br><span class="line"><span class="comment"># 对图像中每一行进行求和</span></span><br><span class="line">horizontal_sum=np.<span class="built_in">sum</span>(blur_img,axis=<span class="number">1</span>)</span><br><span class="line"><span class="comment"># 绘制图形</span></span><br><span class="line">plt.figure(<span class="string">&#x27;horizonal&#x27;</span>,dpi=<span class="number">100</span>)</span><br><span class="line">grid = plt.GridSpec(<span class="number">4</span>, <span class="number">4</span>, wspace=<span class="number">0.5</span>, hspace=<span class="number">0.5</span>)</span><br><span class="line"></span><br><span class="line">plt.subplot(grid[<span class="number">0</span>:<span class="number">3</span>,<span class="number">1</span>:<span class="number">4</span>])</span><br><span class="line"><span class="comment"># 显示灰度图</span></span><br><span class="line">plt.imshow(blur_img,<span class="string">&#x27;gray&#x27;</span>)</span><br><span class="line"><span class="comment"># 显示垂直方向投影图</span></span><br><span class="line">plt.subplot(grid[<span class="number">0</span>:<span class="number">3</span>,<span class="number">0</span>])</span><br><span class="line">plt.plot(horizontal_sum,<span class="built_in">range</span>(horizontal_sum.shape[<span class="number">0</span>]))</span><br><span class="line">plt.xlabel(<span class="string">&#x27;datasam&#x27;</span>)</span><br><span class="line">plt.ylabel(<span class="string">&#x27;ImageHeight&#x27;</span>)</span><br><span class="line">plt.gca().invert_yaxis()</span><br><span class="line">plt.savefig(<span class="string">&#x27;horizonal.png&#x27;</span>)</span><br></pre></td></tr></table></figure><p>从图中可以看出，对输入图像进行处理之后，图像的背景色为黑色，文字部分为白色，在图像数据中黑色对应的值为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>0</mn></mrow></semantics></math></span></span>，白色对应的值为<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mn>255</mn></mrow></semantics></math></span></span>。对图像进行垂直方向投影，输入图像中的文字区域部分垂直投影之后得到的值较大，背景区域投影之后得到的值较小，通过对垂直投影之后的数据进行提取，就可以确定图像中存在多少行和每行在图片高度方向上的位置。</p><p>确定输入图像中的每行文字区域之后，接下来对每行的图像进行水平方向的投影，由此确定当前行中的每个文字所在的位置，处理方法是和竖直方向投影方法相同。</p><img src="/2019/03/13/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-OCR-%E4%BB%8E%E9%9B%B6%E5%BC%80%E5%A7%8B/text_split.png" class="" title="对每个字符进行提取"><p>使用如上方法可以实现对输入图像中每个字符进行提取，也就是找到每个文字在输入图像中的位置，提取到单字符之后便可以对每个文字进行识别。</p><p>由于对文字的提取基于竖直方向投影和水平方向投影得到，因此提取到的字符依赖于算法中设定的阈值，该阈值用于区分每一行文字或每行中的每个文字。从图中可以看到，提取到的单字文字存在一定错误，这正是由于算法中设定的阈值造成的，这也是该方法的局限性，尤其是对于中文字体结构，在中文中存在很多左右结构的文字，比如“小”，“林”，“从”等文字，如果算法中设定的阈值不合适，那很有可能将左右结构的一个字提取城两个字。</p><p>除了上述的方法之外，还有基于连通区域的方法，其假设字符本身是具有连通性的，之后通过连通区域的检测方法好到文字的候选区域，感兴趣的读者可以参考论文<a href="http://pages.ucsd.edu/~ztu/publication/cvpr12_textdetection.pdf">Detecting Texts of Arbitrary Orientations in Natural Images</a>；或者使用最大稳定极值区域的方法，使用该方法得到候选字符区域，并将这些区域看做是连通图的顶点，因为，同一行的文本通常具有相同的文字方向，颜色，字体等，所以可以将文本行的确定转化为连通图聚类的过程，通过该方法确定文本行，感兴趣的读者可以参考文献<a href="https://pdfs.semanticscholar.org/ba05/72bb8d90fef080dc5790545383507c0722ea.pdf">Text Detection for Multi-Orientation Scene Images using Adaptive Clustering</a>。</p><p>对于上述的基于人工特征方法的OCR技术实现方案，都伴随着复杂的特征工程，不论是从文本图形的文字的连通性考虑或者从文字的字体等信息考虑，这些方法的适用性都相对狭小，只能处理相对单一类别的文本图像，此外提取的效果也不够鲁棒，容易受到输入图像中的背景信息影响，并且提取结果很容易受到人为设置的一些参数的影响。随着计算机硬件计算能力的大幅度提升，在2014年左右，出现了深度学习方法的OCR技术方案，OCR技术不论是从识别效果还是从OCR识别场景适用性都取得了巨大进步。</p><h4 id="深度学习OCR技术"><a href="#深度学习OCR技术" class="headerlink" title="深度学习OCR技术"></a>深度学习OCR技术</h4><p>正如上文所述的使用人工特征的方法在OCR识别过程中存在诸多问题，深度学习OCR技术以其适用性更广，人工特征更少，识别准确率更高的优点，目前已经成为OCR识别的主流应用技术。对于OCR识别过程，上文已经有所描述，过程中的难点，一个是版面分析，也就是找到输入图像的文本区域所在的位置，另一个是文本识别，也就是对找到的文本图像进行识别。这里所说的深度学习OCR技术，也是着重解决这两个问题。目前存在的深度学习OCR方案主要是分两种，一种是端到端实现OCR识别，也就是设计一个网络模型，实现文字区域检测和文本识别，另一种是进行对文本检测和文本识别都设计开发单独的网络模型以实现任务目标，下面进行分别说明。</p><h5 id="文本检测"><a href="#文本检测" class="headerlink" title="文本检测"></a>文本检测</h5><p>说到文本检测，也就是检测到输入图像的文本区域，得到文字区域的位置信息。目前主要有两种深度学习实现思路，一种是基于目标检测方法，一种是基于图像分割的方法，其中基于目标检测的方法是目前应用最广泛的方法。</p><p>目前来说，在文本检测中，以目标检测为baseline仍然是占据主流，因为这两个任务具有天然的相关性，文本检测可以看做是目标检测中的一个分支，因此通用的目标检测技术经过一定定制优化是可以直接移植到文本检测上的，本人不太推荐基于分割的技术方法，首先在数据标注上，分割显然比检测的标注难度提升好几个等级，再者就是分割算法相比于检测算法需要更多的参数量，需要更多的计算资源和更久的运算时间，在工业界不太推荐。</p><ul><li><p>基于目标检测的方法</p><ol><li><p>早期比较有代表性的深度学习OCR识别算法是由大名鼎鼎的VGG实验室开发的<a href="https://arxiv.org/abs/1412.1842">Reading Text in the Wild with Convolutional Neural Networks</a>，该模型可以实现文本检测和文字识别的端到端OCR识别过程，模型中最具代表性的是文本检测的实现方法。</p><img src="/2019/03/13/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-OCR-%E4%BB%8E%E9%9B%B6%E5%BC%80%E5%A7%8B/ReadingText.png" class="" title="检测方案"><ul><li>使用<a href="https://web.bii.a-star.edu.sg/~zhangxw/files/EdgeBoxes_ECCV2014.pdf">EdgeBoxes:边缘框算法</a>生成大量的文本提议区域，该步骤要尽可能生成足够多的候选文本区域，要尽量能够更好的覆盖真实文本区域；</li><li>使用随机森林分类器对提议文本区域进行分类，过滤第一步生成的非文本提议区域；</li><li>使用目标检测模型<a href="https://arxiv.org/abs/1311.2524">RCNN</a>中对文本提议框回归的计算方法，对过滤之后的文本提议框进行修正以接近真实文本区域范围；</li><li>最后使用一个文字识别算法进一步过滤非文本提议区域。</li></ul><p>该方法可以看做是在RCNN基础上的应用，在RCNN中使用随机搜索的方法生成了候选文本提议，在该算法中使用的则是边缘框算法来实现，该算法是早期比较有代表性的深度学习在OCR识别任务中的应用，在2014-2015年一直保持领先地位。</p></li><li><p>2016年中科院深圳先进技术研究院乔宇老师研究组，基于目标检测模型<a href="https://arxiv.org/abs/1506.01497">FasterRcnn</a>开发了适用于文本行检测的深度学习模型<a href="https://arxiv.org/abs/1609.03605">CTPN</a>。</p><img src="/2019/03/13/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-OCR-%E4%BB%8E%E9%9B%B6%E5%BC%80%E5%A7%8B/CTPN.png" class="" title="CTPN"><ul><li><p>根据文本检测任务中文本区域的特点，设计了区别于常规目标检测任务的文本区域划分方案；</p></li><li><p>在VGG模型最后一层的特征图上进行AnchorBox计算，计算方法与FasterRcnn相同；</p></li><li><p>在计算过程中考虑上下信息，将每行的文本特征输入到双向LSTM中以便更好的判断文字区域的概率</p></li><li><p>判断文字的高度，起始位置和终止位置</p></li></ul><p>CTPN首次在场景文字检测中使用RNN方法，但是受限于CTPN的文本区域划分方案，该算法模型默认只能用于输入图像的水平文本检测。</p></li><li><p>同样是在FasterRcnn的基础上改进而来，<a href="https://arxiv.org/abs/1703.01086">RRPN</a>对AnhocrBox进行了设计，在原FaterRcnn中RPN网络的AnhorBox的基础上加入了角度旋转信息，设计了RRPN网络用以生成带角度信息的文本区域提议，此外，为了适应RRPN，将原FasterRcnn中ROI进行改进设计了RROI，以实现可以计算处理任意方向的文本提议区域。</p><img src="/2019/03/13/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-OCR-%E4%BB%8E%E9%9B%B6%E5%BC%80%E5%A7%8B/RRPN.png" class="" title="RRPN"></li><li><p>基于文本在图像中是具有不规则多边形的轮廓的角度思考，<a href="https://arxiv.org/abs/1703.01425">DMPNet</a>将目标检测任务中目标区域为矩形框修改为多边形目标区域，在目标检测模型<a href="https://arxiv.org/abs/1512.02325">SSD</a>的基础上进行整个模型的设计。</p><img src="/2019/03/13/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-OCR-%E4%BB%8E%E9%9B%B6%E5%BC%80%E5%A7%8B/DMPNet.png" class="" title="DMPNet中Anchor生成"><p>如图是<code>DMPNet</code>中关于<code>Anchor</code>的的设计方案，在图<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>a</mi></mrow></semantics></math></span></span>中，如果使用用于的目标检测的<code>Anchor</code>生成方法，得到的检测区域是蓝色虚线部分，因为在传统的<code>Anchor</code>生成过程中，先验的<code>Anchor</code>都是矩形形状，因此得到的检测框肯定也是矩形的，但是在街景<code>OCR</code>中，使用矩形的区域进行文本区域检测显然会引入更多的背景信息，对后续的文本识别带来干扰。在<code>DMPNet</code>中的<code>Anchor</code>设计使用的是图<code>C</code>这种方式，加入了旋转角度，这样的<code>Anchor</code>设计会检测到图<span class="katex-inline" data-math-rendered="katex"><span class="katex"><math xmlns="http://www.w3.org/1998/Math/MathML"><semantics><mrow><mi>a</mi></mrow></semantics></math></span></span>中红色虚线的区域，显然相比于传统目标检测得到的结果更优。</p></li></ol></li></ul><h5 id="文本识别"><a href="#文本识别" class="headerlink" title="文本识别"></a>文本识别</h5><p>检测之后肯定就是识别了，由于2019年中旬之后更换工作，没有太多关注OCR相关方面的发展，根据我曾经的浅薄的经验，使用何种文本识别技术基于我们使用了何种文本检测技术，尤其在工业界，我们的目的是输出图片中的信息，而不是检测的检测到文本区域。</p><p>前面已经说过了，目前的主流做法是基于目标检测的文本检测实现方案，检测到的一般情况是文本区域而不是单个的字，这个时候我们在进行文本识别的时候显然也要对文本区域进行识别，现在的<code>CNN</code>技术发展迅速，几乎都快到瓶颈了，这些我们先不管，我们只需要知道对于文本识别目前来讲基于<code>CNN</code>是一种非常可行的方案，不管是<code>CRNN</code>(将<code>CNN,RNN</code>联系起，模拟语音识别的方法建立前后文联系)，还是<code>CNN+CTC</code>的方案，都是将文本区域使用<code>CNN</code>进行特征提取，然后使用<code>NLP</code>中解决方案。</p><p>至于更传统的单字符识别目前应该没有人使用了，这里也就不过多介绍了。关于该部分的内容，如果想了解更多，我也写过针对<code>OCR</code>的一篇博客<a href="%5Bhttp://xiaofengshi.com/2019/01/05/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-OCR_Overview/%5D(http://xiaofengshi.com/2019/01/05/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-OCR_Overview/)">文章: 深度学习-OCR_Overview</a></p><h2 id="深度学习技术实现方案综述"><a href="#深度学习技术实现方案综述" class="headerlink" title="深度学习技术实现方案综述"></a>深度学习技术实现方案综述</h2><p>前文已经对深度学习在<code>OCR</code>上的应用有所涉及，目前的不论学术界还是工业界应该都已经抛弃了传统的直方图或单字符识别的研究和投入，但是，还是那句话，最后的算法是在满足需求的条件下尽可能节省算力，如果我们的场景是具有规定排版样式的场景，比如扫描合同，身份证，银行卡，发票单据等，这些使用传统方法实际上完全可以<code>cover</code>住，没有<code>low</code>的算法，只有<code>low</code>的开发者，这是近一年来在字节我最大的收获。</p><p>接下来说一下目前的主流解决方案，<code>OCR</code>目前来讲分为两个过程文本区域检测和文本识别，目前应该还没有<code>End2End</code>的解决方案。这两个过程主要就是上面所说的那样，文本检测一般是基于目标检测来实现，文本识别一般是不定长文本识别，因此更多的采用的是<code>NLP</code>中关于语音识别的相关方法。</p><h2 id="连续文本提议网络-CTPN-模型原理"><a href="#连续文本提议网络-CTPN-模型原理" class="headerlink" title="连续文本提议网络(CTPN)模型原理"></a>连续文本提议网络(CTPN)模型原理</h2><p>这一部分，我已经写作一篇博客了，可以看一下这里<a href="%5Bhttp://xiaofengshi.com/2019/01/23/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-TextDetection/%5D(http://xiaofengshi.com/2019/01/23/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-TextDetection/)">深度学习-TextDetection</a></p><h2 id="卷积循环神经网络-CRNN-模型原理"><a href="#卷积循环神经网络-CRNN-模型原理" class="headerlink" title="卷积循环神经网络(CRNN)模型原理"></a>卷积循环神经网络(CRNN)模型原理</h2><h2 id="常用卷积网络模型结构"><a href="#常用卷积网络模型结构" class="headerlink" title="常用卷积网络模型结构"></a>常用卷积网络模型结构</h2><h2 id="DenseNet和CTC解码原理及代码实现"><a href="#DenseNet和CTC解码原理及代码实现" class="headerlink" title="DenseNet和CTC解码原理及代码实现"></a>DenseNet和CTC解码原理及代码实现</h2><h2 id="深度学习的数据标准化原理及选择"><a href="#深度学习的数据标准化原理及选择" class="headerlink" title="深度学习的数据标准化原理及选择"></a>深度学习的数据标准化原理及选择</h2><h2 id="序列到序列算法模型原理"><a href="#序列到序列算法模型原理" class="headerlink" title="序列到序列算法模型原理"></a>序列到序列算法模型原理</h2><h2 id="不定长文字识别的编码器设计及代码实现"><a href="#不定长文字识别的编码器设计及代码实现" class="headerlink" title="不定长文字识别的编码器设计及代码实现"></a>不定长文字识别的编码器设计及代码实现</h2><h2 id="注意力机制原理详解"><a href="#注意力机制原理详解" class="headerlink" title="注意力机制原理详解"></a>注意力机制原理详解</h2><h2 id="解码器的贪婪搜索和集束搜索选择和实现"><a href="#解码器的贪婪搜索和集束搜索选择和实现" class="headerlink" title="解码器的贪婪搜索和集束搜索选择和实现"></a>解码器的贪婪搜索和集束搜索选择和实现</h2><h2 id="循环神经网的模型设计策略及代码实现"><a href="#循环神经网的模型设计策略及代码实现" class="headerlink" title="循环神经网的模型设计策略及代码实现"></a>循环神经网的模型设计策略及代码实现</h2><h2 id="搭建中文OCR任务pipeline"><a href="#搭建中文OCR任务pipeline" class="headerlink" title="搭建中文OCR任务pipeline"></a>搭建中文OCR任务pipeline</h2><h2 id="技术总结及触类旁通"><a href="#技术总结及触类旁通" class="headerlink" title="技术总结及触类旁通"></a>技术总结及触类旁通</h2>]]>
    </content>
    <id>https://xiaofengshi.com/2019/03/13/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-OCR-%E4%BB%8E%E9%9B%B6%E5%BC%80%E5%A7%8B/</id>
    <link href="https://xiaofengshi.com/2019/03/13/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0-OCR-%E4%BB%8E%E9%9B%B6%E5%BC%80%E5%A7%8B/"/>
    <published>2019-03-13T16:03:05.000Z</published>
    <summary>
      <![CDATA[<p>本篇详细说明了OCR的应用，技术实现，当前相关进展等，不定时补充更新。</p>
<p>本篇博客最初想写成一本掘金小册，可是掘金的那边看了我的提纲说太难了，应该没什么受众，额……，那我就自己写一下记录下来，不会太讲究斟词酌句了，希望见谅。</p>
<p>本篇博客算是一篇针对OCR相关学习或者初步接触者的引导和入门，讲的不深，实际上针对每个模块，比如<code>CTPN</code>，<code>CTC</code>，<code>Attention</code>，<code>Densenet</code>这些我都有专门写过博客来讲述过，感兴趣的可以翻翻我的博客文章。</p>
<p>更新记录：</p>
<p>2020.01.31: 自从19年4月份入职字节跳动之后一直忙于工作，很久没有更新个人博客了，今天看到各位的留言很是感动，为自己长久的拖延感到羞愧。由于武汉肺炎延迟开工，今天努力把以前写的提纲补充齐全，这一年来，相比于之前增加了更多的工业界算法思维，一个好的算法是在能够实现预定目的的同时，尽可能节省算力的，接下来也会把自己的一些感触和经验体现在博客里面。</p>]]>
    </summary>
    <title>深度学习-OCR-从零开始</title>
    <updated>2020-08-22T22:04:21.000Z</updated>
  </entry>
</feed>