本来以前深入看过CTC的相关论文,前段时间有人问我相关算法原理,瞬间懵逼,以前看过的东西愣是一点没记起来,这就很尴尬了,本人在ocr任务的文字识别中还用过相关的解码方式,一定要搞明白为什么这种方法是可行的。在这里对CTC进行分析和总结,还是验证是否掌握的最好方法就是看能否做到有效的输出,主要参考论文和相关讲解博客。
先上图
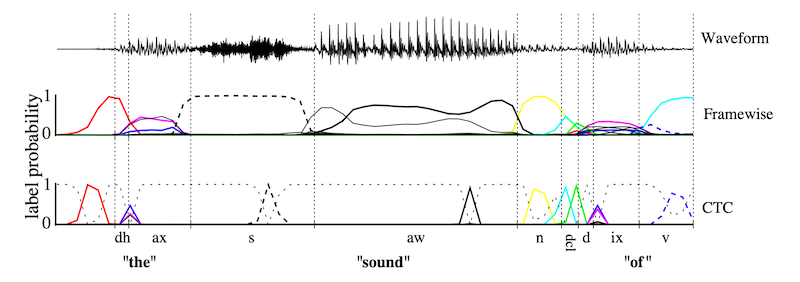
NLP解码方式
在NLP相关任务中,如机器翻译,语音识别中,输入和输出均为序列,目前主要存在着两种模型架构方式,一种是基于seq2seq的模型框架(目前的主流方式),另一种是基于CTC的解码方式(方法更老一些,在一些任务重仍然在使用,语音识别,不定长文字识别等)。
- Seq2seq
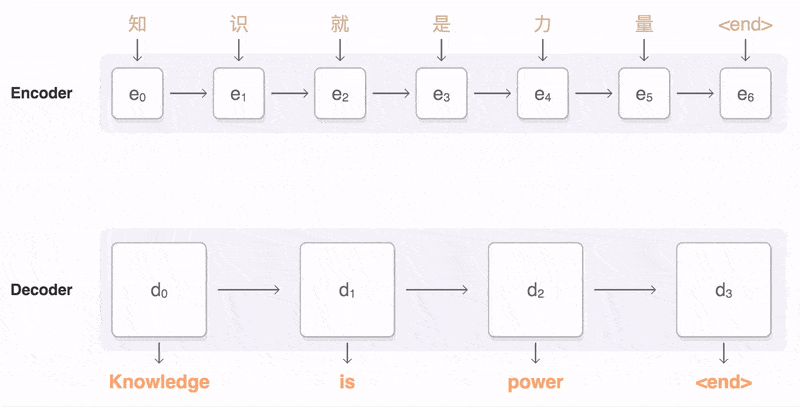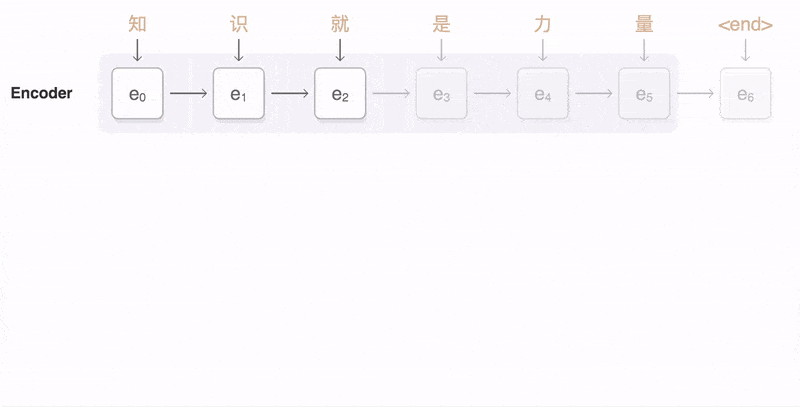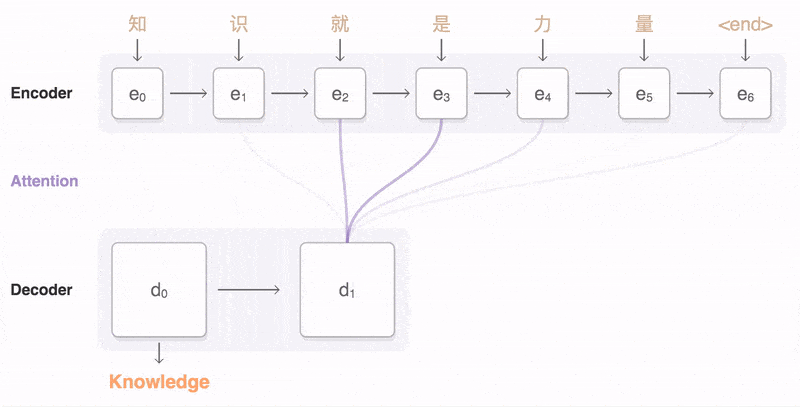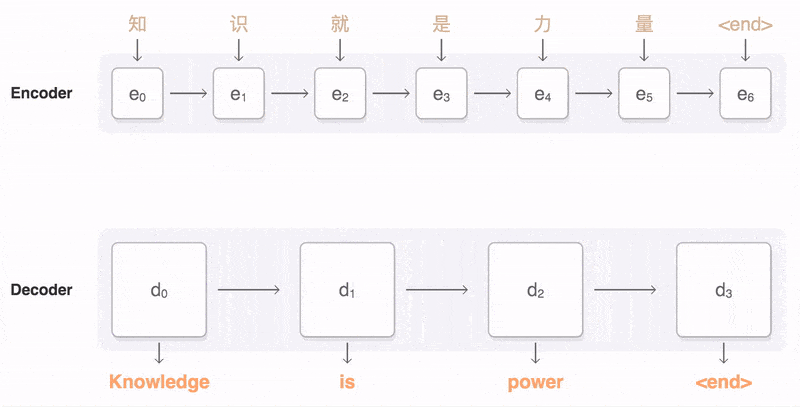
如图中所示,对于seq2seq框架分为encoder和decoder,encoder部分对输入序列进行编码,decoder部分对编码之后的序列进行解码输出。使用seq2seq的方式可以解码输入序列和输出序列不一致的任务,并且不需要对训练数据的label进行对于,只需要保证长度一致即可,例如,输入的是一段语音,输出的是对应的文字,一般情况下输入的序列长度和输出的序列长度是不一样的,在seq2seq模型中,首先将输入的语音序列进行mfcc提取因素,之后进行编码,编码之后的序列长度和输入的序列长度相同;在传统的seq2seq中使用编码之后的最后一个时间步的隐藏层输出(认为该隐藏层中保存着输入序列的全部信息,显然对序列较长的情况下,会造成大量的信息丢失,因此也就有了之后的attention机制)作为decoder的初始输入,输出的序列长度由数据中的label的序列长度决定,这样就可以解决输入输出序列长度不同的情况,并且不需要对数据进行对齐,只需要知道输入的语音中对应的文字是什么,而不需要具体知道每个音节是什么。
- CTC
另一种解码方式是基于CTC的解码策略,在没有提出CTC策略之前,对于语音识别任务,要对输入的语音和目标文本进行对齐,这就需要繁琐的特征工程。而CTC策略就是针对该任务提出的,不需要对输入的序列进行label对齐,将原来的单音节的正确率的计算转义到输出序列的正确率计算上,比较的是输入的序列数据经过神经网络之后得到的预测输出和真实的输出之间的差距。
此外有一点需要格外明确,CTC只能处理输出序列比输入序列短的任务
CTC详解
参数说明
如下这些参数会在下面介绍中出现,再次先进行一下声明,本文中所用参数符号和论文一致。
输入
输入样本数据
输入样本数据
输出集合
正常的label
CTC输出的label全集
输出序列
输出的序列路径
输出的label序列
路径多对一映射关系,将不同的路径去除空格去除重复字符
概率说明
在时间步t输出k的概率
在时间步t的在节点k上神经网络的输出,满足关系式
表示在输入数据为x的情况下输出路径的概率
表示输出label序列的概率是满足变换条件的多条路径的概率之和
前向传播和后向传播
表示时刻t在节点s的前向概率值
表示时刻t在节点s的后向概率值
在语音识别任务中,输入的序列为,对应的长度为,定义一个神经网络来代表对输入数据的处理过程,实现对输入序列的特征提取和非线性变换,使用表示神经网络经过softmax标准化之后的输出,令表示在时间步t输出为的概率,属于整个字表和观察字符的并集中。使用表示整个字表,那么在CTC中在原字表基础上加入一个空格字符表示观察字符,由此,模型的字表为,满足关系式。
对于输出的满足关系式,此处使用的是softmax进行处理。具体过程如下图所示。
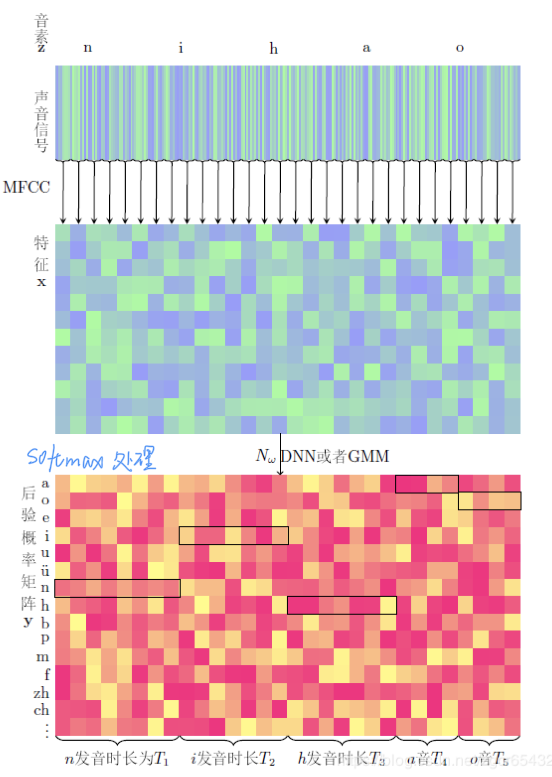
给定数据,预测的序列为,也就是在每个时间步预测的结果的连乘
路径和变换
使用表示经过预测输出的序列,表示一条由中的元素组成的长度为的路径,而对于变换为一个多对一的映射函数,满足
将输入的字符串中的空格和重复字符删除来实现对输入数据的压缩,使用表示给定序列的label,对于模型的预测输出有很多种,输出路径经过变换之后与给定label的路径有很多,由此可以得到给定输入数据之后模型的预测输出与label一致的概率就等于所有满足经过变换之后与给定label相同的可能路径的总和,满足如下关系式
其中表示路径经过变化之后和给定的label一致,也就是满足
假如给定的label为“nihao”,那么可能的路径为
“nniihhaaaaaoooo”
“nnnnniiiihhhaaao”
“nniiiiiihhhhhaaao”等等
路径的长度均为,这些路径经过变换之后都能变为给定的label,也就是都可以变为“nihao”。因此目标函数就应该是在给定输入序列的情况下输出满足变换之后与给定的label相同所有序列的概率之和的最大值,也就是使得预测的序列跟给定的label最大概率
但是这里存在一个问题,那就是对于给定的label,那么满足B变换之后和给定label相同的可能的序列的数量实在是太多。
输入序列的长度为,整个词表的大小为,当前label中包含的的label的数量为,那么可能的序列数量为,这么多的数量显然是无法计算的,并且随着输入序列的长度的增加,计算量指数级增加。
CTC模型的训练
forward前向预测过程
为了保证模型能够进行训练,使用了DP动态规划的方法。引入一个变量表示从初始时刻到当前时刻所有可能的正向路径的概率之和(到当前时刻之前输出的序列经过B变换之后和给定的label之间是相同的),公式如下
这显然就是一个动态规划的问题,如果在时刻t的预测的字符为,那么在上一个时刻可能是字符或者可能是的,也就是满足递归关系式,其中表示在label中的第个字符
在CTC处理中,为了区分实现对label字符之间的分割,对label进行了插入空格符的处理,在给定的label的前后及相邻字符之间插入空格符,新的label变为,那么新的label为的长度变为。
在前向传播整个生成过程为从左向右生成,时间步1生成的字符只允许为空格(使用b表示),或者为原来label中的第一个字符,因为在时间步的左侧已经不存在其他的字符预测,因此在时间步上,进行了如下的限制:
在其他时刻满足如下关系式
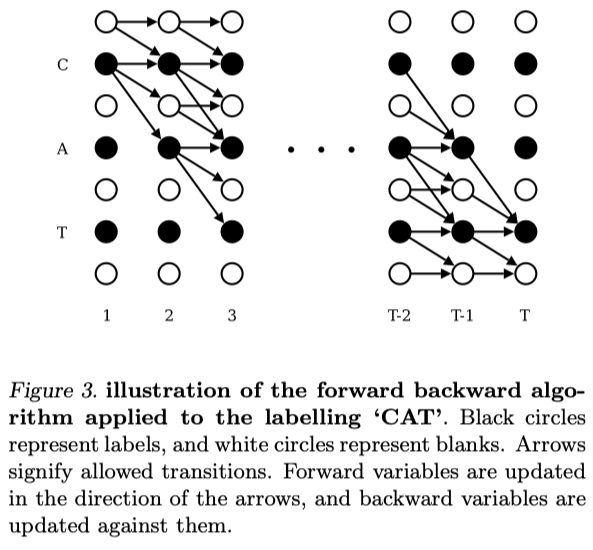
对上面的公式进行说明:
由于对原始的label进行了插入空格的处理,
例如原始为“abbd”,经过处理之后变成了“-a-b-b-d-”,label发生了变化。
在计算时,对于时刻取到新的label中第个字符的计算要进行特殊处理,如果第s个字符是空格,或者当前字符和字符相等,那么当前取到字符,上一个时刻只能取到字符s或者s-1,也就对应着方程组中第一个式子,即
使用“-a-b-b-d-”举例说明
- 当在时刻取到字符第二个的时候,那么上个时刻可能取到之前的一个空格,或者当前的第个,只有这样,经过变换,才能得到“bb”这样的输出;
- 如果时刻取到了空格字符,那么上一个时刻只能取到前一个字符或者当前同样位置的空格;
当然也存在另外的情况,那就是当前时刻取到的不是空格字符并且当前字符也不和相同,那么在时刻取到字符,在上一个时刻可能取到中的三种可能,即
同样使用例子“-a-b-b-d-”说明,
- 如果当前时刻取到的既不是空格字符,也不满足,在例子中,可以看成在时刻t取到字符“d”那么上一课时刻可能取到的是当前位置的“d”,也有可能是上一位的空格字符,也有可能是再上一位的“b”,也就是对应着公式中的第二种情况
在前向过程中,传播过程如图所示
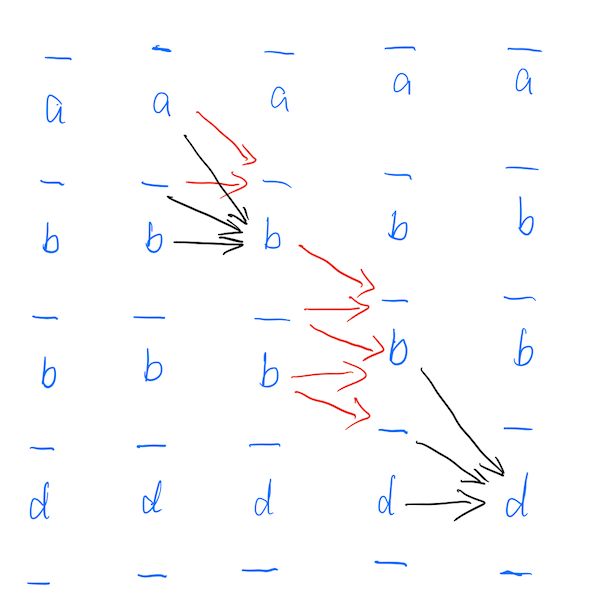
红色线所示为第一种的情况,黑色线所示为第二种情况。经过上面所述的前向传播迭代,最终可以得到在给定输入数据x的情况下得到目标label序列的概率,也就是
也就是在最后的时间步,预测的只能是中的最后一个字符(空格符)或倒数第二个字符(真实字符)。
反向传播
和前向传播过程相同,将箭头反转就可以得到CTC的反向传播过程,同样定义表示在时刻,预测序列取到的字符为label中第s个字符的所有可能的路径的概率之和
那么存在的递归关系式实际上和前向过程相同,就是将改变成即可。同样对于左右侧的预测输出,必须是最后一个空格或者最后label中的最后一个字符,公式如下所示
对于小于时间的情况,公式如下所示
整个后向的传播过程实际上就是前向传播过程的箭头反转
存在的问题
由于序列预测过程中,按照上述的递归过程,每个时间步上对结果的预测时基于上一步预测的结果,为了求得序列的概率,因此这就是一个概率连乘的情形,非常多个小于1的数相乘,在计算时很容易造成数据下溢,导致无法计算。在论文中提出的解决方式是,在每个时刻t预测得到之后进行尺度缩放,将当前时刻能够取到的所有求和作为当前时刻取得的所有序列的概率之和,之后再当前时刻得到的每个与和概率作比作为下一层的概率进行写一个时刻的迭代
其中代表经过缩放之后进行下一时刻传递计算的概率
加入在时间步预测的字符包含三种
因为概率是从上一步基于上面所述的正向传播的传递方式传递过来的,因此概率值会非常小,在此处对得到的概率进行缩放,但是并不影响当前时间步预测的不同字符之间的相对概率的大小(因为在此处的概率的变化是线性的),因此对后续时间步的计算不会产生负面影响。
对反向传播进行同样的缩放
优化目标
在训练的过程的优化目标就是最大化似然估计,对于给定的输入数据为,得到的预测序列经过变换之后与标准label相同的概率,使用最大似然估计的方法得到优化目标
其中对应着整个训练集,输入的样本,为对应的label
针对每个样本,对于给定样本,输出数据与label相等的概率为
使用对数似然是为了将概率连乘变为连加。
在分析前向传播和后向传播是,定义了两个表示在时间步序列概率的式子和,对两个式子进行相乘即可表示整个序列的概率
表示预测的输出序列经过B变换之后和给定的label相同的概率之和
由于存在关系式
因此对上面的式子进行整理可以得到如下
有因为存在着
可以得到
上式就对应着优化目标,只考虑在时刻t经过节点k的路径,对上式求偏导
误差反向传播
整理前面部分的优化目标
因为在此处对应的是在时刻输出为的概率,是根据神经网络的输出经过softmax变换之后得到的概率值,这是一个固定变换,没有学习参数需要反向更新,神经网络的输出为,则存在着变换关系式
由此可以得到
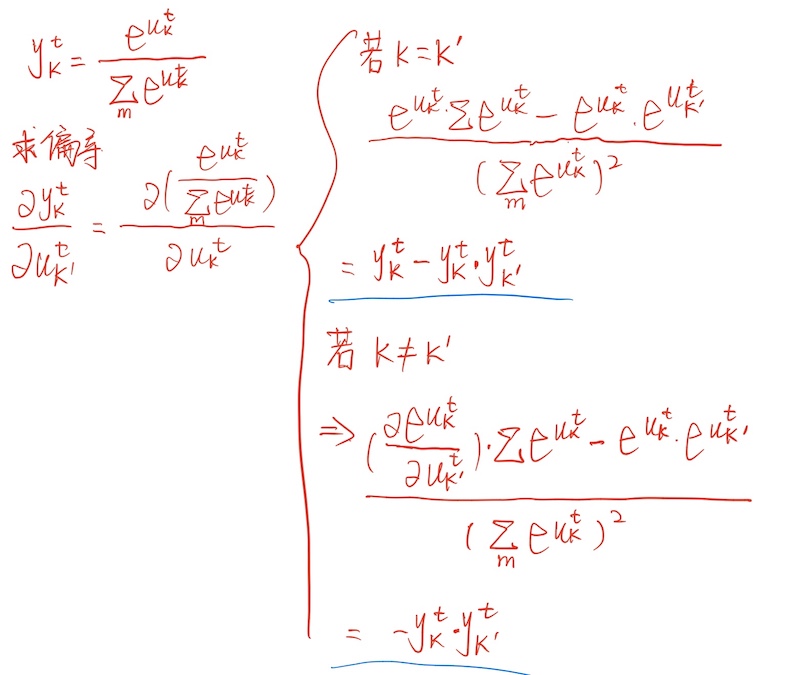
因此对上面的优化目标进行再次整理为
由此得到在训练的时候每一步对参数的更新,此时的对应着神经网络的输出,对于之后的网络使用BPTT或者BP进行更新