从2020年8月左右开始接触多模态,当时也是业界多模态刚起步的阶段,到现在为止,经过了两年半左右的时间,多模态也经历了一系列的发展和工业界应用,这里进行一下总结回顾。
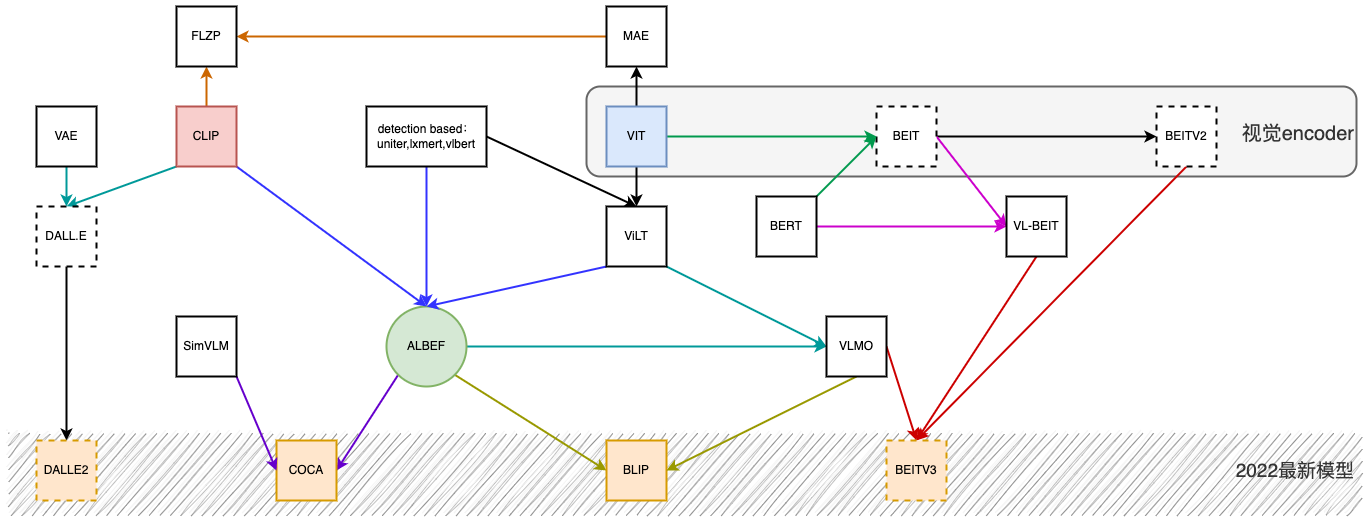
首先说,什么是多模态,目前在学术界和工业界更多还是说的图文多模态,那么在模型的角度上,要做的就是如何将图像和文本编码到一起。由此,多模态被拆分出来这么几个问题:
- 视觉部分的特征如何提取
- 关键词:FasterRcnn,Resnet50,VisionTransformer
- 文本的特征如何提取
- 关键词:Bert,Roberta,Albert
- 多模态之间如何交互
- 关键词:esim,transformer
- 多模的任务如何设计
- 关键词:ITC,ITM,MLM,MIM
在深度学习领域,哪些部分会影响模型的效果呢,经过这几年的学习和积累,目前总结了这几个方向
- 更高的数据质量,更大的数据规模,已经被多种模型和对比实验反复验证的策略
- 比如T5的数据筛选,ALBEF的动量蒸馏,BLIP的capfit策略
- 这是一个长久并且非常重要的方向,因为随着业务的开展会发现数据才是王道。
- 增大模型的容量和复杂度
- 比如bert larg,T5让模型更深,albert让模型更宽到4096维度
- 在业务中先把模型做的更大更深,拿到更高的性能,然后再进行模型蒸馏,就是这个思路
- 更充分的预训练,Roberta训练的batchsize变大,步数增加
- 这可以看成是一个训练策略了,为了对比模型或策略是否有效,在学术界或工业界一般采用的都是固定的训练配置,这里不过多赘述
- 业务中训练多少步,bsz多大要有对比实验来支撑。
- 有难度或合理的的训练任务
- NLP方向中有albert的sop,Roberta的动态mlm,spanbert的replace span策略
- 多模方向中有ALBEF的ITC、ITM,BEIT的MIM等任务设计
具体到多模态领域,还有一个方向是多模统一框架模型,目前业界的共识是,多模态应该有一个统一的foundation model,它可以cover不同的模态,并能适配不同的下游任务,这个方向是有VLMO,Perceiver-IO,BEIT3
多模态领域也是归纳到这几个方向上,如上图所示,几个重点的模型有Vit,CLIP,ALBEF,VLMO,BEIT。下面会对这些模型进行简要说明,并且后续会对重要的模型进行重点说明。
更好的视觉编码器
CNN based
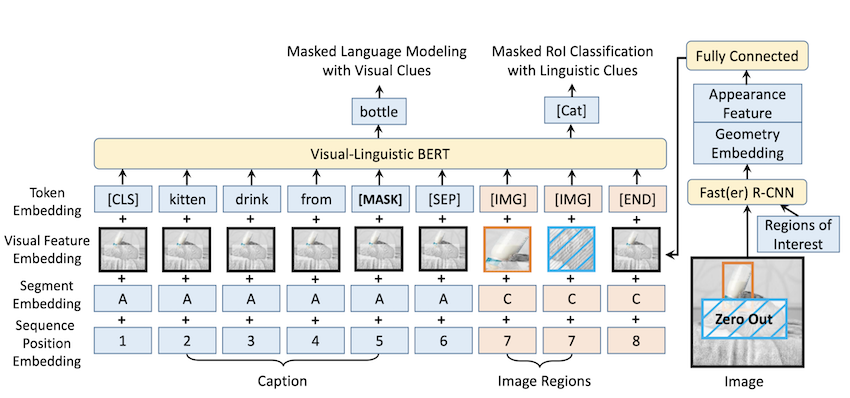
在2020年的多模态模型,大量的多模态视觉encoder使用的是detection based方案,当时比较流行的模型有UNITER,VL-BERT,LXMERT,使用目标检测的得到的视觉特征当做image-token-sequence使用,和text-token拼接起来,交互方式使用的是transformer结构。这就是端到端多模态模型最开始的样子。如下是当时有名的VL-Bert的模型结构
ViT
基于目标检测的视觉方案缺点很明显,就是非常笨重。在2021等来了vision transformer,使用基于transformer的方式进行图片分类,验证了transformer对视觉的处理能力。至此,detection based的模型退出历史舞台,vision transformer正式接棒,当做视觉encoder直到现在。
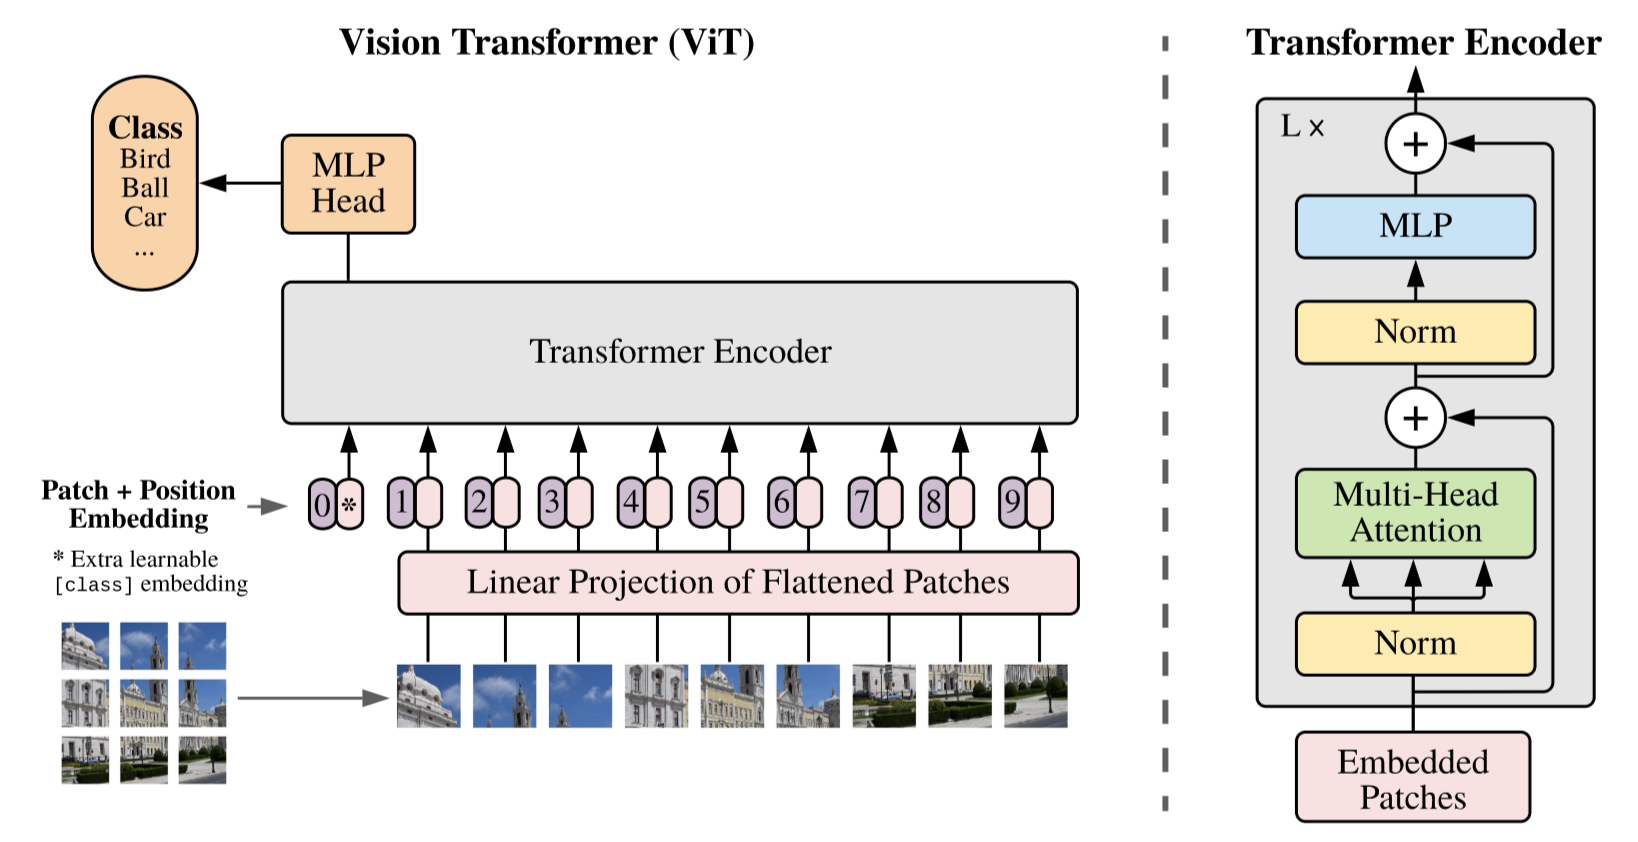
在这个时间点看,在多模态领域使用基于transformer的vit方案,是比基于CNN的视觉方案更优的选择,不仅仅是transformer结构的性能的问题,而是在多模态领域,transformer有更好的适应性,既能处理文本特征,又能处理视觉特征,有助于模型结构的统一,Vit很大程度上影响了后续多模态的发展方向。
更合理的任务设计
CLIP
ViT提出之后多模态领域出现了一篇现象级论文CLIP,使用两个独立的encoder和对比学习策略来进行zero-shot的图像分类任务,并验证了非常好的性能,至此对比学习正式进入多模态领域的任务设计。模型结构非常简单,训练方式非常直接,并且在retival领域验证了非常好的性能。
Historical media is unavailable in this archived article.
ViLT
在ViLT中,可以看成将视觉encoder由基于检测的方案换成ViT之后的VL-Bert,视觉侧使用ViT的patch embedding+linear projection,文本侧使用Bert特征,并用多层transformer进行交互。
Historical media is unavailable in this archived article.
ALBEF
在模型结构设计上,ALBEF可以看成是CLIP的对比学习策略和ViLT模型的合成体。ALBEF是一个非常棒的模型,尤其是在理解类型任务中;本文先概述它的关键设计。
ALBEF主要解决的是多模交互和数据噪声的问题,
- 两个没有关系的模态直接用transformer进行交互,会导致性能不好,所以在交互之前先进行跨模态之间的对齐,这样有助于多模态交互的时候学习;
- 训练数据是存在很多噪声的,所以在ALBEF中引入了MOCO中的动量蒸馏策略,来修正数据的标签。
ALBEF整体的结构如下
Historical media is unavailable in this archived article.
ALBEF大体的贡献有如下几点:
- 模型的整体结构与ViLT基本一致,是一个品字形结构,一共有3个encoder,分别对应language,visual,visual-language-multimodal,来进行特征提取和多模特征融合;
- 借鉴CLIP的对比学习思路,两个单模态交互之前进行对比学习,提前将两个模态进行特征对齐,有助于多模之间进行融合;
- 加入了动量蒸馏设计,修正网络数据中的噪声标签;
- 总共有5个Loss
- ITC,ITM,ITM_momentum,MLM,MLM_momentum
从本篇文章最开始的图中能看到,ALBEF对后续很多模型产生了影响,是一个非常重要的模型。交互之前使用对比学习进行对齐这一思想在后续的COCA,BLIP也被体现
更统一的模型结构
VLMO
VLMO可以看成是ALBEF的工程优化模型,并且VLMO提出的方案在后续的BLIP,BEIT_V3中被借鉴使用。在ALBEF中包含3个独立的encoder,存在这参数量较大的情况,在VLMO中,提出了共享MHA模块,训练各自的FFN部分的模型设计方案。这样可以实现多模态模型参数的有效减少,此外MHA共享参数,这样相比于ALBEF有更好的多模表现能力。
这里值得一提的是,为什么可以共享MHA,记得在AlBert中测试过transformer中各个部分共享参数对指标的影响,试验显示,多层之间共享MHA部分的权重并不会降低模型的性能,验证了MHA对于不同层次特征的捕获能力,那么在不同模态之间共享MHA是否也可以呢?通过本文的实验指标,可以看出答案是肯定的,这说明MHA这一结构在横向纵向的参数共享仍能保持性能,MHA这一结构感觉仍值得继续挖掘使用。
Historical media is unavailable in this archived article.
模型结构不需要过多赘述,整个模型就是一个MHA共享参数,FFN单独训练的多层transformer模型。整个模型包含3个FFN,分别对应视觉,文本和多模。
VLMO模型分阶段训练的:
第一步,训练V-FFN,这一步使用的是机遇CLIP方式训练的ViT模型,经过这一步mha+v-ffn具有对视觉模态的语义刻画能力;
第二步,固定MHA,训练L-FFN部分,这部分使用纯文本数据,使用MLM的LOSS,经过这一步L-FFN具有文本语义能力;
第三步,开放全部权重,训练多模数据,这里包含多个多模任务,这里的任务设计和ALBEF一致,没有用动量蒸馏的策略
ITC:训练MHA,V-FFN,L-FFN使模型有多模态之间的对齐能力;
ITM:训练MHA,V-FFN,L-FFN,VL-FFN,使多模之间有进行交互,提升模型对多模的语义关系对齐能力,这里也用了和ALBEF中一样的hard negative mining的策略,筛选难负例送到下游交互来算ITM损失;
MLM:训练MHA,V-FFN,L-FFN,VL-FFN,对文本部分进行mask,使用全量视觉特征和剩余的文本信息对mask的文本进行预测,使模型具有多模之间信息补充能力。
第三阶段多模Loss部分如下图所示
Historical media is unavailable in this archived article.
BLIP
沿着ALBEF和VLMO继续发展,到了2022年,ALBEF的原班人马打造了BLIP模型,这篇文章中作者将ALBEF和VLMO的优点进行了结合,提出了统一的模型框架来适配不同的下游任务,和一套行之有效的数据筛选策略。
BLIP这篇论文研究动机有两个:
- encoder-based的模型,例如CLIP,ALBEF没办法做生成类型的任务;encoder-decoder的模型,例如SimVLM没办法做retrieval任务,所以一个能cover不同类型的下游任务的统一框架模型是有必要的。
- 与训练的数据基本都是从网上爬下来的,所以高质量的数据是有必要的,在ALBEF中用的是动量蒸馏的方法来进行标签修正,在BLIP中作者更进一步,提出了一个离线数据筛选策略。
那么对应的BLIP的主要贡献就是这两个了。后续会开一个单独的文章进行详细说明,这里简要说一下。
模型
模型结构如下所示,可以看到ALBEF和VLMO的影子
- 整个模型包含3个encoder和1个decoder(为了能cover生成类型任务);
- 图中相同颜色的模块共享参数,这里明显借鉴了VLMO的思想;
- 任务设计上,除了将MLM换成了适配生成任务的LM(GPT用的loss),其他的ITC,ITM走的ALBEF的路子;
- Image-grounded text encoder和Image-grounded text decoder的数据输入方式,借鉴了GPT的思路,将任务编码到输入数据中;
- 为了适配生成任务,Decoder中加了一个因果自注意力模块,也就是masked attention,这里和transformer的decoder一致。
Historical media is unavailable in this archived article.
可以看到BLIP集成了多种模型已经验证有效的优点。
数据
在数据上,除了继续保留了ALBEF基于动量蒸馏的训练策略之前,提出了一个基于caption-filter模型的数据筛选策略。简而言之,先用全部数据训练第一版模型,然后用这个模型对数据进行筛选和扩增,产出更高质量的数据,再用这个新数据在第一版模型基础上再训练第二版数据,如此得到最终模型,一个典型的self-training的思路,有点对第一版模型进行蒸馏的感觉。
Historical media is unavailable in this archived article.
COCA
论文链接:https://arxiv.org/pdf/2205.01917.pdf
coca是google的一篇工作,提出一个foundation model,模型结构和ALBEF实在是太像了,主要三个地方不同,
- 一个是encoder换成了decoder,任务换成了LM,这里和BLIP,GPT一致;
- 另一个视觉部分的encoder使用attention pooling之后在于text部分进行corss-att交互
- 去掉了ITM loss
Historical media is unavailable in this archived article.
训练完之后,可以直接用来做下游任务
Historical media is unavailable in this archived article.
COCA比BLIP的提出晚了大约4个月的时间,模型的设计方面可说的倒是不多,在数据上COCA用了更大量的数据,将COCA的效果进行了大幅度的提升,基本在各个下游的单项任务上进行了刷榜。
Historical media is unavailable in this archived article.
NLP预训练的发展
预训练模型
Word2Vec->ELMo->GPT->BERT->MT-DNN->GPT2
WordEmbedding
在说Word Embedding之前,先更粗略地说下语言模型,因为一般NLP里面做预训练一般的选择是用语言模型任务来做。
Historical media is unavailable in this archived article. |
什么是语言模型?
看上面这张图就明白了,为了能够量化地衡量哪个句子更像一句人话,可以设计如上图所示函数,核心函数P的思想是根据句子里面前面的一系列前导单词预测后面跟哪个单词的概率大小(理论上除了上文之外,也可以引入单词的下文联合起来预测单词出现概率),看图片中的分解公式,明显的马尔科夫链。句子里面每个单词都有个根据上文预测自己的过程,把所有这些单词的产生概率乘起来,数值越大代表这越像一句人话。
2013年之前的语言模型
在2013年的时候,最火的用语言模型做Word Embedding的工具就是Word2Vec。Word2Vec有两种训练方法:
- 第一种叫CBOW,核心思想是从一个句子里面把一个词抠掉,用这个词的上文和下文去预测被抠掉的这个词,是不是跟BERT的MLM很相似;
- 第二种叫做Skip-gram,和CBOW正好反过来,输入某个单词,要求网络预测它的上下文单词。
word2vector的缺陷在哪里?
Word Embedding对于很多下游NLP任务是有帮助的,只是帮助没有大到很了不起的程度。那么问题来了,为什么这样训练及使用Word Embedding的效果没有期待中那么好呢?
答案很简单,因为Word Embedding有问题。最大的问题就是多义词。因为对于一个多义词尽管上下文环境中出现的单词不同,但是在用语言模型训练的时候,不论什么上下文的句子经过word2vec,都是预测相同的单词,而同一个单词占的是同一行的参数空间,这导致两种不同的上下文信息都会编码到相同的word embedding空间里去。所以word embedding无法区分多义词的不同语义,这就是它的一个比较严重的问题。
对于这个情况,ELMo给出了一个简洁优雅的方案。
ELMo 2018
论文链接:
代码链接
博客讲解:
https://www.cnblogs.com/huangyc/p/9860430.html
https://zhuanlan.zhihu.com/p/63115885
虽然是一个比较老的模型了,但是这个模型对后面的bert,gpt都是有启发意义的。之前说到词向量,用的是word2vec的方式,因为在它提出的词向量概念给NLP的发展带来了巨大的提升。而ELMo的主要做法是先训练一个完整的语言模型,再用这个语言模型去处理需要训练的文本,生成相应的词向量,所以ELMo的模型对同一个字在不同句子中能生成不同的词向量,所以说,ELMO最重要的一点是训练一个语言模型。
| 结构:双向LSTM模型,一个前向一个后向语言模型 特征:得到三个特征,E1,E2,E3 三者共同构建下游任务输入 目标函数:预测对应位置的下一个单词,T1的label是E2 | Historical media is unavailable in this archived article. |
|---|---|
| 下游任务 | Historical media is unavailable in this archived article. |
| from https://zhuanlan.zhihu.com/p/54578457 |
总结:ELMo通过语言模型任务得到句子中的单词的向量,这个向量是结合左向右向的信息,但是仅仅是拼接的实现。
ELMo为什么比word2vector有效?
- ELMo的假设前提一个词的词向量不应该是固定的,所以在一词多意方面ELMo的效果一定比word2vec要好。
- word2vec的学习词向量的过程是通过中心词的上下窗口去学习,学习的范围太小了,而ELMo在学习语言模型的时候是从整个语料库去学习的,而后再通过语言模型生成的词向量就相当于基于整个语料库学习的词向量,更加准确代表一个词的意思。
- ELMo还有一个优势,就是它建立语言模型的时候,可以运用非领域任务的超大语料库去学习,一旦学习好了,可以平行的运用到相似问题,这就是后面bert预训练的搞法,目前NLP的通用训练范式。
Transformer-Attention is all you need
Historical media is unavailable in this archived article. |
原始的transformer是一个encoder-decoder结构,这种结构在NMT任务中验证了成功,之后的很多工作尝试去掉encoder或者decoder,也就是只使用一套堆叠得尽可能多的 transformer 模块,然后使用海量文本、耗费大量的算力进行训练。
Historical media is unavailable in this archived article. |
GPT系列
博客收集:https://blog.csdn.net/yimenren/article/details/122286135
GPT是一系列的模型,目前已经发展到了第三代,这里逐个的说一下
这里有几点要说明
- GPT系列可以看做NLG领域的标杆,主攻文本生成方向,和Google的BERT主攻NLU文本理解方向,可以说统治NLP的两大领域。
- GPT使用的是单向transformer模型结构
- 最近大火的ChatGPT可以看成GPT3的聊天定制版,更小巧,更适合商用。
GPT-1
论文链接:Improving Language Understanding by Generative Pre-Training
代码链接
博客讲解:
https://juejin.cn/post/6949891635735953438
https://www.cnblogs.com/huangyc/p/9860430.html
https://zhuanlan.zhihu.com/p/63115885
承接ELMo,使用transformer结构替代了ELMO中的LSTM结构,构建了新的模型结构,并且给出了一系列的下游任务的用法。一般GPT和Bert会一起提起,这里将二者放在一起说。
| BERT VS GPT | |
|---|---|
Historical media is unavailable in this archived article. |
|
| BERT 预训练:每个token可以看到整个序列 训练任务:MLM+NSP 模型效果:适合NLU语言理解任务 模型结构:Transformer中的encoder部分 | GPT: 预训练:使用transformer结构,只能看到当前token前面的部分,看不到后面,通过MASK实现; 训练任务:LM 模型效果:适合NLG语言生成类任务 模型结构:Transformer中的decoder部分,去掉了cross-attention部分 |
GPT的训练范式是先预训练后微调,和BERT一致。
预训练
在无标注的数据上,GPT通过最大化似然估计来进行模型训练,每个token使用左侧的token进行预测,整个transformer是从左到右的结构。模型包含12层transformer。
finetune
预训练结束之后进行少量数据的finetune,对于每一个输入,经过预训练之后的模型,使用最后一层最有个时间步输出的向量作为下游任务的输入,根据任务设计不同的下游任务head,并计算loss。在finetune的时候也会将预训练的语言模型任务保留下来,当做辅助任务,这样能加速模型收敛和提高模型的通用能力。
Historical media is unavailable in this archived article.
其中
Historical media is unavailable in this archived article.
。不同的下游任务该怎么进行数据设计呢?
Historical media is unavailable in this archived article. |
|---|
| s |
| entailment:文本包含任务,用一个$负号将文本和假设进行拼接,并在拼接后的文本前后加入开始符 start 和结束符end,然后将拼接后的文本直接传入transformer,最后一层+linear+softmax |
| similarity:文本相似度任务,由于相似度不需要考虑两个句子的顺序关系,因此,为了反映这一点,作者将两个句子分别与另一个句子进行拼接,中间用“$”进行隔开,并且前后还是加上起始和结束符,然后分别将拼接后的两个长句子传入Transformer,最后分别得到两个句子的emb,将这两个向量进行元素相加,然后再接如线性层和softmax层。 |
| multiple choice:问答和尝试推理任务,首先将本经信息与问题进行拼接,然后再将拼接后的文本一次与每个答案进行拼接,最后依次传入Transformer模型,最后接一层线性层得到每个输入的预测值 |
GPT-2
论文链接:Language Models are Unsupervised Multitask Learners
代码链接:https://github.com/openai/gpt-2
DEMO链接:https://demo.allennlp.org/next-token-lm
博客链接:
https://zhuanlan.zhihu.com/p/57251615
https://www.cnblogs.com/zhongzhaoxie/p/13064404.html
https://zhuanlan.zhihu.com/p/343922021
核心思想
模型结构上与GPT1相同,GPT-2的核心思想是用无监督的预训练任务模型做有监督的任务,去掉原来的预训练+finetune的二阶段训练范式。GPT2的具体实现方式如下?
- LM语言模型本质上是给序列进行条件概率建模,也就是计算
Historical media is unavailable in this archived article.
- 任何的有监督任务,本质上是在进行估计
Historical media is unavailable in this archived article.
,一般会用特定的网络结构进行任务建模,但是如果要做成通用模型,建模方式要变成Historical media is unavailable in this archived article.
形式。
在NLP中如何将 task建模进去呢?
对于不同的任务可以将输入改成类似的形式
- 翻译任务
Historical media is unavailable in this archived article.
- 问答任务
Historical media is unavailable in this archived article.
- 翻译任务
这样可以使用一个模型进行有监督的多任务学习。
- 语言模型 = 有监督多任务学习,在第二条中,无监督的语言模型对比有监督的多任务学习,语言模型只是不需要显示地定义哪些字段是要预测的输出,所以,有监督的输出可以看成语言模型序列中的一个子集。
有点绕,举个🌰
比如在训练语言模型时,有一句话“The translation of word Machine Learning in chinese is 机器学习”,那在训练完这句话时,语言模型就自然地将翻译任务和任务的输入输出都学到了。再比如,又碰到一句话“美国的总统是特朗普”,这一句话训练完,也就是一个QA任务了。
当然,要想用无监督任务完成有监督的多任务,无监督任务的训练数据是要经过挑选设计的,也就是需要高质量的预训练数据。
和BERT的区别
模型结构的区别
- BERT是双向transformer,可以看到整个序列的信息;
- gpt2是单向transformer,和传统的语言模型一样,一次只输出一个单词,并且只能看到前面的信息;
为什么BERT无法实无监督预训练做有监督多任务呢?
BERT是双向Transformer,建模方式为
Historical media is unavailable in this archived article.
,使用整个序列的所有信息进行建模,这种方式如果套用到有监督多任务上是存在数据泄漏的,所有没办法实现Historical media is unavailable in this archived article.
这种方式建模。GPT2的改动
- 去掉finetune部分,不再针对不同的下游任务进行finetune,全部使用无监督完成,模型会根据输入识别出要做什么任务;
- 增加数据集规模,和筛选得到高质量数据,数据量扩增到40G;
- 增加网络参数,GPT2模型是48层,隐藏层维度1600,参数大约17E,是bert的5倍;
- 调整transformer结构,LN挪到了block且每个attention后面再加一个LN;
- 词表数量增加到50257;
- 最大的上下文从GPT1的512提升到1024;
- batch size增加到512
- 残差层的初始值用
Historical media is unavailable in this archived article.
进行缩放,其中Historical media is unavailable in this archived article.
是残差的个数。
模型效果
| 一共训练4个模型 最大模型参数为17E | Historical media is unavailable in this archived article. |
|---|---|
| 随着模型参数增长,指标提升 | Historical media is unavailable in this archived article. |
GPT-3
论文链接:Language Models are Few-Shot Learners
代码链接:https://github.com/openai/gpt-3
博客链接:
<https://zhuanlan.zhihu.com/p/200978538>
[李宏毅《深度学习人类语言处理》国语课程(2020)](https://www.bilibili.com/video/BV1QE411p7z3/?p=30&share_medium=iphone&share_plat=ios&share_source=COPY&share_tag=s_i×tamp=1594474448&unique_k=yytcW7&vd_source=e8b74628d0beb8e8c369a368ed8a3889)
延续GPT系列的单向transformer结构,模型容量更大175B,训练数据更多45T,GPT3更聚焦通用的NLP模型,和GPT2、T5一个思路,旨在用更少的领域数据,并且不经过微调去解决问题。
出发点
pretrain+finetune的两阶段训练方式,存在如下三个问题,所以有必要并且可以去掉fnetune。
- 对不同的下游任务要准备不同的标注数据,并且这个数据的准备是需要一定的时间和成本的,并且不利于语言模型的应用;
- 下游数据的数据规模相比预训练的数据是非常少的,模型的finetune是去过拟合标注数据的分布,也就是提升模型表征能力的同时降低了数据的分布,这样的模型有过拟合风险。
- 对于人类,不需要大量的标注数据学习就能很好的切换和融合不同的任务,这样的能力语言模型是不具备的。
移除finetune的方法
- meta-learning 元学习,模型在训练阶段具备了一系列模式识别的能力和方法,并通过在预测过程中利用这些能力和方法以快速适应一个下游任务。最近的一些研究尝试通过称为in-context learning的方法来实现上述过程,然而效果距离期待的相差甚远。
- Large scale transformers:Transformer语言模型参数的每一次增大都会让文本理解能力和其他的NLP下游任务的性能得到提升。此外,有研究指出描述许多下游任务性能的log损失能让模型的性能和参数之间服从一个平滑趋势。考虑到in-context learning会将学习到的知识和方法存在模型的参数中,in-context learning也会随着模型参数规模的增长而变强。
什么是in-context learning?
在被给定的几个任务示例或一个任务说明的情况下,模型应该能通过简单预测以补全任务中其他的实例。即,情境学习要求预训练模型要对任务本身进行理解。情境学习三种分类定义和示例如下:
few-shot learning
- 定义:允许输入数条范例和一则任务说明
- 示例:向模型输入“这个任务要求将中文翻译为英文。你好->hello,再见->goodbye,购买->purchase,销售->”,然后要求模型预测下一个输出应该是什么,正确答案应为“sell”。
one-shot learning
- 定义:只允许输入一条范例和一则任务说明
- 示例:向模型输入“这个任务要求将中文翻译为英文。你好->hello,销售->”,然后要求模型预测下一个输出应该是什么,正确答案应为“sell”。
zero-shot learning
- 定义:不允许输入任何范例,只允许输入一则任务说明
- 示例:向模型输入“这个任务要求将中文翻译为英文。销售->”,然后要求模型预测下一个输出应该是什么,正确答案应为“sell”。
Historical media is unavailable in this archived article.
主要贡献
证明了通过增大参数量就能让语言模型显著提高下游任务在Few-shot(仅给定任务说明和少量示例)设置下的性能,即证明了大规模语言模型使用元学习策略的可能和fine-tuning策略的非必要性。
- 训练了包含175B参数(以往非稀疏语言模型的10倍大小)的GPT3自回归语言模型,并在多个数据集上测试没有fine-tune过程的性能表现。
- 虽然GPT3在文本翻译、问答系统、完型填空、新词使用和代数运算等任务表现不错,但在阅读理解和推理任务数据集上的表现仍有待提高,还是不是BERT结构。
- 由于GPT-3的训练依赖于大量的网页语料,所以模型在部分测试数据集上可能出现方法论级别的data containation问题。
- GPT-3能够编写出人类难以区分的新闻文章,论文讨论了该能力的社会影响力。
GPT3.5(davincci001/002/003)
GPT-3.5 系列是在 2021 年第四季度之前的文本代码混合体上训练的一系列模型,包括这些模型:https://platform.openai.com/docs/model-index-for-researchers
- code-davinci-002是一个基础模型,适合于纯代码补全任务
- text-davinci-002 是基于 code-davinci-002 的 InstructGPT 模型
- text-davinci-003 是对 text-davinci-002 的改进
ChatGPT
论文链接:https://openai.com/blog/instruction-following/
代码链接:
博客链接:
<https://openai.com/blog/chatgpt/>

[ChatGPT会取代搜索引擎吗 ](https://zhuanlan.zhihu.com/p/589533490)
经过两年的蛰伏,2022年12月等来了引爆全网的ChatGPT,火爆程度不要于当年的AlphaGo。具体的例子现在已经全网流传,人们目前在广泛讨论ChatGPT对各个行业的冲击,作为搜索算法工程师,个人感觉ChatGPT可能会改变一直以来的搜索方式,由从候选里面选择相关doc变成直接生成用户需要的答案,这是一个颠覆性的变革,当然对于其他领域,例如文字编辑类,创意生成,智能客服等都可能带来冲击。此外本人深切感受到,目前国内的Ai研究相比Google,openai,deepmid存在着很大的差距。此外,这次GPT家族在和bert的竞争中扳回了一局,并且给深度学习续命了最少5年时间,相比AlphaGo下象棋,这次让人们切实看到了Ai的能力。
ChatGPT和GPT3的关系
作为GPT3的继任者,ChatGPT和GPT3的关系如下:
- GPT3是一个通用语言模型,是有史以来最大、最强大的语言模型之一,拥有 1750亿个参数。GPT-3 旨在执行各种语言处理任务,包括语言翻译、摘要和文本生成
- ChatGPT是一种更小、更专业的语言模型,专为聊天应用程序设计。它基于相同的 GPT-3 技术构建,但已经过微调以处理会话语言的特定挑战,例如理解上下文、识别意图和提供适当的响应。与通用语言模型 GPT-3 不同,chatGPT 专注于提供自然且引人入胜的对话体验。
Historical media is unavailable in this archived article. |
Historical media is unavailable in this archived article. |
|---|---|
| from https://zhuanlan.zhihu.com/p/590389451 | from https://arxiv.org/pdf/2203.02155.pdf |
ChatGPT怎么训练的
- 第一阶段:冷启动阶段的监督策略模型。靠GPT3.5本身,尽管它很强,但是它很难理解人类不同类型指令中蕴含的不同意图,也很难判断生成内容是否是高质量的结果。为了让GPT3.5初步具备理解指令中蕴含的意图,首先会从测试用户提交的prompt(就是指令或问题)中随机抽取一批,靠专业的标注人员,给出指定prompt的高质量答案,然后用这些人工标注好的<prompt,answer>数据来Fine-tune GPT 3.5模型。经过这个过程,我们可以认为GPT 3.5初步具备了理解人类prompt中所包含意图,并根据这个意图给出相对高质量回答的能力,但是很明显,仅仅这样做是不够的。
- 第二阶段:训练回报模型(Reward Model,RM)。这个阶段的主要目的是通过人工标注训练数据,来训练回报模型。具体而言,随机抽样一批用户提交的prompt(大部分和第一阶段的相同),使用第一阶段Fine-tune好的冷启动模型,对于每个prompt,由冷启动模型生成K个不同的回答,于是模型产生出了<prompt,answer1>,<prompt,answer2>….<prompt,answerK>数据。之后,标注人员对K个结果按照很多标准(上面提到的相关性、富含信息性、有害信息等诸多标准)综合考虑进行排序,给出K个结果的排名顺序,这就是此阶段人工标注的数据。
接下来,我们准备利用这个排序结果数据来训练回报模型,采取的训练模式其实就是平常经常用到的pair-wise learning to rank。对于K个排序结果,两两组合,形成
Historical media is unavailable in this archived article.
个训练数据对,ChatGPT采取pair-wise loss来训练Reward Model。RM模型接受一个输入<prompt,answer>,给出评价回答质量高低的回报分数Score。对于一对训练数据<answer1,answer2>,我们假设人工排序中answer1排在answer2前面,那么Loss函数则鼓励RM模型对<prompt,answer1>的打分要比<prompt,answer2>的打分要高,常用的margin loss。归纳下:在这个阶段里,首先由冷启动后的监督策略模型为每个prompt产生K个结果,人工根据结果质量由高到低排序,以此作为训练数据,通过pair-wise learning to rank模式来训练回报模型。对于学好的RM模型来说,输入<prompt,answer>,输出结果的质量得分,得分越高说明产生的回答质量越高。
- 采用强化学习来增强预训练模型的能力。本阶段无需人工标注数据,而是利用上一阶段学好的RM模型,靠RM打分结果来更新预训练模型参数。具体而言,首先,从用户提交的prompt里随机采样一批新的命令(指的是和第一第二阶段不同的新的prompt,这个其实是很重要的,对于提升LLM模型理解instruct指令的泛化能力很有帮助),且由冷启动模型来初始化PPO模型的参数。然后,对于随机抽取的prompt,使用PPO模型生成回答answer, 并用上一阶段训练好的RM模型给出answer质量评估的回报分数score,这个回报分数就是RM赋予给整个回答(由单词序列构成)的整体reward。有了单词序列的最终回报,就可以把每个单词看作一个时间步,把reward由后往前依次传递,由此产生的策略梯度可以更新PPO模型参数。这是标准的强化学习过程,目的是训练LLM产生高reward的答案,也即是产生符合RM标准的高质量回答。
BERT
博客链接:
张俊林:从word embedding到Bert <https://zhuanlan.zhihu.com/p/49271699>
按照ELMO->GPT1->BERT的顺序,终于来到了BERT,BERT可以看成是EMMO和GPT1的合成体,特征抽取器采用GPT1相同的Transformer;预训练的时候采用ELMO相同的双向语言模型。它和GPT的训练范式是完全一致的,都是预训练+finetune的方式。
要说的是,BERT和后续的变种是目前NLU的首选,在上面GPT里面对BERT进行了一些说明,这里进行详细的说一下。
预训练:
- 1)MLM任务。就是随便盖住一个单词来预测,使用contex-before和contex-after来预测这个单词,这等价于双向语言模型,MLM是BERT的根本。BERT中MLM的的实现方式选择15%的token,其中的80%替换成MASK,10%替换成一个随机token,10%保持不动。
- 2)NSP 是否是下一句。判断两句是否相连的二分类问题,第二个句子是不是真的是第一个句子的后续句子,增加这个任务有助于下游句子关系判断任务。
网络结构:全连的网络结构(与GPT1比较),每个token能看到整个sequence的信息。
输入向量:词向量,段落(segment)向量与位置(position)向量。与transformer不同的是,这些向量都要模型学习。
输入的格式:输入的格式的变化。增加了[cls]与[sep]。
| 训练范式: stage1: 预训练:NSP+MLM stage2: 下游微调 | Historical media is unavailable in this archived article. |
|---|---|
| 输入格式: token_emb+seg_emb+pos_emb | Historical media is unavailable in this archived article. |
| 下游任务: 左上:句子关系任务 右上:单句子分类,情感分析 左下:阅读理解任务 右下:序列标注任务 | Historical media is unavailable in this archived article. |
BERT为什么有效?
Historical media is unavailable in this archived article. |
对比实验可以看出来,跟GPT相比,双向语言模型起到了最主要的作用,对于那些需要看到下文的任务来说尤其如此。而NSP预测下个句子来说对整体性能来说影响不算太大,跟具体任务关联度比较高。
BERT的意义和评价
BERT是一个里程碑式的工作,是对历史工作的集大成者,在工业界有深远影响,集成了EMLO和GPT的优点,提出了MLM和NSP的预训练任务,并且MLM目前已经是NLP预训练中的一个必选任务。
Bert最大的亮点在于效果好及普适性强,几乎所有NLP任务都可以套用Bert这种两阶段解决思路,而且效果应该会有明显提升。
XL-Net
论文链接:
代码链接:
博客链接:https://zhuanlan.zhihu.com/p/70257427
Bert使用双向语言模型在NLP中取得了巨大的成就,但是Bert的自编码语言模型也有对应的缺点,就是XLNet在文中指出的。
- 预训练阶段因为采取引入[Mask]标记来Mask掉部分单词的训练模式,而Fine-tuning阶段是看不到这种被强行加入的Mask标记的,所以两个阶段存在使用模式不一致的情形,这可能会带来一定的性能损失;
- Bert在第一个预训练阶段,假设句子中多个单词被Mask掉,这些被Mask掉的单词之间没有任何关系,是条件独立的,而有时候这些单词之间是有关系的。
上述两点是XLNet要解决的问题。
Permutation Language Model:context before中引入context after
在Bert中使用双向语言模型+MLM的方式引入context before和after信息,XLNet中通过任务设计在单向语言模型中,将context before中引入context after信息。
XLNet中是怎么引入这个信息的呢?
假如一个句是x1,x2,x3,…,xi,…,xn,xi的选取方式,如何在保持left2right的形式的前提下将xi之后的内容引入到xi的前面呢?在除xi之外中随机选择i-1条数据,将在这部分数据挪到xi前面,将没被选上的数据mask掉。这样在输入的数据形式上还是从左到右的形式,并且将context after的数据挪到了context before中。这里不禁有个疑问,after的信息挪到了before中,before的信息肯定是丢了一些的,并且由于是随机选择,丢失和新增的信息是不可控的。
实现方式:Attention mask来实现,输入的数据形式保持不变,通过使用Attention mask来实现不同的token可以看到的范围。
举例说明,输入原始数据是x1,x2,x3,x4,随机random之后的数据可以看成x3,x2,x4,x1,如果用这个例子用来从左到右训练LM,意味着当预测x2的时候,它只能看到上文x3;当预测x4的时候,只能看到上文x3和x2,以此类推……这样,比如对于x2来说,就看到了下文x3了。这种在输入侧维持表面的x句子单词顺序,但是其实在Transformer内部,看到的已经是被重新排列组合后的顺序,是通过Attention掩码来实现的。
RoBERTa
论文链接:https://arxiv.org/pdf/1907.11692.pdf
代码链接:
博客链接:
可以认为RoBERTa是一个调优的Bert,可以看成Bert优化指南,这些改动对后续的模型研究都有一定的启发,主要的改动有如下。
创新点
- 修改了超参,将adam中的参数beta从0.999改为了0.98;
- 加入了混合精度训练;
- 加大了batchsize,从Bert的256改为2k,训练步数从1M降到500K;
- 去掉了NSP任务,这个任务用处不大;
- BERT的MLM静态MASK改成了动态MASK;
- 在更长的语料上进行训练,包含更多得到语义信息;
- 延长训练时间或者增加训练步数能改善模型效果;
- 增加新的预训练数据,数据规模从16G到64G,能改善模型效果;
- 更大byte-level的BEP词表
MLM Static vs Dynamic
在BERT-MLM中,每个样本复制了10遍,并且进行10次不同的mask,训练40个epoch,这样模型对每个样本见过10次不同方式的mask形式;在RoBERTa中,每个样本在喂进模型的时候进行随机mask,在数据量大或者跑的步数多的时候,这个方式很有效。
| MLM dynamic 对比static在各种验证集上指标均提升 | Historical media is unavailable in this archived article. |
|---|---|
NSP任务的有效性?
在bert中NSP任务判断两句话是不是连续的一句话,正例是从文章中挑选的连续的两句话,负例是从不同的文章中挑选的两句话。在训练数据中50%的句子是连续的话,剩下的50%的句子是负例。为了判断NSP任务是否对模型的效率有所提升,RoBERTa进行了多种实验。
- SEGMENT-PAIR+NSP:传统的Bert的输入和NSP任务,每一对Pair的长度都小于512;
- SENTENCE-PAIR+NSP:输入和Bert相同,每一对Pair的长度远小于512,增大batchsize,使token数与segment-pair基本一致;
- FULL-SENTENCES:不会截断句子,句子的边界可能会跨过Document,不采用NSP Loss
- DOC-SENTENCES:数据和Full-Sentence类似,句子不会超过Document,不采用NSP Loss,调整batch size大小,使token数与full-sentence一致 。
| sentence-pair对比segment-pair:单个句子缺少长距离依赖的学习,下游任务有损; doc-sentence对比segment-pair:去掉NSP后对下游指标有提升 doc-sentence对比full-sentence:动态调整的batchsize对任务有益 | Historical media is unavailable in this archived article. |
|---|---|
总结:NSP对下游任务帮助不大,可以去掉了,在后续的Albert中NSP就被下掉了,并提出了新的SOP任务。
batchsize的影响
更大的batch可以提高模型的训练速度和下游任务的效率?在论文中给出了实验,
| 不同的bsz和step配比,对应的模型见过的数据量是基本一致的,指标上bsz=2k,step=125k的时候表现做好。 bsz增到到8K,指标下降了,这个结论是稳定的吗? | Historical media is unavailable in this archived article. |
|---|---|
XLMR
Facebook的多语种预训练模型,
ALBERT
论文链接:ALBERT: A LITE BERT FOR SELF-SUPERVISED LEARNING OF LANGUAGE REPRESENTATIONS
代码链接:https://github.com/google-research/albert https://github.com/albertlauncher/albert https://github.com/brightmart/albert_zh
博客链接:https://www.zhihu.com/question/347898375
代码链接
Albert可以理解成,成功瘦身并且更健康的bert,参数量变小了,效果变好了。
| Albert的large,xlarge参数量少于Bert-base,效果持平或者更好 Albert-xxlarge对比Bert-large,参数减少30%,指标提升3个点。 | Historical media is unavailable in this archived article. Historical media is unavailable in this archived article. |
|---|---|
创新点
- 缩小了词表的维度,参数略微减少,性能有损;
- transformer内所有参数共享极大降低训练参数,对inference效率没啥影响,减参数不减计算。
- SOP任务,将BERT中NSP进行了升级,将负样本换成了同一篇文章中的两个逆序的句子,消除“topic prediction”,性能提升,NSP算是寿终正寝了;
- segments pair,数据中包含更多长句子,对性能有提升;
- Masked-ngarm-LM,使用ngram替换mlm,更长的句子的mask,提高了任务难度,对性能有提升;
- 模型结构“高瘦”变成“矮胖”,再加上参数共享,性能会得到提升。
减小词表维度的影响
在bert中词表的维度和transformer的隐藏层维度一致的,随着训练词表的规模变大,词表的参数量膨胀明显,此外,我们的预训练是为了训练和强化transformer的能力,并不是为了获得词表的embedding,词表的维度搞太高是意义不大的,所以这里搞了一个矩阵分解,简单说就是词表维度设为A,加一个全连接,转成维度B输入tf,这里A<B,如此降低了embedding的维度。
结合实验指标来看,ALBERT base not shared模型下,E从128降低到64,参数量从89M降到87M,减少了不足2%,指标从81.7降低到81.3。
结论:缩小词表维度,减少了一些模型参数,但是并不多,但是性能下降了。
| Albert中不同的embedding维度对指标和参数量的影响 E从128到64,参数量89->87,效果掉点81.7->81.3 E对参数量影响不大,性能存在掉点线性 | Historical media is unavailable in this archived article. |
|---|---|
TF参数共享的影响-参数变少但掉点
论文中开展了3个对比实验:只对attention共享,只对FFN共享 ,全部参数共享。
结合实验指标,ALBERT base并且E=128的参数下,all-shared对比not shared,参数为12M和89M,权重共享带来了参数量86%的减少,此外,观看指标not shared对比 shared-attention也有32%的参数量减少,并且在指标上并没有掉点的情况,但是这个配置在E=768的时候存在掉点,所以不能作为一个确切的结论。参数缩减的幅度相比于词表维度带来了更多的影响。但是论文中作者还是选择了all-shared这个配置,这个配置下参数下降最多,但是掉点了,作者为了把指标拉上来,将large升级到了xxlarge,进一步加大tf的维度,把参数量又拉上去了,但是还是比bert要小。
结论:参数共享极大减少了参数量,但是掉点,参数共享的时候E变小并没有掉点。
| all-shared相比not-shared参数减少86% shared条件下,E减小并不影响指标 not shared条件小,E减小存在掉点 | Historical media is unavailable in this archived article. |
|---|---|
SOP的影响-涨点
SOP=sentence order prediction,Bert中的NSP任务预测的是第二个句子是否是第一个句子的下一句,负例用的是随机负例,这个任务对模型来说,因为负例太简单了,随机选一个负例的句子,两个句子属于同一个主题语义的可能性很小,模型只需要判断两个句子不是一个主题,大概率就能分对。SOP就是增大难度的NSP,将负样本换成了同一个文章中的两个逆序的句子,这样选择的样本,满足主题语义一致的条件,消除了NSP任务中存在的“topic prediction”情况。
| NSP对比None,有0.2%优势,优势很小 SOP比NSP更靠谱,有1个点优势 | Historical media is unavailable in this archived article. |
|---|---|
通过论文中重点介绍的这3种搞法,模型实际上是掉点的,那么怎么把指标拉上来的呢?这里说的指标是BERT-large对比ALBERT-xxlarge
segment-pairs的影响
| 数据对比: Bert中90%的情况长度为128,10%为512 AlBert中90%的情况长度为512 AlBert有更多的语义训练 | Historical media is unavailable in this archived article. |
|---|---|
| RoBERTa实验结论: 在nsp任务中,更长的文本有更多的语义信息,带来更多指标提升 | Historical media is unavailable in this archived article. |
结论:Albert训练的时候用了更多的语义信息,结合Roberta的结论,更多的语义信息对模型性能提升有帮助。
Msked-Ngram—LM
Bert中MLM是随机选择15%的token,再从里面选择80%进行mask,10%替换 ,10%不变。Albert中用的是n-gram片段,包含更完整的语义信息。
| n-gram最大为3 根据公式1-gram,2-gram,3-gram对应的概率是6/11,3/11,2/11,越长被mask的概率越小,符合常理 | Historical media is unavailable in this archived article. |
|---|---|
此外,根据MacBert中给出的结论:“N-gram mask 在文本分类任务中似乎更有效,而阅读理解任务的性能似乎从相似的单词中受益更多”,from https://www.qin.news/mask/
模型规模和结构
| Albert的large,xlarge参数量少于Bert-base,效果持平或者更好 Albert-xxlarge对比Bert-large,参数减少30%,指标提升3个点。 吞吐速度,bert-large为基准,Albert-xxlarge为0.3,速度慢了3倍 图3所示,同样的训练时间,Albert-xxlarge的指标好于Bert-large 图4所示,在标准任务上,Albert指标最优 | Historical media is unavailable in this archived article. Historical media is unavailable in this archived article. Historical media is unavailable in this archived article. Historical media is unavailable in this archived article. |
|---|---|
- 模型参数和性能上
Albert对比Bert,获得优势的是Albert-xxlarge和Bert-large,参数对比为235M和334M,参数减少了30%,平均指标85.2%提升到88.7%。
- 模型结构上
Bert-large的结构是24层1024维度的,Albert-xxlarge结构是12层4096维度,也就是“瘦高”结构变为了“矮胖”结构
- 运算速度上
对比bert-large,Albert-xxlarge速度变慢了3倍,也就是跑同样的step,Albert需要3倍的时间,这里显然无法说明Albert是一个“Lite”模型,论文中又做了进一步的实验,就是在训练时间差不多的时候,Ablert-xxlarg的性能是88.7%好于Bert-large的87.2。
- 标准1M训练步数表现
在标准的1M训练步数上,Albert指标对比Bert,RoBERTa,XLNet提升,此外,屠榜的是1.5M下的Albert模型。
DeBERTA
BART
是一个seq2seq模型,包含encoder和decoder,encoder是bert,decoder是GPT,双向语言生成模型。
T5:Transfer Text-to-Text Transformer
代码链接:https://github.com/google-research/text-to-text-transfer-transformer
<https://huggingface.co/docs/transformers/model_doc/t5>
博客链接:https://zhuanlan.zhihu.com/p/88438851
结论
- 统一的NLP预训练任务框,都转成text-to-text任务形式,GPT2的提出的路子;
- encoder-decoder的transformer模型结构;
- bert-style形式的任务设计,mask一部分,任务是还原出来
- MLM使用replace span方式, Mask法中相邻 [M] 都合成了一个特殊符,每一小段替换一个特殊符,提高计算效率,SpanBERT也验证过了
- MLM的破坏比例选择15%
- replace span的长度选择3表现最好
ChatGPT
参考文献
blog-https://openai.com/blog/chatgpt/
blog-beit: https://www.qbitai.com/2022/08/37270.html
blog 从 One-Hot 到 ChatGPT -https://juejin.cn/post/7188876269281345594
blog 预训练进展:https://zhuanlan.zhihu.com/p/254821426
blog mask in nlp: https://www.qin.news/mask/
BEIT3
BEIT3可以按照BEIT->BEIT2->VLMO->BEITV3顺序看。在 BEIT3中,就像题目说的那样,把图片当做语言来用。
Historical media is unavailable in this archived article.
在BEIT3中,核心内容有如下几点:
- 提出了一个统一的多模模型框架;适配不同的下游任务
- 借鉴了VLMO的模型设计,共享MHA,使用FFN-Expert的方式
- 将图片当做语言来看,去掉了之前的各种多模任务,只保留了mask modeling任务,这样简化了复杂度,避免了多个Loss之间的权重调参和为了计算各种loss要进行多次forward的问题
- 数据并不是越大越好,数据质量的作用非常重要,比COCA的数据规模少,但是指标要好。
生成模型
DALL.E系列
总结
在深度学习领域,哪些部分会影响模型的效果呢,经过这几年的学习和积累,总结为这几个方向:
- 更高的数据质量,更大的数据规模,已经被多种模型和对比实验反复验证的策略
- 比如T5的数据筛选,ALBEF的动量蒸馏,BLIP的capfit策略
- 这是一个长久并且非常重要的方向,因为随着业务的开展会发现数据才是王道。
- 增大模型的容量和复杂度
- 比如bert larg,T5让模型更深,albert让模型更宽到4096维度
- 在业务中先把模型做的更大更深,拿到更高的性能,然后再进行模型蒸馏,就是这个思路
- 更充分的预训练,Roberta训练的batchsize变大,步数增加
- 这可以看成是一个训练策略了,为了对比模型或策略是否有效,在学术界或工业界一般采用的都是固定的训练配置,这里不过多赘述
- 业务中训练多少步,bsz多大要有对比实验来支撑。
- 有难度或合理的的训练任务
- NLP方向中有albert的sop,Roberta的动态mlm,spanbert的replace span策略
- 多模方向中有ALBEF的ITC、ITM,BEIT的MIM等任务设计
具体到多模态领域,还有一个方向是多模统一框架模型,目前业界的共识是,多模态应该有一个统一的foundation model,它可以cover不同的模态,并能适配不同的下游任务,这个方向是有VLMO,Perceiver-IO,BEIT3。