GAN(Generative Adversary Networks)的思想是是一种二人零和博弈思想(two-player game),博弈双方的利益之和是一个常数,比如两个人掰手腕,假设总的空间是一定的,你的力气大一点,那你就得到的空间多一点,相应的我的空间就少一点,相反我力气大我就得到的多一点,但有一点是确定的就是,我两的总空间是一定的,这就是二人博弈,但是总利益是一定的。
引申到GAN里面就是可以看成,GAN中有两个这样的博弈者,一个人名字是生成模型(G),另一个人名字是判别模型(D)。他们各自有各自的功能。
首先说明什么是生成模型:
密度估计:在事先不了解事件概率分布的情况下,先假设随机分布,然后用过数据观测来确定真实的概率密度,就想极大似然估计。
样本生成:手上存在一个训练样本集,通过训练之后生成类似的样本
对抗生成网络主要是解决生成类型的任务,比如风格迁移任务,将黑白图像生成彩色图像;修复破损的图片,生成超分辨率图像,性别转变,表情转变,发型转变等等。在对抗生成网络中包含生成器和判别器,生成器用于生成任务需要的数据,而判别器用于判断生成的样本是否为真,两个网络使用的是博弈论的思想,一般情况下,我们的目的是得到一个最优的生成器,判别器是用来辅助我们得到该生成器的手段。
生成网络基本原理 生成网络主要针对生成类型的任务,对于最初始的Gan,输入一个噪声,模拟得到一个人的图像,并且希望这个图像足以以假乱真。针对这样的任务,设计一个生成器和一个判别器,使用生成器,输入噪声数据输出一个生成的图像,而判别器用来判断生成的图像是否是一张人像,判别器是一个二分类网络。
通俗理解对抗生成网络就是,判别器会说,我很强,来一个样本我就会知道这个样本是真是假(来源于数据集的数据认为是真的,生成器生成的任务是假的),但是生成器也很不服气,他也认为自己很强,我能生成一个假样本,虽然我知道是真的,但是你判别器判断不出来。Gan的目的就是通过这种博弈的思想得到最优的生成器。
总地来说,Goodfellow 等人提出来的 GAN 是通过对抗过程估计生成模型的新框架。在这种框架下,我们需要同时训练两个模型,即一个能捕获数据分布的生成模型G 和一个能估计数据来源于真实样本概率的判别模型D。生成器G的训练过程是最大化判别器犯错误的概率,即判别器误以为数据是真实样本而不是生成器生成的假样本。因此,这一框架就对应于两个参与者的极小极大博弈(minimax game)。在所有可能的函数G和D中,我们可以求出唯一均衡解,即G可以生成与训练样本相同的分布,而D判断的概率处处为 1/2,无法分辨数据是来源于真实样本还是生成器生成的数据,这一过程的推导与证明将在后文详细解释。
目前对于生成器G和判别器D使用的是神经网络的方式。为了学习到生成器在输入数据x上的分布p G p z ( t ) G ( z ; θ g ) G ( z ; θ g ) D ( s , θ d ) D ( x ) l o g ( 1 − D ( G ( z ) ) )
判别器D会判断数据是否为真实数据的概率,那么我们可以认为数据分为两类,一类是真实样本的数据x G ( x )
假设y ( 0 , 1 ) a C r o s s e n t r o p y ( a ) = − 1 n ∑ [ y l n ( a ) + ( 1 − y ) l n ( 1 − a ) ]
交叉熵表述从极大似然估计而来,表述的是预测值和真实值之间的差距,训练的过程是最小化损失函数的过程。
在生成对抗的网络框架中,对于判别器的训练,可以认为是真实数据的判别结果逼近于1,而生成数据的判别结果逼近于0,由此可以得到V ( G , D ) : = E x ∼ p d a t a ( x ) log ( D ( x ) ) + E z ∼ p z ( z ) log ( 1 − D ( G ( z ) ) ) E p d a t a E P g e n e r a t e x
期望的定义为,对于离散变量E x ∼ P [ f ( x ) ] = ∑ x P ( x ) f ( x ) E x ∼ p [ f ( x ) ] = ∫ p ( x ) f ( x ) d x D G ∗ = argmax D V ( G , D )
当得到最优的判别器之后,来对生成器进行优化,生成器的目的是生成和真实数据相似的样本,相似到让判别器难分真假,对于上面的目标函数最小化,就可以得到最优的生成器。在目标函数V ( G , D ) D ( G ( x ) ) D ( G ( x ) ) G ∗ = a r g m i n G E p d a t a log D ( x ) + E P g e n e r a t e log ( 1 − D ( G ( x ) ) ) min G max D V ( D , G ) = E x ∼ p d a t a ( x ) [ log D ( x ) ] + E z ∼ p z ( z ) [ log ( 1 − D ( G ( z ) ) ) ]
原始GAN详细理论推导 KL散度 引用《深度学习》对KL散度的说明
KL散度是信息论中的概念,定义一个数据的自信息x = x I ( x ) = − log P ( x ) H ( x ) = − E x ∼ P [ log P ( x ) ] D K L ( P ∥ Q ) = E x ∼ P [ log P ( x ) Q ( x ) ] = E x ∼ P [ log P ( x ) − log Q ( x ) ] P ( x ) Q ( x )
KL散度最重要的性质是它是非负的,当且仅当两个分布相等或者非常接近的时候对应的KL散度为0。这个性质可以用来在当做不同分布之间的距离。但是,KL散度不是严格对称的,对于某些P和Q分布存在D − K L ( P ∥ Q ) ≠ D − K L ( Q ∣ ∣ P )
和KL散度关系紧密的量是交叉熵,H ( P , Q ) = − E x ∼ P log Q ( x ) D K L ( P ∥ Q )
KL散度可以从极大似然估计中推导而出。若给定一个样本数据的分布 P d a t a ( x ) P G ( x ; θ ) θ p G ( x ; θ ) P d a t a ( x )
极大似然估计 从极大似然估计的角度来解释对抗生成网络的优化目标。
数据样本的分布为P d a t a ( x ) { 𝑥 1 , 𝑥 2 , … , 𝑥 𝑚 } P G ( x ; θ ) L = ∏ i = 1 m P G ( x i ; θ )
如果生成数据分布P G ( x ; θ ) P d a t a ( x ) m θ θ ∗ = arg max θ ∏ i = 1 m P G ( x i ; θ ) = arg max θ log ∏ i = 1 m P G ( x i ; θ ) = arg max θ ∑ i = 1 m log P G ( x i ; θ ) { x 1 , x 2 , … , x m } from P d a t a ( x ) ≈ arg max θ E x ∼ P d a t a [ log P G ( x ; θ ) ]
上式就是极大似然的过程,将似然函数变为对数似然函数,这样原来似然函数中的连乘就变成了求和。对于期望的计算方式上文已经进行了说明 ,对于离散型随机变量,期望为E ( X ) = ∑ i x i p i p i
因为上述的过程的目的是为了查找最优的参数θ θ ∗ = arg max θ E x ∼ P d a t a [ log P G ( x ; θ ) ] = arg max θ ∫ P d a t a ( x ) log P G ( x ; θ ) d x − ∫ P d a t a ( x ) log P d a t a ( x ) d x = arg min ∫ x P d a t a ( x ) log P G ( x , θ ) P d a t a ( x ) d x = arg min θ K L ( P d a t a ( x ) ∣ ∣ P G ( x ; θ ) ) θ θ K L
求取最优的参数θ P G ( x ; θ ) P d a t a ( x ) θ θ
上述部分就从极大似然估计的角度对优化目标进行了分析,在深度学习领域,很多的优化目标都可以从极大似然估计的角度进行分析得到最终的优化目标。
最优的判别器 正如上文所述,判别器用来判断输入样本的真假,对于最优的判别器应该能够有效的判别出输入的样本为真或为假,我们认为来源于数据样本的数据为真,来源于生成器的生成数据为假。不论是从极大似然估计的角度还是从KL散度的角度,可以得到判别器的优化目标,最大化优化目标对应着判别器对样本分布p G p d a t a
按照原论文所述,价值函数可写成在x V ( G , D ) = ∫ x p data ( x ) log ( D ( x ) ) + p G ( x ) log ( 1 − D ( x ) ) d x p d a t a ( x ) log ( D ( x ) ) + p G ( x ) log ( 1 − D ( x ) ) p d a t a p G ( x ) p data ( x ) log ( D ( x ) ) + p g ( x ) log ( 1 − D ( x ) ) = a ∗ log ( D ( x ) ) + b ∗ log ( 1 − D ( x ) ) a ∗ = p d a t a ( x ) b ∗ = p G ( x )
令式中y = D ( x ) f ( y ) = a ∗ log y + b ∗ log ( 1 − y ) f ( y )
为了找到使得f ( y ) f ( y ) f ′ ( y ) = 0 ⇒ a y − b 1 − y = 0 ⇒ y = a a + b D ( x ) = P d a t a ( x ) P d a t a ( x ) + P G ( x ) p d a t a ( x ) G
最优的生成器 对于对抗生成网络,目的就是得到最优的生成器,用来生成和数据样本数据相似的数据。这就意味着最优的生成器会满足p G ( x ) = p d a t a ( x ) D ( x ) = P d a t a ( x ) P d a t a ( x ) + P G ( x ) = 1 2 1 2 当且仅当p G ( x ) = p d a t a ( x ) V ( G , D )
当p G ( x ) = p d a t a ( x ) V ( G , D ∗ ) p G ( x ) p d a t a ( x )
将上一步得到的最优的判别器带入到优化目标中,进行整理可以得到如下公式条推导V ( G , D ∗ ) = ∫ x p data ( x ) log ( D ( x ) ) + p G ( x ) log ( 1 − D ( x ) ) d x = ∫ x p d a t a ( x ) log ( p data ( x ) p G ( x ) + p data ( x ) ) + p G ( x ) log ( p G ( x ) p G ( x ) + p data ( x ) ) d x = ∫ x ( log 2 − log 2 ) p d a t a ( x ) + p d a t a ( x ) log ( p d a t a ( x ) p G ( x ) + p d a t a ( x ) ) + ( log 2 − log 2 ) p G ( x ) + p G ( x ) log ( p G ( x ) p G ( x ) + p d a t a ( x ) ) d x = − log 2 [ ∫ x P G ( x ) d x + ∫ x p d a t a ( x ) d x ] + ∫ x p d a t a ( x ) [ log 2 + log ( p d a t a ( x ) p G ( x ) + p d a t a ( x ) ) ] d x + ∫ x p G ( x ) [ log 2 + log ( p G ( x ) p G ( x ) + p d a t a ( x ) ) ] d x = − log 2 ( 1 + 1 ) + ∫ x p d a t a ( x ) log ( p d a t a ( x ) [ p G ( x ) + p d a t a ( x ) ] / 2 ) d x + ∫ x p G ( x ) log ( p G ( x ) [ p G ( x ) + p d a t a ( x ) ] / 2 ) d x = − log 4 + K L ( p data ∣ p data + p G 2 ) + K L ( p G ∣ p data + p G 2 )
因为KL散度是非负的,可以得到最优的生成器可以使优化目标取得的全局最优值为− log 4 p G ( x ) = p d a t a ( x ) p G ( x ) = p d a t a ( x )
根据JS散度的定义,可以得到J S D ( P ∥ Q ) = 1 2 K L ( P ∥ M ) + 1 2 K L ( Q ∥ M ) w h e r e M = 1 2 ( P + Q )
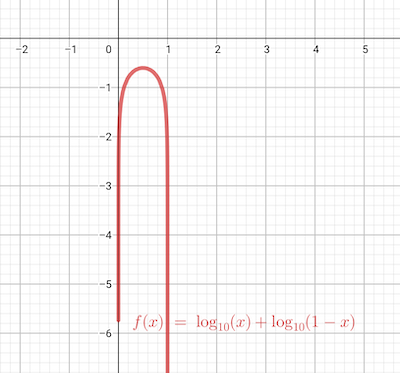
JS散度的值的范围为0 − log 2 log 2
根据JS散度的性质,可以对上述的最优目标进一步优化V ( G , D ∗ ) = − log 4 + K L ( p data ∣ p data + p G 2 ) + K L ( p G ∣ p data + p G 2 ) = − log 4 + 2 J S ( p d a t a ∣ p G ) p G ( x ) = p d a t a ( x ) J S ( p d a t a ∣ p G ) = 0
综上可以得到,当且仅当生成数据分布和数据样本分布相等时,可以得到最优的生成器。
网络训练过程 上述是从理论的角度进行最优生成器和最优判别器的推导,先求出最优判别器,再使用最优判别器计算最优的生成器。优化目标如下V ( G , D ) = E x ∼ p d a t a ( x ) log ( D ( x ) ) + E z ∼ p z ( z ) log ( 1 − D ( G ( z ) ) )
从真实数据p d a t a m { x 1 , x 2 , … , x m }
从先验分布p p r i o r m { z 1 , z 2 , … , z m }
将噪声样本输入生成器G中,生成数据{ x 1 , x 2 , … , x m } , x i = G ( z i ) V = 1 m ∑ i = 1 m log D ( x i ) + 1 m ∑ i = 1 m log ( 1 − D ( x i ) ) θ d θ d ← θ d + η ∇ V ~ ( θ d )
上述为判别器的更新方式,我们希望最大化目标函数
从先验分布p p r i o r m { z 1 , z 2 , … , z ~ m }
通过极小化目标函数V = 1 m ∑ i = 1 m log ( 1 − D ( G ( z i ) ) ) θ g θ g ← θ g − η ∇ V ( θ g )
以上是生成器的训练过程,该过程 在一次迭代中只进行一次更新,可以避免更新太多使JS散度上升。
NOTE :
在进行判别器参数更新时,因为是最大化优化目标,更新方式为 θ d ← θ d + η ∇ V ~ ( θ d ) 在进行生成器参数更新时,因为是最小化优化目标,更新方式为 θ g ← θ g − η ∇ V ~ ( θ g ) 判别器和生成器的更新方式:没对判别器更新一次接着对生成器更新一次,或者多判别器更新k次后对生成器更新一次。
代码说明 代码地址https://github.com/jiqizhixin/ML-Tutorial-Experiment
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 for epoch in range (30 ): print ("Number of batches" , int (X_train.shape[0 ]/BATCH_SIZE)) for index in range (int (X_train.shape[0 ]/BATCH_SIZE)): noise = np.random.uniform(-1 , 1 , size=(BATCH_SIZE, 100 )) image_batch = X_train[index*BATCH_SIZE:(index+1 )*BATCH_SIZE] generated_images = g.predict(noise, verbose=0 ) if index % 100 == 0 : image = combine_images(generated_images) image = image*127.5 +127.5 Image.fromarray(image.astype(np.uint8)).save( "./GAN/" +str (epoch)+"_" +str (index)+".png" ) X = np.concatenate((image_batch, generated_images)) y = [1 ] * BATCH_SIZE + [0 ] * BATCH_SIZE d_loss = d.train_on_batch(X, y) print ("batch %d d_loss : %f" % (index, d_loss)) noise = np.random.uniform(-1 , 1 , (BATCH_SIZE, 100 )) d.trainable = False g_loss = d_on_g.train_on_batch(noise, [1 ] * BATCH_SIZE) d.trainable = True print ("batch %d g_loss : %f" % (index, g_loss)) if index % 100 == 9 : g.save_weights('generator' , True ) d.save_weights('discriminator' , True )
查看上述的代码可以看出,在每个Batch中,选择一个批次的数据和同样数量的噪声数据,认为真实数据标签为1,生成器生成的噪声数据标签为0,使用交叉熵损失来训练判别器;之后固定判别器参数,再次选择一个批次数量的噪声,此时认为生成器生成的噪声数据标签为1,同样通过交叉熵损失来更新生成器参数。由此反复,不断更新判别器和生成器的参数。
再借鉴DCGAN中的代码https://github.com/carpedm20/DCGAN-tensorflow
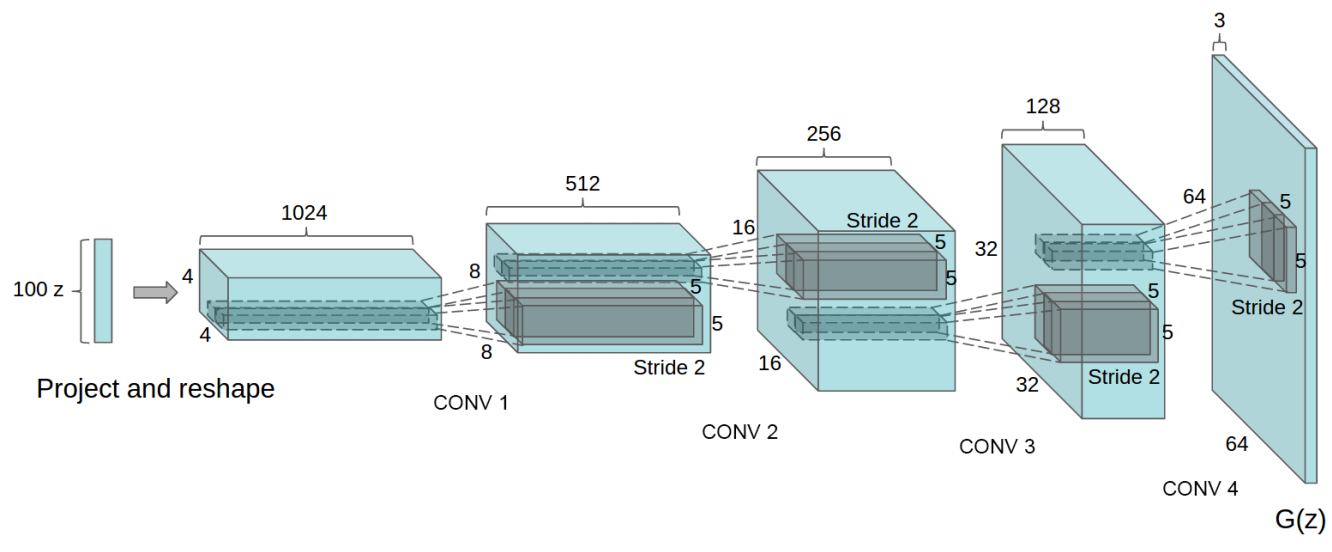
生成网络结构为
G的输入是一个100位的向量z,也就是噪声向量,首先经过全连接层,将100维的向量变成4 × 4 × 1024 64 × 64 × 3
实现细节
不使用池化层,在判别器中使用带有步长的卷积代替池化
在G,D中均使用BN防止过拟合
G中除了最后一层都是用relu激活函数,最后一层使用tanh
D中激活函数都是用Leaky Relu激活函数
如下是判别器的代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
def discriminator (self, image, y=None , reuse=False ): with tf.variable_scope("discriminator" ) as scope: if reuse: scope.reuse_variables() if not self.y_dim: h0 = lrelu(conv2d(image, self.df_dim, name='d_h0_conv' )) h1 = lrelu(self.d_bn1(conv2d(h0, self.df_dim*2 , name='d_h1_conv' ))) h2 = lrelu(self.d_bn2(conv2d(h1, self.df_dim*4 , name='d_h2_conv' ))) h3 = lrelu(self.d_bn3(conv2d(h2, self.df_dim*8 , name='d_h3_conv' ))) h4 = linear(tf.reshape(h3, [self.batch_size, -1 ]), 1 , 'd_h4_lin' ) return tf.nn.sigmoid(h4), h4 else : yb = tf.reshape(y, [self.batch_size, 1 , 1 , self.y_dim]) x = conv_cond_concat(image, yb) h0 = lrelu(conv2d(x, self.c_dim + self.y_dim, name='d_h0_conv' )) h0 = conv_cond_concat(h0, yb) h1 = lrelu(self.d_bn1(conv2d(h0, self.df_dim + self.y_dim, name='d_h1_conv' ))) h1 = tf.reshape(h1, [self.batch_size, -1 ]) h1 = concat([h1, y], 1 ) h2 = lrelu(self.d_bn2(linear(h1, self.dfc_dim, 'd_h2_lin' ))) h2 = concat([h2, y], 1 ) h3 = linear(h2, 1 , 'd_h3_lin' ) return tf.nn.sigmoid(h3), h3
最后一层实现线性连接,将N H W C N , 1
pix2pix 上面部分是对原始的Gan进行了推导和说明,输入的数据是噪声数据,这显然会带来一个问题,给定一个噪声虽然能生成新样本,但是我们无法控制生成的图像的类型 ,以Minist举例,使用噪声数据训练,只能得到类似于Minist相似的数据,但是无法控制具体是实现哪个数字,整个数据的生成过程的是随机的。
NOTE: 对于pix2pix来说,训练时的输入图片和输出图片必须是成对出现的 。
原来的Gan的输入和输出
生成器:输入一个噪声z,输出一个图像G(z)
判别器:输入一个图像x,输出该图像的真实的概率D ( x )
针对上面所述的问题,引入了条件对抗生成网络。
对于cGan的输入输出为:
生成器:输入一个噪声z,一个条件y,输出符合该条件的图像G ( z ∣ y )
判别器:输入一张图像x,一个条件y,输出该图像在该条件下的真实的概率D ( x ∣ y )
Pix2Pix就是这种网络架构。pix2pix可以用来为线稿图上色,表情转换,性别转换等任务。
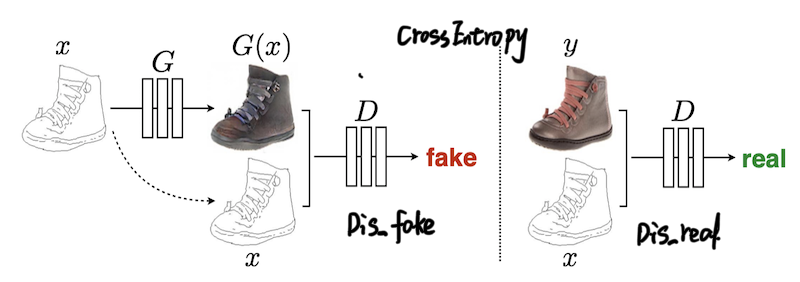
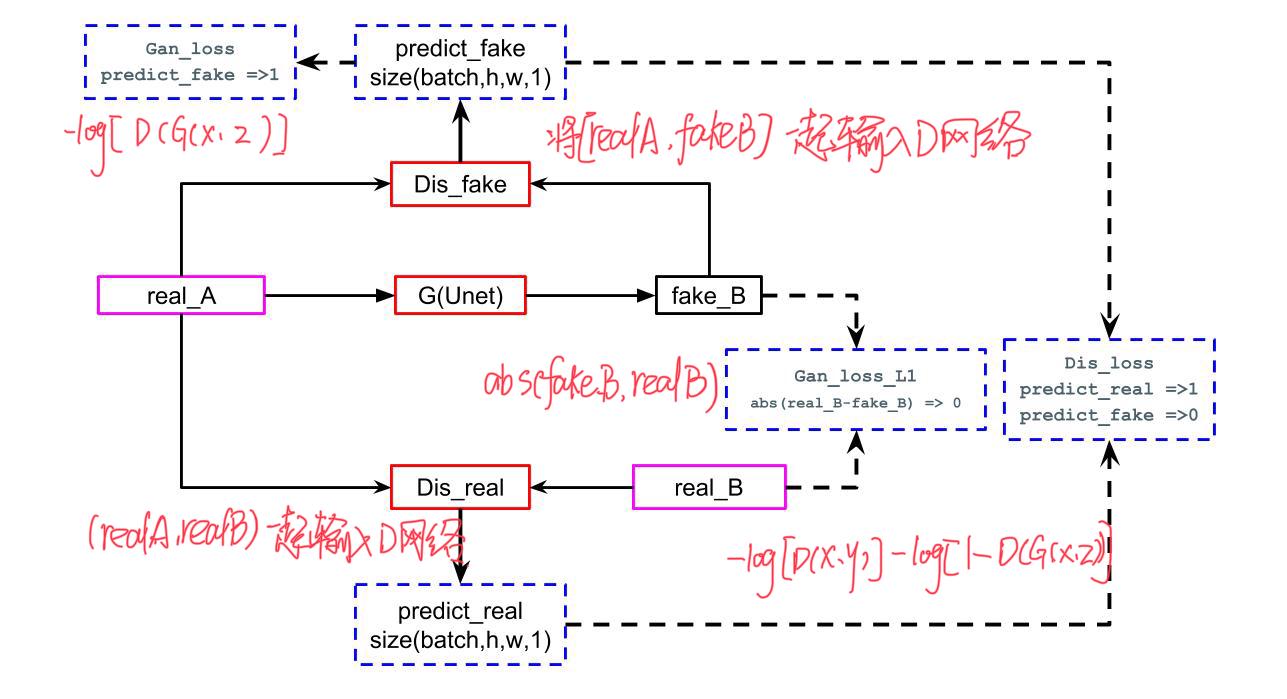
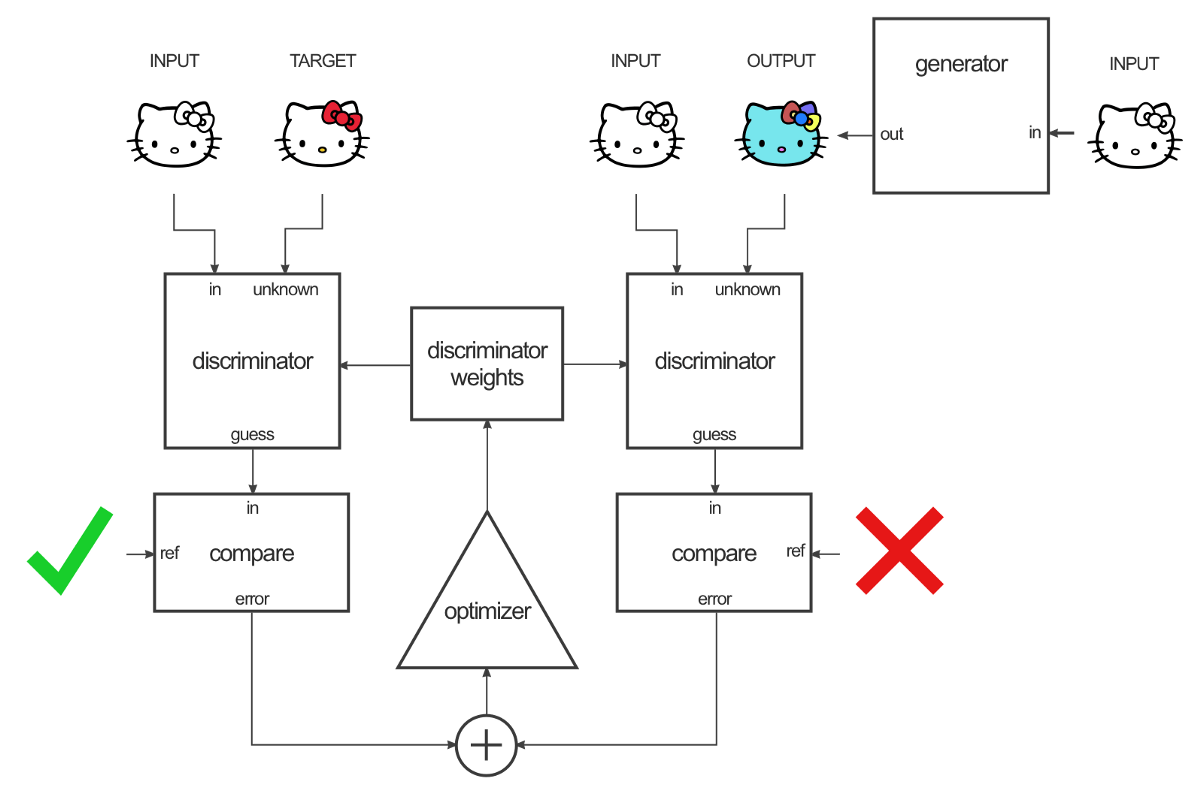
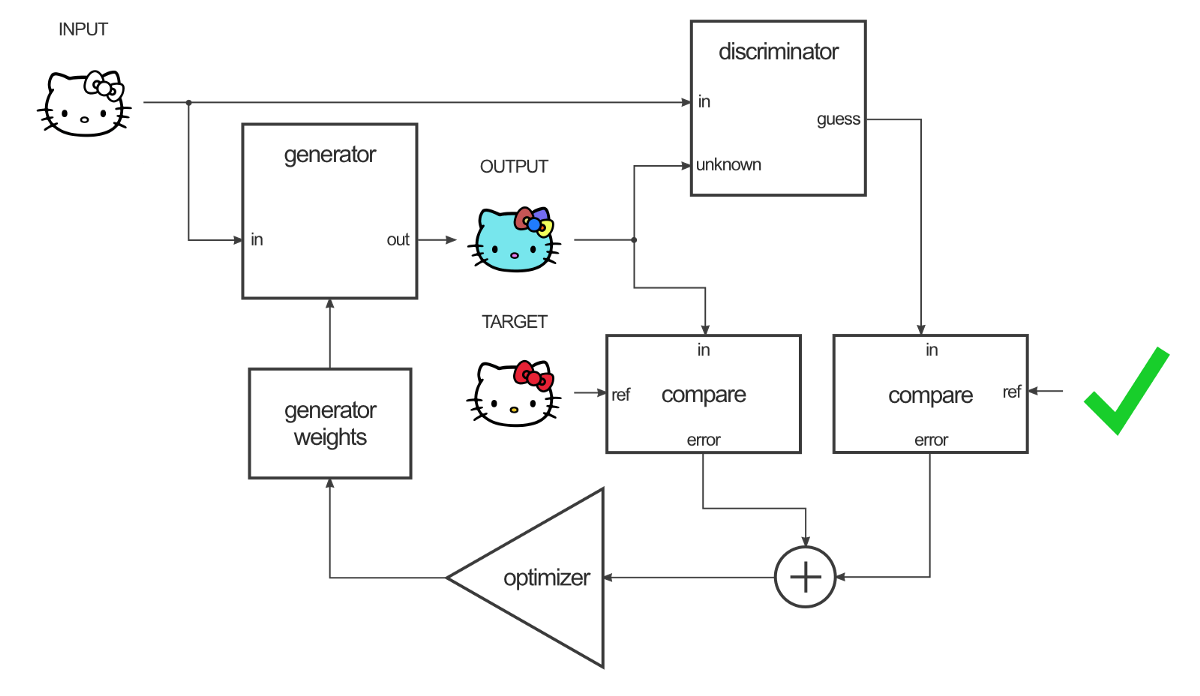
正如图中所示,整个数据集中存在着成对的图像,分别为线稿的形式和上色的形式,线稿图输入生成网络生成假的彩色图,判别器判别该生成数据为假,判别真实的上色图为真来优判别器,使用真实的上色图和生成网络生成的彩色图之间的的差距来优化生成器。
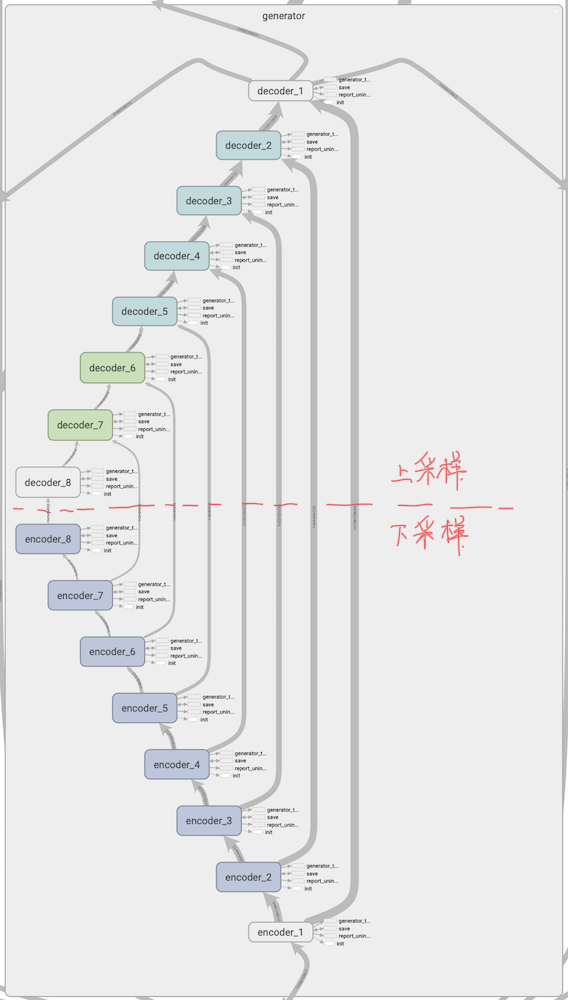
上图为pix2pix在tensorflow训练之后的graphic,可以从整个图中看出整个模型包含一个生成器一个判别器,包含3个损失函数,对上面的图形进行简化,如下图所示。
如上图所示为pix2pix的模型结构,数据集中存储中成对的数据RealA和RealB,也就是上文所述的X,Y类型的图片。生成网络输入生成网络G中生成Fake_B。
对于判别网络
输入RealA和RealB,使判别器认为该类型为真
输入RealA和FakeB,使判别器认为该类型为假
对于生成器,固定判别器参数
输入Real和FakeB,使判别器认为该类型为真
FakeB和RealB之间的L1损失
###优化目标
和传统的使用对抗生成网络不同,对于pix2pix使用了两个优化目标,一个为Gan优化目标L c G A N ( G , D ) = E x , y [ log D ( x , y ) ] + E x , z [ log ( 1 − D ( x , G ( x , z ) ) ] x y z L L 1 ( G ) = E x , y , z [ ∥ y − G ( x , z ) ∥ 1 ]
整个模型的优化目标就是G ∗ = arg min G max D L c G A N ( G , D ) + λ L L 1 ( G )
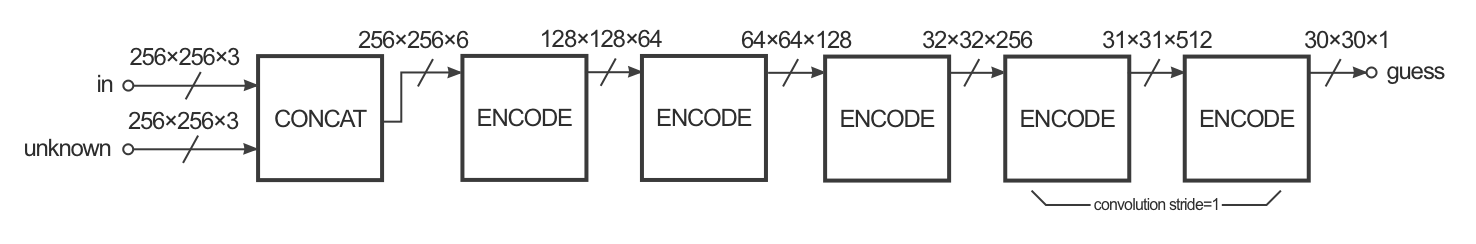
判别器设计 判别器的结构如下所示reference
在判别器设计中,由于是条件对抗生成网络,在判别器阶段输入时是两类图像合并之后的数据,在pix2pix中,进行的将Y类图像转化为X类图像,在判别器中输入的是[ X , Y ] N H W 1 H × W
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
def create_discriminator (discrim_inputs, discrim_targets ): n_layers = 3 layers = [] input = tf.concat([discrim_inputs, discrim_targets], axis=3 ) with tf.variable_scope("layer_1" ): convolved = conv(input , a.ndf, stride=2 ) rectified = lrelu(convolved, 0.2 ) layers.append(rectified) for i in range (n_layers): with tf.variable_scope("layer_%d" % (len (layers) + 1 )): out_channels = a.ndf * min (2 **(i+1 ), 8 ) stride = 1 if i == n_layers - 1 else 2 convolved = conv(layers[-1 ], out_channels, stride=stride) normalized = batchnorm(convolved) rectified = lrelu(normalized, 0.2 ) layers.append(rectified) with tf.variable_scope("layer_%d" % (len (layers) + 1 )): convolved = conv(rectified, out_channels=1 , stride=1 ) output = tf.sigmoid(convolved) layers.append(output) return layers[-1 ] with tf.variable_scope("generator" ) as scope: out_channels = int (targets.get_shape()[-1 ]) outputs = create_generator(inputs, out_channels) """ 使用目标图像创建真实判别器,使用generator生成的创建假判别器 """ with tf.name_scope("real_discriminator" ): with tf.variable_scope("discriminator" ): predict_real = create_discriminator(inputs, targets) with tf.name_scope("fake_discriminator" ): with tf.variable_scope("discriminator" , reuse=True ): predict_fake = create_discriminator(inputs, outputs) with tf.name_scope("discriminator_loss" ): """ 判别器损失,使用类似的交叉熵损失 """ discrim_loss = tf.reduce_mean(-(tf.log(predict_real + EPS) + tf.log(1 - predict_fake + EPS))) with tf.name_scope("generator_loss" ): gen_loss_GAN = tf.reduce_mean(-tf.log(predict_fake + EPS)) gen_loss_L1 = tf.reduce_mean(tf.abs (targets - outputs)) gen_loss = gen_loss_GAN * a.gan_weight + gen_loss_L1 * a.l1_weight
在涉及的模型create_discriminator中,如果输入的target是真实样本集中X类图像,那么判别器判定其为1,如果输入的是生成器生成的图像,那么判别器判定为假。
从代码中可以看到,一共包含3个损失
判别器:使用交叉熵损失
生成器:L1损失和类别损失
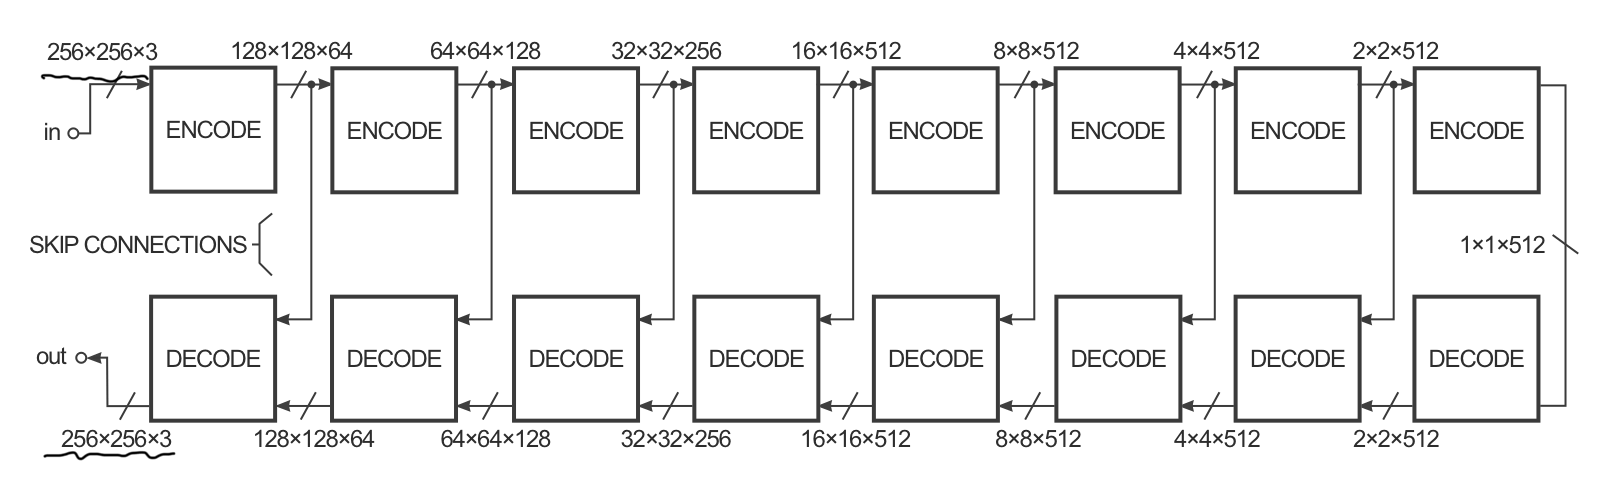
生成器设计 对于生成器的设计,pix2pix使用的是Unet,结构如下图所示
在Unet中,可以从结构图中看到,对于输入的图像,先进行Conv下采样,再TransConv上采样,并且连接上下采样中相同的尺寸。这样能够有效的保留图像的语义信息,并且输入数据的尺寸和输出数据的尺寸相等
Unet最初被提出是用来解决图像分割任务,相关论文可以点击参考文献查看。在对抗生成网络中Unet一般被用来作为生成器。
Tensorflow implement 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 def create_generator (generator_inputs, generator_outputs_channels ): """ 输入为原始图像,首先进行卷积encode,之后进行反卷积decode最终生成与输入图像大小相等的图像 """ layers = [] with tf.variable_scope("encoder_1" ): output = conv(generator_inputs, a.ngf, stride=2 ) layers.append(output) layer_specs = [ a.ngf * 2 , a.ngf * 4 , a.ngf * 8 , a.ngf * 8 , a.ngf * 8 , a.ngf * 8 , a.ngf * 8 , ] """ encode首先使用一层卷积,之后添加7层卷积,一共8层进行encode卷积处理 """ for out_channels in layer_specs: with tf.variable_scope("encoder_%d" % (len (layers) + 1 )): rectified = lrelu(layers[-1 ], 0.2 ) convolved = conv(rectified, out_channels, stride=2 ) output = batchnorm(convolved) layers.append(output) layer_specs = [ (a.ngf * 8 , 0.5 ), (a.ngf * 8 , 0.5 ), (a.ngf * 8 , 0.5 ), (a.ngf * 8 , 0.0 ), (a.ngf * 4 , 0.0 ), (a.ngf * 2 , 0.0 ), (a.ngf, 0.0 ), ] num_encoder_layers = len (layers) for decoder_layer, (out_channels, dropout) in enumerate (layer_specs): skip_layer = num_encoder_layers - decoder_layer - 1 with tf.variable_scope("decoder_%d" % (skip_layer + 1 )): if decoder_layer == 0 : input = layers[-1 ] else : input = tf.concat([layers[-1 ], layers[skip_layer]], axis=3 ) rectified = tf.nn.relu(input ) output = deconv(rectified, out_channels) output = batchnorm(output) if dropout > 0.0 : output = tf.nn.dropout(output, keep_prob=1 - dropout) layers.append(output) with tf.variable_scope("decoder_1" ): input = tf.concat([layers[-1 ], layers[0 ]], axis=3 ) rectified = tf.nn.relu(input ) output = deconv(rectified, generator_outputs_channels) output = tf.tanh(output) layers.append(output) return layers[-1 ]
Keras implement 链接:https://github.com/zhixuhao/unet
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
import osimport skimage.io as ioimport skimage.transform as transimport numpy as npfrom keras.models import *from keras.layers import *from keras.optimizers import *from keras.callbacks import ModelCheckpoint, LearningRateSchedulerfrom keras import backend as kerasdef unet (pretrained_weights = None ,input_size = (256 ,256 ,1 ): inputs = Input(input_size) conv1 = Conv2D(64 , 3 , activation = 'relu' , padding = 'same' , kernel_initializer = 'he_normal' )(inputs) conv1 = Conv2D(64 , 3 , activation = 'relu' , padding = 'same' , kernel_initializer = 'he_normal' )(conv1) pool1 = MaxPooling2D(pool_size=(2 , 2 ))(conv1) conv2 = Conv2D(128 , 3 , activation = 'relu' , padding = 'same' , kernel_initializer = 'he_normal' )(pool1) conv2 = Conv2D(128 , 3 , activation = 'relu' , padding = 'same' , kernel_initializer = 'he_normal' )(conv2) pool2 = MaxPooling2D(pool_size=(2 , 2 ))(conv2) conv3 = Conv2D(256 , 3 , activation = 'relu' , padding = 'same' , kernel_initializer = 'he_normal' )(pool2) conv3 = Conv2D(256 , 3 , activation = 'relu' , padding = 'same' , kernel_initializer = 'he_normal' )(conv3) pool3 = MaxPooling2D(pool_size=(2 , 2 ))(conv3) conv4 = Conv2D(512 , 3 , activation = 'relu' , padding = 'same' , kernel_initializer = 'he_normal' )(pool3) conv4 = Conv2D(512 , 3 , activation = 'relu' , padding = 'same' , kernel_initializer = 'he_normal' )(conv4) drop4 = Dropout(0.5 )(conv4) pool4 = MaxPooling2D(pool_size=(2 , 2 ))(drop4) conv5 = Conv2D(1024 , 3 , activation = 'relu' , padding = 'same' , kernel_initializer = 'he_normal' )(pool4) conv5 = Conv2D(1024 , 3 , activation = 'relu' , padding = 'same' , kernel_initializer = 'he_normal' )(conv5) drop5 = Dropout(0.5 )(conv5) up6 = Conv2D(512 , 2 , activation = 'relu' , padding = 'same' , kernel_initializer = 'he_normal' )(UpSampling2D(size = (2 ,2 ))(drop5)) merge6 = concatenate([drop4,up6], axis = 3 ) conv6 = Conv2D(512 , 3 , activation = 'relu' , padding = 'same' , kernel_initializer = 'he_normal' )(merge6) conv6 = Conv2D(512 , 3 , activation = 'relu' , padding = 'same' , kernel_initializer = 'he_normal' )(conv6) up7 = Conv2D(256 , 2 , activation = 'relu' , padding = 'same' , kernel_initializer = 'he_normal' )(UpSampling2D(size = (2 ,2 ))(conv6)) merge7 = concatenate([conv3,up7], axis = 3 ) conv7 = Conv2D(256 , 3 , activation = 'relu' , padding = 'same' , kernel_initializer = 'he_normal' )(merge7) conv7 = Conv2D(256 , 3 , activation = 'relu' , padding = 'same' , kernel_initializer = 'he_normal' )(conv7) up8 = Conv2D(128 , 2 , activation = 'relu' , padding = 'same' , kernel_initializer = 'he_normal' )(UpSampling2D(size = (2 ,2 ))(conv7)) merge8 = concatenate([conv2,up8], axis = 3 ) conv8 = Conv2D(128 , 3 , activation = 'relu' , padding = 'same' , kernel_initializer = 'he_normal' )(merge8) conv8 = Conv2D(128 , 3 , activation = 'relu' , padding = 'same' , kernel_initializer = 'he_normal' )(conv8) up9 = Conv2D(64 , 2 , activation = 'relu' , padding = 'same' , kernel_initializer = 'he_normal' )(UpSampling2D(size = (2 ,2 ))(conv8)) merge9 = concatenate([conv1,up9], axis = 3 ) conv9 = Conv2D(64 , 3 , activation = 'relu' , padding = 'same' , kernel_initializer = 'he_normal' )(merge9) conv9 = Conv2D(64 , 3 , activation = 'relu' , padding = 'same' , kernel_initializer = 'he_normal' )(conv9) conv9 = Conv2D(2 , 3 , activation = 'relu' , padding = 'same' , kernel_initializer = 'he_normal' )(conv9) conv10 = Conv2D(1 , 1 , activation = 'sigmoid' )(conv9) model = Model(input = inputs, output = conv10) model.compile (optimizer = Adam(lr = 1e-4 ), loss = 'binary_crossentropy' , metrics = ['accuracy' ]) if (pretrained_weights): model.load_weights(pretrained_weights) return model model=unet()
Training 整个pix2pix中包含一个生成器一个判别器,并且数据集图像成对出现,整个训练过程如下
训练判别器,判别器用来分辨输入样本的真假,在pix2pix中判别器的输入是两张图像拼接之后的新的图像,如果使用的都是数据集中的数据,那么判别器会判别为真;如果使用的是数据集的数据和生成器生成的数据,那么判别器会判别为假。
训练生成器,包含了两个损失,一个是对判别器的迷惑,使用判别器生成的数据和数据集中的数据合并,输入判别器,并判断为真;判别器生成的数据和真实的目标数据进行比较,缩小生成器的生成数据和真实目标数据的差异。
CycleGan 顾名思义,CycleGan也是一种条件对抗生成网络,是对pix2pix的改进,在pix2pix模型中,是基于成对的数据类型的,但是在现实中一般没有这么多成对出现的数据,为了改进这个问题,CycleGan应运而生,只需要准备两种类型的数据,而不需要这些数据是成对出现的。
cyclegan可以使用不成对的数据训练处x与y之间的相互映射,比如可以搜集大量的照片和油画,可以实现二者的相会转化。
直接看一下cyclegan的模型结构
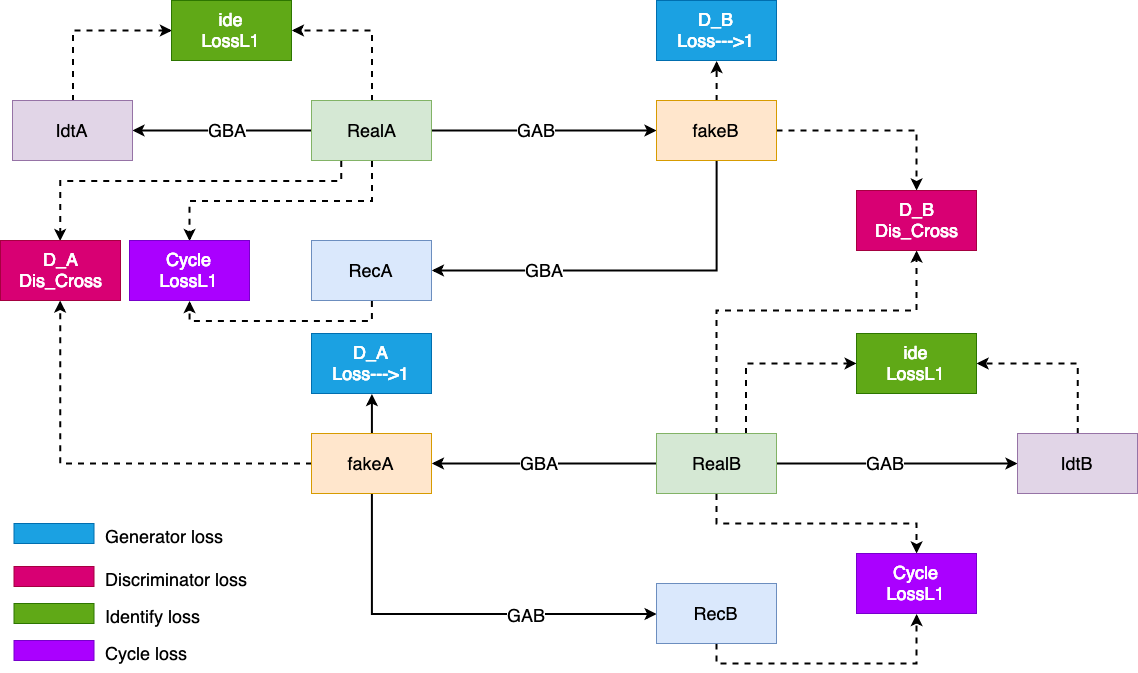
在CycleGan模型中,训练数据集中包含两类图片(realA和realB),我们最终想要的是能够实现对图像类别进行转换。在整个模型中存在两个生成器和两个判别器
生成器
GAB,将类别A图像生成类别B图像
GBA,将类别B图像生成类别A图像
判别器
DB,判别B类图像的真假
DA,判别A类图像的真假
算法的目标是为了学习类别转换的映射函数。GAB将类别A的图像转换为类别B的图像GAB(X),对于生成的图像会使用判别器DB判别其真假,由此构成对抗生成网络,和传统的DCGAN相似,得到优化目标L G A N ( G A B , D B , X , Y ) = E y ∼ p data ( y ) [ log D B ( y ) ] + E x ∼ p data ( x ) [ log ( 1 − D B ( G A B ( x ) ) ] D B G A B
因为提供的数据集中不同类别的数据不是成对出现的,因此只是用这个损失是不可行的,生成器可以将所有输入数据x都映射到目标类的同一张图像,也会使得生成器的优化目标最小,这样显然不可行。 在Cyclegan中提出了循环损失,再设计一个生成器,可以将类别B的图片映射到类别A的图片G B A L c y c ( G A B , G B A ) = E x ∼ p data ( x ) [ ∥ G B A ( G A B ( x ) ) − x ∥ 1 ] + E y ∼ p data ( y ) [ ∥ G A B ( G B A ( y ) ) − y ∥ 1 ] 这样是为了将A类图片通过一个映射函数转换为B类图片之后,应该还可以通过另一个映射函数转换回来。
整个损失包含两个对抗生成损失和一个循环损失。L ( G A B , G B A , D A , D B ) = L G A N ( G A B , D B , X , Y ) + L G A N ( G B A , D A , Y , X ) + λ L c y c ( G A B , G B A ) G A B G B A A G A B G A B G A B L I d e ( G A B , G B A ) = E x ∼ p data ( x ) [ ∥ G B A ( G A B ( x ) ) − x ∥ 1 ] + E y ∼ p data ( y ) [ ∥ G A B ( G B A ( y ) ) − y ∥ 1 ]
Gan训练技巧 输入归一化
对输入的数据进行归一化处理,一般归一化值− 1 , 1
对于生成器,最后一层使用Tanh激活函数,使输出数据压缩至− 1 , 1
损失函数
对于生成器的损失,论文中一般使用min log ( 1 − D )
实际中一般使用max log ( d ( x ) )
噪声数据的采样
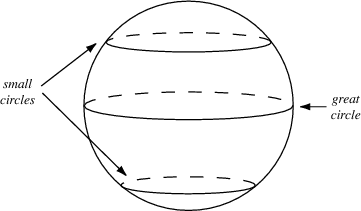
在进行插值操作时,使用大圆上的数据分布进行插值操作,而不是使用小圆的连接直线上进行插值。
Reference