朴素贝叶斯从是基于贝叶斯定理和条件独立性假设的一种分类器,是一种基于概率统计的分类方法。对于给定的数据,基于条件独立性假设学习输入和输出的联合概率分布,然后根据给定的输入数据利用贝叶斯定理求解最大的后验概率的的输出类别,是一种非常常见的分类算法。
对于贝叶斯定理,实际上就是求解条件概率的方法
就是先验概率,是事件A发生之前事件B发生的概率
是后验概率,是事件B发生以后发生事件A的概率,也是条件概率
概率论相关知识
事件A发生的概率
事件B发生的概率
事件AB发生的联合的概率
事件B发生的情况下事件A发生的概率
引入一个例子,我们要进行这样一个任务,输入一个句子,输出该句子属于赌博类句子的概率,只考虑两种情况,输入的句子为赌博或者正常。
P(A) -> A 事件发生的概率,例如明天天晴的概率
P(A|B) -> 条件概率,B 事件发生的前提下 A 事件发生的概率,例如明天天晴而我又没带伞的概率
P(输入句子) -> 这个句子在训练数据中出现的概率
P(赌博) -> 赌博类别的句子在训练数据中出现的概率
P(赌博 | 输入句子) -> 输入句子是赌博类别的概率(也是我们最终要求的值)
P(赌博 | 输入句子) + P(正常 | 输入句子) = 100%
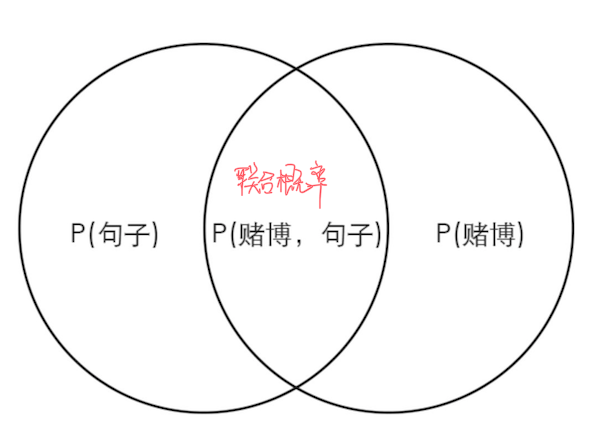
朴素贝叶斯分类器的推导
贝叶斯定理及分类器优化目标
根据条件概率的计算方法,可以得到,由此得到贝叶斯定理公式
带入到例子中,由此可以得到
*P(赌博|输入句子)=P(输入句子|赌博)P(赌博)/P(输入句子)
这就是我们要求的结果,输入一个句子,输出该句子属于赌博的概率。
P(赌博)
赌博类别在整个样本集中的所占的百分比,这是先验概率,直接可以从训练集中得到
P(输入句子)
当前输入的句子出现在整个样本集中的概率。我们最终会想要得到的是输入的句子属于某一类别的概率,在当前的例子中,类别分为两类,赌博和正常。
P(赌博 | 输入句子) = P(输入句子 | 赌博) * P(赌博) / P(输入句子)
P(正常 | 输入句子) = P(输入句子 | 正常) * P(正常) / P(输入句子)
两个例子的分母都是p(输入句子),那么可以认为这一项不会对整个类别预测产生影响,因此在计算的时候是可以省略的。
由此,可以得到*P(赌博|输入句子)=P(输入句子|赌博)P(赌博)
P(输入句子|赌博)
表示的是当前输入的句子属于赌博这一类别的概率,这一项是很难直接从数据集中求解的,因为输入的句子是多变的,不一定会正好出现在数据集中,在预测的时候如果遇到不存在训练集中的数据,那么就会使得P(输入句子|赌博)=0,这显然不是我们想要的结果。
将输入的句子分解成不同的词语来进行联合分析,把当前的输入句子当成不同词语的集合
P(输入句子 | 赌博) = (P(词语 1) * P(词语 2 | 词语 1) * P(词语 3 | 词语 2))| 赌博) ≈ P(词语 1)|P(赌博) * P(词语 2)|P(赌博) * P(词语 3)|P(赌博)
将P(输入句子 | 赌博) 分解成所有 P(词语 | 赌博) 概率的乘积,这里利用了条件独立性假设,用于分类的特征在类别确定的条件下都是条件独立的,公式如下所示:
然后通过训练数据,计算每个词语在不同类别出现的概率。最终获取的是输入句子有效词语在不同类别中的概率。
根据上面结合例子分析可以得到我们要求解的目标为
也就是在输入输入数据为的条件下输出最大概率的类别,称作后验概率,对应着朴素贝叶斯分类器的会将输入数据分类到后验概率最大的类别。
最大化后验概率
根据上面所述,对于朴素贝叶斯算法,优化目标就是最大化后验概率。上面是从贝叶斯定理的角度进行推导得到,实际上也可以从最小期望风险的角度推导得到。
对于分类任务,假设是一个二分类,使用0-1损失函数
对应着决策函数,此时的期望风险就是
为了最小化期望风险,对进行逐个最小化,就可以得到最优的决策函数
如此,最优的决策函数和最大化后验概率是等价的。
贝叶斯估计的参数求解
前文已经对整个过程进行了推导,贝叶斯估计的过程就是最大化后验概率
存在两个需要求解的参数,一个是先验概率
其中对应着决策函数,例如0-1决策
另一个是条件概率,设第j个特征可能取值的集合为,条件概率可以求解
对于贝叶斯分类器,要跟深度学习进行区别,在传统机器学习中,贝叶斯估计,决策树,KNN算法是按照设定的分类策略进行类别的预测,这算是一种基于统计的方法。
贝叶斯估计示例
给定训练集,学习一个朴素贝叶斯分类器输出的类别,数据集如下所示(示例来源《统计学习方法》)
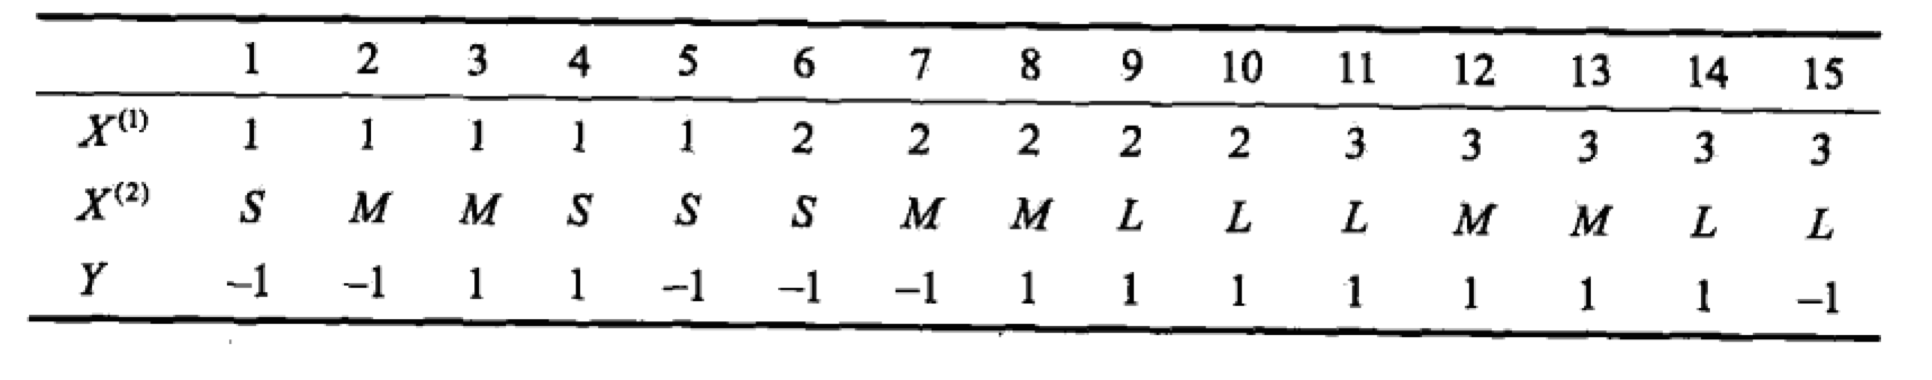
数据集中每一列对应着样本的特征,取值集合分别为,为类别的标记,
根据上述的贝叶斯估计的参数求解过程
根据给定的样例
再结合条件概率的计算公式
结合给定的样例
可以看到对于每一行,概率之和都为1。
按照最大化后验概率
结合给定的样例,给定样本属于的概率
给定样本属于的概率
取最大的后验概率作为当前样本类别的输出,也就是。
朴素贝叶斯处理离散数据
对于朴素贝叶斯,一般处理的是离散数据,就想上述例子所示,或者文本分类中将句子转化成词语,也是离散值。但是如果数据中给定的数据是一种连续值,有两种方法将数据转化为离散值,以便使用朴素贝叶斯分类器。
- 设置阈值范围,将不同范围内的连续值划分为不同的类别
- 使用连续随机变量的概率密度函数,将数值转换为概率
概率密度函数,概率质量函数
概率分布(probability distribution)用来描述随机变量或一簇随机变量在每一个可能取到的状态的可能性大小。描述概率分布的方式取决于随机变量是离散的还是连续的。
概率质量函数
对于离散型随机变量,使用概率质量函数(probability mass function, PMF)来描述,必须满足以下条件
- 函数的定义域必须是随机变量所有可能状态的集合
- 满足条件
- 归一化要求
概率密度函数
对于连续随机变量,使用概率密度函数(probability density function, PDF)来描述,必须满足一下条件
- 函数的定义域必须是随机变量所有可能状态的集合
- 满足条件,并不要求
- 归一化要求
常用分布函数
Bernoulli分布
高斯分布/正态分布
指数分布
用来指示当时概率为零Laplace分布
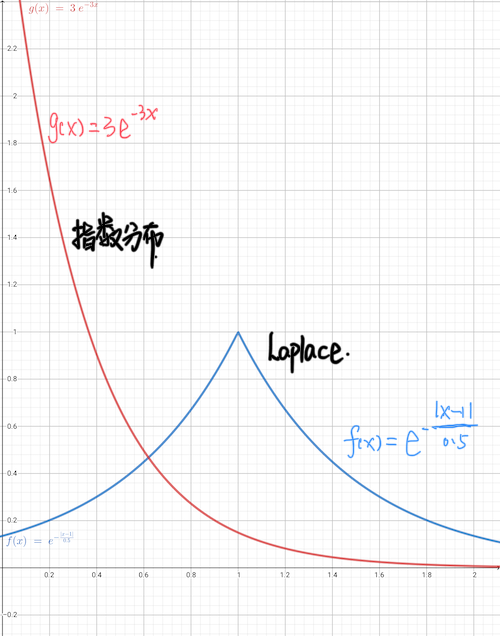
高斯分布
承接上文,如果数据是连续的,那么使用概率密度函数,将数值转换为概率,高斯分布是在自然场景中最常用的分布,比如人的身高,学习成绩排名等等
其中为数据的期望,为数据的标准差。
可以先统计数据数据得到高斯分布的函数的参数,之后将要求解的概率带入概率密度函数中,计算其相对概率。