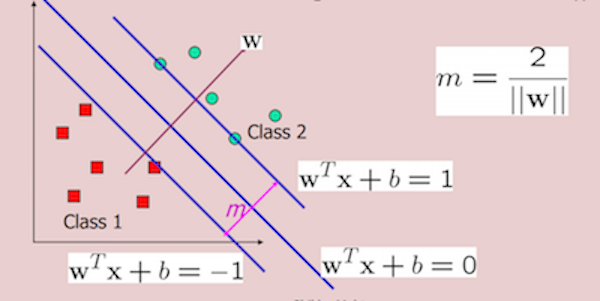
支持向量机是非常高效的一种有监督机器学习算法,是一个二类分类模型,他的基本模型是定义在特征空间上的间隔最大的现行分类器,间隔最大使它有别于感知机;此外核函数的应用,使该算法可以应用有非线性空间。
支持向量机由简入繁主要包含如下几种:
- 线性可分支持向量机
- 线性支持向量机
- 非线性支持向量机
线性可分支持向量机
函数间隔和几何间隔
给定数据集,其中,,,为第个特征向量,为的类标签。学习的目标是在特征空间内找到一个分离超平面,能够将实例分到不同的类,分离超平面对应于方程,它由法向量以及对应的截距构成。分离超平面将整个样本空间划分为两类,一类为正,即,另一类为负,即。训练的过程根据间隔最大化来求得最优分离超平面的过程。
一个点距离分离超平面的距离可以表示该分类预测的确信程度,可以使用表示点距离超平面的远近,此外,与类标记是否一致来表示分类的正确性。因此使用表示分类的正确性及确信度。这就是函数间隔的概念。
函数间隔使用符号存在如下公式
使用函数间隔可以表示实例预测的正确性和确信度,但是会存在一个问题,如果成比例的增加参数和,得到的函数间隔变大了两倍,但是对应的分离超平面没有变化,这是时候需要对参数进行规范化,使得对于一个实例来说其参数是确定的。此时函数间隔便成为几何间隔。
使用符号表示,得到公式
- 其中为的范数
定义超平面关于训练数据集的几何间隔为超平面(w,b)关于所有样本点的几何间隔的最小值,
这也就是对训练集进行训练的过程。
几何间隔和函数间隔的关系
如果存下,则函数间隔和几何间隔相等。
间隔最大化
对训练数据集进行训练的过程实际上就是求得满足几何间距最大化的过程,对于确定的数据集,几何间隔最大化的分离超平面是确定的,此时不仅正负实例被分开,并且距离分离超平面最近的点也具有足够大的确信度将其分开。
得到目标函数和约束条件如下
目标函数为最大化几何间隔,并且满足约束条件,样本即集中所有样本的几何间隔都不小于几何间隔。
参考几何间隔和函数间隔之间存在的关系,可以对目标函数及约束条件进行修正
因为目标函数和约束条件都存在函数间隔,因此函数间隔的取值最优化问题的解,设,至此,得到了线性可分支持向量机的最优化问题
最大分离超平面的存在且唯一性
存在性
样本集中包含正负类样本,也就是说最优解肯定不是,由此可以说明最大分离超平面的存在性
唯一性
比较麻烦。。。,以后有空再来详细证明。
支持向量和间隔边界
所谓支持向量就是满足的实例,也就是说这些实例为最优化问题的约束条件的边界情形。
对于类别为的正点,支持向量在超所在的超平面为
对于类别为的正点,支持向量在超所在的超平面为
对于线性可分的样本集来说,没有实例会落在分离超平面之间,在超平面之间的距离称为间隔,间隔依赖于分离超平面的法向量,等于,两个超平面是间隔边界。
在进行分离超平面计算时,只有支持向量决定。任意线性可分的两组点,它们在SVM分类超平面上的有赢都是线性不可分的。在间隔边界之外的点不会影响最优解的计算,也就是说,分离超平面由支持向量来确定。
对偶算法
之所以使用对偶算法是因为
- 对偶问题更容易求解
- 可以引入核函数进而推广至非线性分类问题
对偶问题的定义
如果存在这样的目标函数和约束条件
得到其拉格朗日函数为
并且有
其对偶问题为
svm优化函数的对偶问题
根据对偶函数的定义可以应用到svm优化函数
将优化函数的目标函数和约束条件创建拉个朗日函数
根据拉格朗日对偶性,得到对偶问题的极大极小问题
也就是先进行极小在进行极大计算
最优问题及其解
有上述的公式可以得到对偶问题的最优化问题
最优问题对应的解就是
决策函数可以写成
线性支持向量机
软间隔
对于线性可分的数据使用线性可分支持向量机可以完成任务,但是对于线性不可分的数据,这时候就要线性可分支持向量机的硬间隔变为软间隔,线性不可分实际上意味着在数据集中存在某些点不能满足函数间隔大于等于1的最优问题约束条件,修改约束条件
同时目标函数修改为
- 其中是惩罚参数,类似于正则化的概念
得到对于线性支持向量机的最优化问题
实际上线性支持向量机是对线性可分支持向量机的扩展,具有更好的适用性。
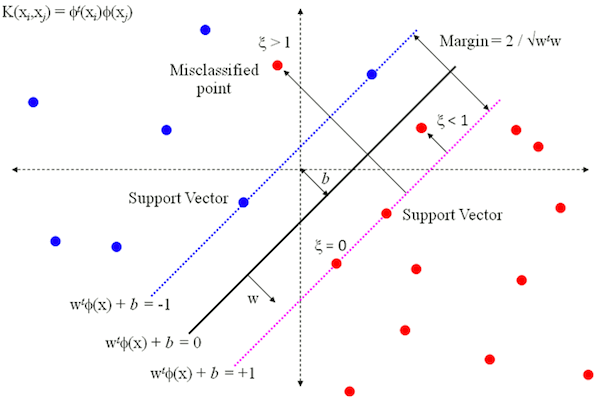
从图中可以看到,分离分离超平面将数据集分为两个部分,由于数据集为线性不可分,因此存在软间隔。数据集中的示例会存在三种情形,及其对应的存在对偶问题解与软间隔的关系如下:
在间隔边界与分离超平面之间
在间隔边界上
在分离超平面误分的一侧
对偶算法
同样是首先得到拉格朗日函数
然后对偶问题的极大极小问题
最优问题及其解
所以极大极小问题进行求偏导并且偏导数为0,则可以得到对偶问题最优解
对应的最优解为
可以看到最优解与线性可分支持向量机相同,只是最优解的约束条件里有原来的 增加了新的约束条件为
线性支持向量机的决策函数可以写成
最优化问题的Hinge损失函数等价形式
Hinge损失函数,主要用于解决间隔最大化的问题,定义如下
那么如何将SVM的损失函数写成Hinge的格式,下面开始。
对应于svm中,存在等式关系
则函数的定义可以写成如下形式
可以写成如下形式
其中存在关系如下
也就是说,当SVM正确分类并且函数间隔时函数损失为0,否则函数损失为
根据上面部分得到的线性支持向量机的原始最优化问题
观察最优化问题,存在约束条件,因此可以令,存在如下关系,当时存在,存在关系式;当时存在同样存在关系式因此当时满足原始最优问题的约束条件。
现在观察最优化问题的目标函数
可以改写成如下形式
至此也就得到了SVM的最优化问题的Hinge损失函数的等价形式。
非线性支持向量机
上面主要是说的线性可分支持向量机和线性支持向量机,在原始数据的向量空间存在分离超平面将数据划分,而算法学习的过程就是找到该分离超平面的过程。但是在实际中,数据绝大部分是非线性的,这时候可以利用核函数的技巧进行原始数据的非线性映射,将原始数据映射到线性可分的高维空间,并在高维空间上利用线性支持向量机的相关算法进行数据划分,在聚类计算中,同样有利用核函数的方法。
对于非线性支持向量机来说,算法的目标就不是找到分离超平面了,而是找到分离超曲面。并且通过核函数的方法对原来的数据空间进行非线性变换,将其转换到线性空间,将非线性问题转换到线性问题。
在原数据空间中,因为是分离超曲面,可以看做分离超平面的形式为
假设给定的数据空间是,样本为,进行线性变换之后的数据空间为,样本为,存在非线性变化
在新的数据空间中,原来的分离超曲面变换为
核函数
假设是输入空间,是特征空间,假设存在一个输入空间到特征空间的映射使得所有的,存在函数满足条件:
- 就是核函数,就是映射函数,表示二者的內积。
核函数的思想:
在学习和预测的时候只定义核函数,并不直接定义映射函数,一般来说直接计算更加简单。此外,核函数通常来讲并不是唯一的。
核函数与支持向量机
在线性支持向量机中,对偶算法最优问题为
其中
将內积使用核函数代替,得到对偶问题为:
对应的决策函数为:
其中参数和为优化问题的解。
观察解题思路,实际上就是非线性数据空间进行核函数映射,将其映射到线性可分的高维空间,在高维空间上,使用线性支持向量的方法进行运算
常用核函数
通常所说的核函数指的是正定核函数
多项式核函数
这是一个一个次多项式,在这种情形下,分类决策函数为高斯核函数
对应的分类决策函数为
SMO-序列最小最优化算法
线性支持向量机的最优化问题为
对应的最优解为
这个问题中,变量是,一个变量对应一个实例,变量的总数与样本集中实例的数量相等为
SMO算法包含两个部分
- 两个变量二次规划的求解方法
- 选择变量的启发式算法
两个变量二次规划的求解方法
先选择两个变量,固定其余的变量,最优化问题变为