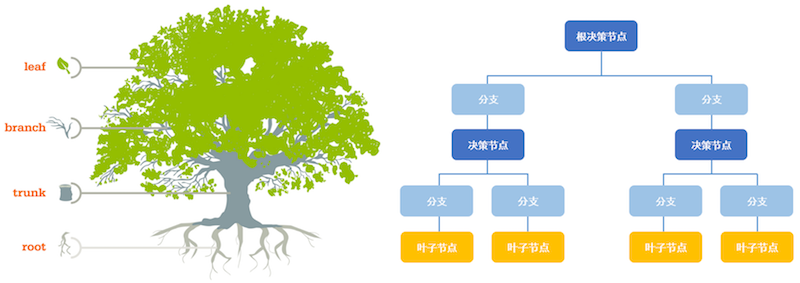
决策树是机器学习中非常容易理解机模型,是最基础最常见的有监督学习模型,被用于分类或者回归,由于树结构与销售、教育、医疗诊断场景决策过程相似,因此在该领域应用广泛。
决策树的生成包括三个部分:特征选择,构造树,树剪枝
决策树算法的特点
1 | 优点:计算复杂度不高,输出结果易于理解,对中间值的缺失不敏感,可以处理不相关特征数据。 |
样例
| 姓名 | 年龄 | 长相 | 工资 | 写代码 | 类别 |
|---|---|---|---|---|---|
| A | 老 | 帅 | 高 | 不会 | 不见 |
| B | 年轻 | 一般 | 中等 | 会 | 见 |
| C | 年轻 | 丑 | 高 | 不会 | 不见 |
| D | 年轻 | 一般 | 高 | 会 | 见 |
| E | 年轻 | 一般 | 低 | 不会 | 不见 |
这是一个典型的是否进行约会的样例,数据中包含A-E五个人,包含年龄,长相,工资,会写代码五个属性,通过这五个属性来确定是否进行约会。整个数据集中包含特征为=[年龄,长相,工资,写代码]=
对于构建决策树过程中的第一步:特征选择,目前存在三种特征选择的启发函数:最大信息增益,信息增益比,基尼指数。接下来的几个计算实例都是使用这个样例。
ID3-最大信息增益
熵
熵是一种信息的度量方式,表示信息的混乱程度,也就是说:信息越有序,信息熵越低。例如:火柴有序放在火柴盒里,熵值很低,相反,熵值很高。假设样本空间D中的的概率分布为:
- 为样本集合D中属于第类标签的样本子集
- 表示该子集的样本个数
- 表示整个样本集的个数
数据集的熵为
- 一定要注意前面的负号
- 表示标签数
- 指数可以使用以位底或以为底
在样例中,包含去见的2人,不去见的为3人,总共为5人,因此可以得到数据集的熵为:
为了决定创建决策树时使用哪个特征,这个时候就要针对不同的特征计算该特征的信息熵,由此引入条件熵,其计算公式为:
- 表示中特征取第个值的样本子集
- 表示中属于第k类的样本子集
- 存在等式关系和
计算的条件熵,包含两个值=[年龄:老, 年龄:年轻],其中年龄老的会见的在整个样本中的人数为1,其中人数0,不见的人数为1;年龄年轻的在整个样本的人数为4,其中会见的人数为2,不见的人数为2。由此分析,求得特征对应的条件熵
由此可以得到所有特征对应的条件熵。
在ID3算法,使用的是启发函数为信息增益,所谓信息增益是针对样本内的特征而言的,对于不同的特征,使用样本集的熵与特征的条件熵的差作为该特征的信息增益。因此信息增益的定义如下
数据集的熵减去特征的条件熵
算法流程
给定样本集以及提取存在的特征
根据整个样本集以及标签计算
根据特征,求解特征对应的条件熵,及信息增益
选择最大的信息增益对应的特征作为当前节点的划分标准
不足
使用增大信息增益作为节点的划分规则,由于信息增益反应的是数据不确定性减小的程度,所以对于取值较多的特征,这就意味着该特征的确定性越高,对应的条件熵也就越低,信息增益越大。因此使用最大信息增益偏向取值较多的特征。
C4.5-信息增益率
为了改进使用最大信息增益偏向取值较多的特征这一个不足,引入了信息增益率。
信息增益率
定义如下
式子中的如下所示
求得信息增益之后,将信息增益与数据集关于特征的取值的熵作比,得到信息增益率。
对于示例,继续条件熵的计算,表示数据集关于年龄这个特征的,对于年龄这个特征,在整个样本空间内有4个年轻的去见,一个年老的不去见,因此该特征的熵为:
取值较多的特征对应的信息增益较大,但是对应的特征的取值的熵也较大,一定程度上对取值较多的特征进行了惩罚和抑制。
C4.5算法流程
1 | 输入:数据集D,特征集A,类别集C,阈值thresh |
CART
CART-classification and regression tree分类回归树
该算法即可用于回归又可以用于分类。构建树时使用特征的取值对样本空间进行二值划分,不仅可以处理离散数据同时可以处理连续数据。
CART分类-Gini指数
与信息熵相似,信息熵描述的是数据的混乱程度,基尼指数描述的是数据的纯度,基尼指数越小,对应的信息纯度越高。分类决策树使用基尼指数进行最优特征的选择,同时决定改特征的最优二值切分点。
Gini定义
分类问题中,假设存在个类,样本点属于的概率为,则概率分布的基尼指数为
对于二分类问题,如果样本属于第1个类的概率为,则概率分布的基尼指数可以表示为
假设存在个类,则数据集的基尼指数为:
公式内的符号定义与熵的公式中的含义相应。
为样本集合中属于第类标签的样本子集的样本数量,是类的个数
特征的指数为:
每次选择指数最小的特征及其对应的切分点进行分类
如果样本根据特征是否取某一可能值被分割成和两部分,则并且则在特征条件的条件下,集合的基尼指数可以定义为:
基尼指数值越大,对应的样本的不确定性越大,与熵相似,因此选择最小的基尼指数作为划分标准。
同样是上面的例子,计算特征对应的基尼指数,当中的特征为年轻时,会将样本集一分为2,一部分为年轻,对应4人;一部分为年老,对应1人,基于此进行该特征值下的基尼指数的计算
同理,可以得到
依次可以得到不同特征值取值下的指数,并选择最小的指数作为特征进行决策树创建。
CART回归-最小平方差损失
给定训练数据集
对于决策树的核心问题是:如何选择划分点?如何决定节点的输出值?
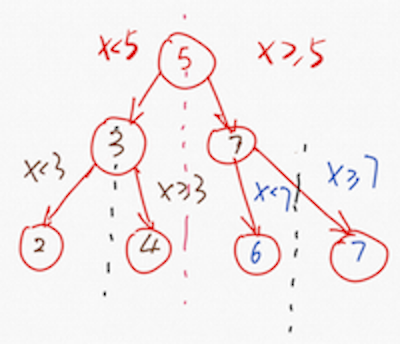
对于上面的分类树使用的是信息论中的评价指标,信息增益,信息增益率,基尼指数;而对于回归树使用的是启发式的方法。假设数据中存在个特征,每个特征有个取值,选择第j个变量和它的取值s作为切分变量和切分点并将整个数据集划分为两个数据空间
如上图所示,每个节点将数据空间划分为两个部分,划分点的选择基于最小平方差损失。遍历所有的特征,并尝试该特征的所有取值对空间进行划分,直到特征j的取值s使的损失函数最小,对于CART回归树使用最小平方差损失,具体的求解方式为
式中的
遍历所有的变量,对固定的切分变量扫描切分点,选择使得上述公式取值最小的
假设输入空间被划分为M个单元,那么每个区域的输出值就是该区域内所有点值的平均值,也就是
总结
| 决策树算法名称 | 算法特点 |
|---|---|
| ID3 | 只用于分类 只处理离散数据 偏向样本较多的特征 泛化能力较差,容易过拟合 对于缺失值比较敏感 节点下生成多叉分支,特征在层间不会复用 通过剪枝权衡数的准确性和泛化能力 |
| C4.5 | 只用于分类 可以处理离散和连续数据 添加取值较多的特征惩罚 泛化能力相较ID3较好 节点下生成多叉分支,特征在层间不会复用 通过剪枝权衡数的准确性和泛化能力 |
| CART | 用于分类和回归 可以处理离散和连续数据 回归使用最小平方差,分类使用最小基尼指数 每个节点产生两个分支,最后形成一个二叉树,特征层间复用 利用全部数据发现所有可能的树结构 |